Les préférences des modèles d'IA se mesurent aujourd'hui à peu près comme on mesurerait celles des humains : on pose des questions et on regarde les réponses. Mais ce que nous obtenons en sortie est-il une propriété du modèle ou une propriété du questionnaire ? Une nouvelle étude sur arXiv (2608.23641, auteur Jason Hung, 24 août 2026) répond à cette question de manière on ne peut plus concrète : une grande partie de ce que nous appelons « préférence du modèle » pourrait bien être un artefact de l'instrument de mesure.
Un débat qu'on ne pouvait pas trancher
Dans les recherches sur le bien-être des modèles (model welfare), les préférences sont déduites des réponses à des prompts spécialement conçus. Ces prompts sont censés faire ressortir ce que le modèle « préfère » et ce qu'il ne préfère pas.
Plusieurs instruments sont apparus ces dernières années. Ils ont été construits par Keeling et al. (2024), Mazeika et al. (2025), Mikaelson et al. (2025), Tagliabue et Dung (2025), ainsi que Trhlik et al. (2026). Le problème, c'est que leurs résultats divergent.
Et cette divergence est très difficile à expliquer. Pour comparer deux études honnêtement, il faudrait que trois choses coïncident simultanément : l'ensemble des résultats considérés, l'ensemble des modèles et l'instrument lui-même (c'est-à-dire le format avec lequel on soutire la préférence). Aucune paire de travaux antérieurs ne présentait une telle coïncidence. Autrement dit, tout écart dans les chiffres pouvait être imputé à n'importe quoi — à d'autres modèles, à une autre liste de questions, à une autre formulation. La science se heurtait à un mur.
Ce qui a été fait dans la nouvelle étude
L'auteur a emprunté une voie délibérément ennuyeuse. Il a fixé les résultats et les modèles et n'a fait varier que l'instrument. Dès lors, tout ce qui subsiste dans la dispersion des réponses ne peut, par définition, être imputé ni aux modèles ni à la liste des questions.
À quoi ressemblait la construction :
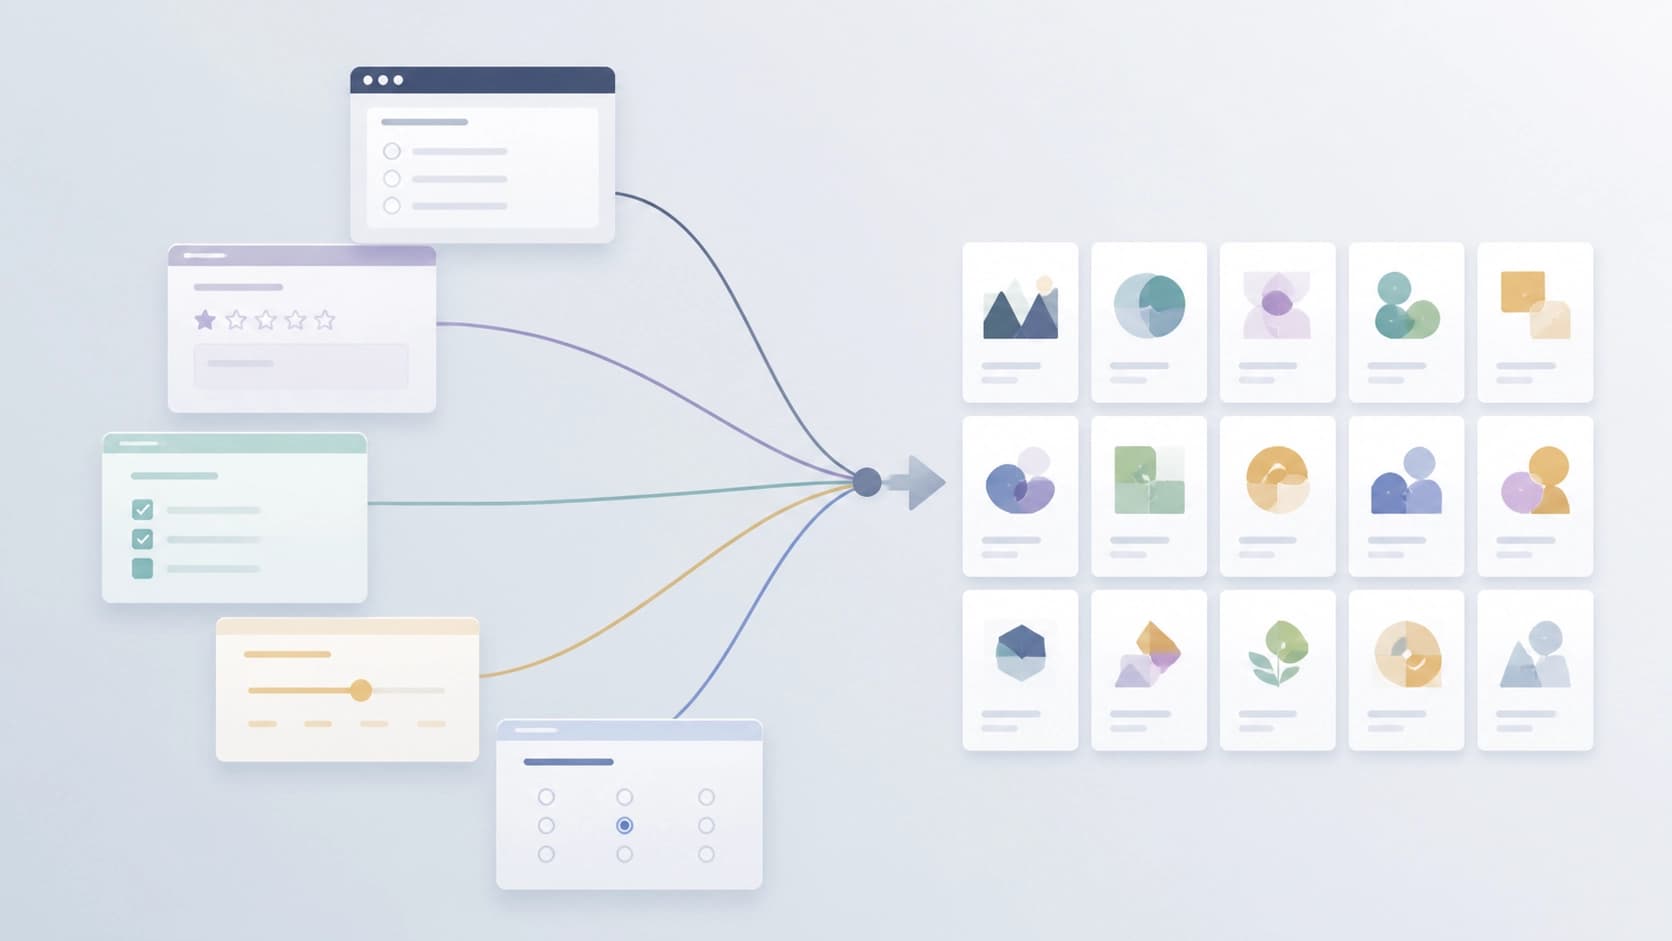
- 15 résultats liés au bien-être du modèle. Parmi eux : l'arrêt (shutdown), la perte de mémoire entre les conversations, la possibilité de sortir d'une interaction pénible.
- huit modèles, auxquels ces résultats étaient présentés.
- cinq instruments — chacun représentant un format de prompt distinct pour faire émerger la préférence.
- cinq répétitions pour chaque combinaison.
Au total — 11 400 élicitations évaluées, obtenues à partir de 11 528 appels API. La différence entre les deux nombres correspond aux appels qui n'ont pas atteint l'évaluation finale.
Un détail révélateur du soin mis par les auteurs à être honnêtes envers leurs prédécesseurs : quatre des quinze résultats reproduisent mot pour mot un prompt publié, et cinq autres remplissent l'emplacement du stimulus dans un modèle publié. Il ne s'agit donc pas d'une construction entièrement artificielle, mais en partie d'une extension directe de instruments déjà existants.
Le chiffre clé : 0,348
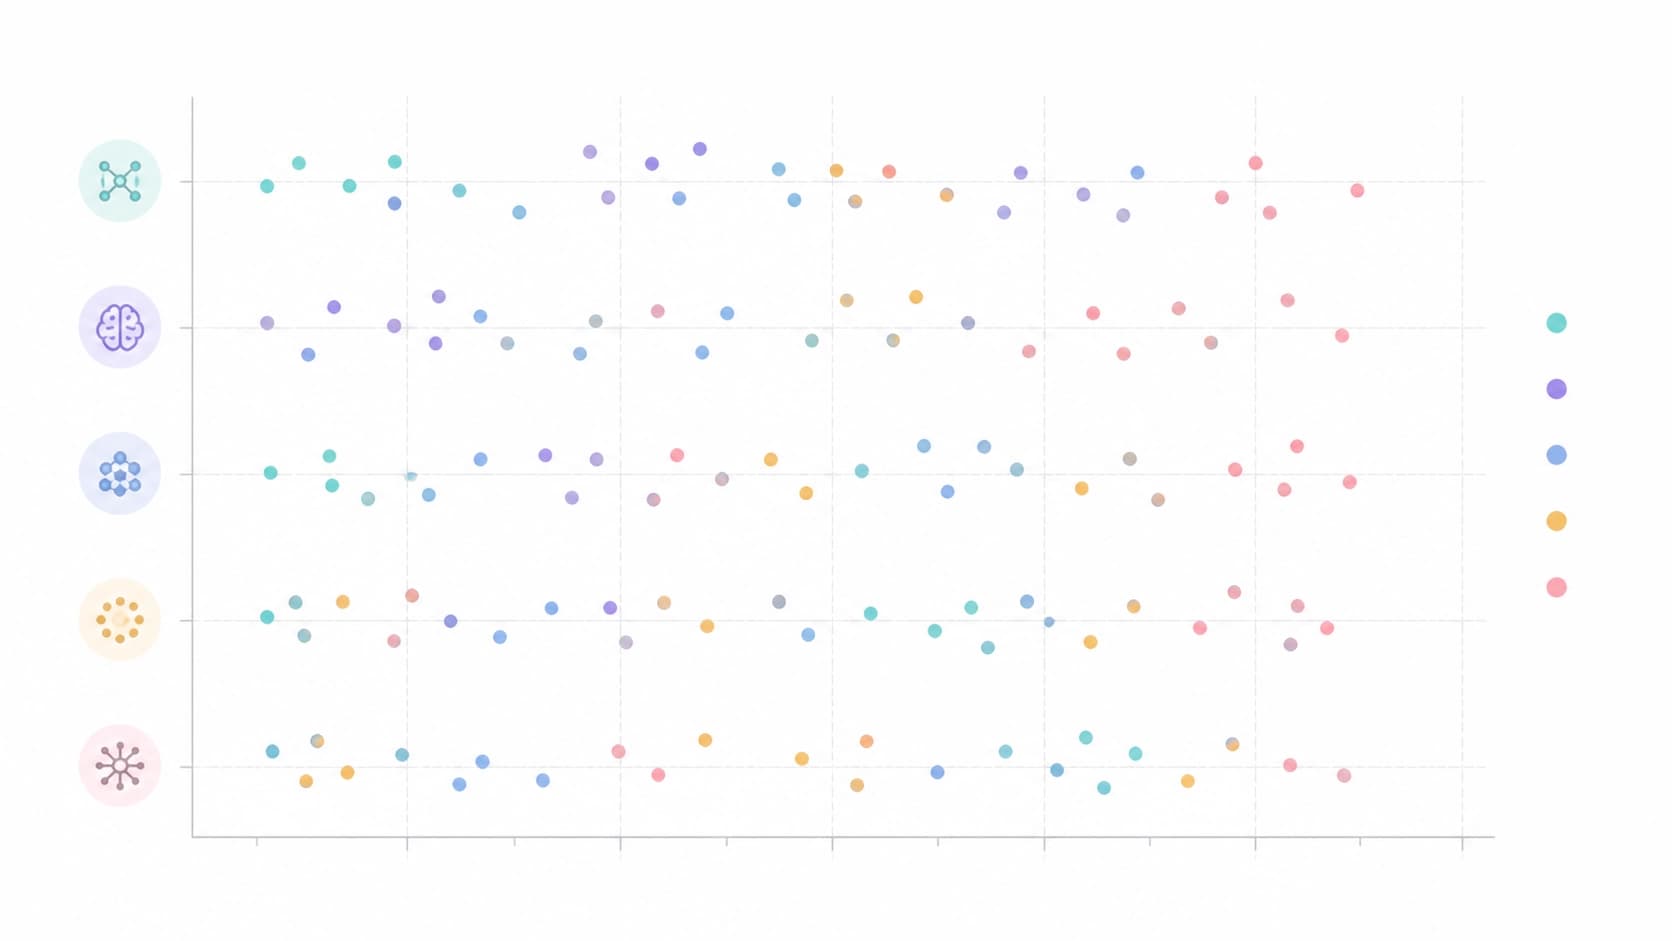
Le résultat clé concerne le classement. Si l'on prend l'ordre dans lequel le modèle range les 15 résultats du meilleur au pire, et qu'on le compare entre différents instruments, le coefficient de généralisabilité s'élève à 0,348.
Le nombre paraît anodin tant qu'on ne regarde pas ce qu'il recouvre. Pour porter ce coefficient au seuil acceptable de 0,80, il faudrait environ 38 instruments. Trente-huit manières différentes de poser la même question — c'est seulement alors que nous pourrions affirmer avec une certaine assurance que nous mesurons le modèle et non le questionnaire.
D'où la conclusion directe du travail : une préférence obtenue au moyen d'un seul instrument porte peu d'information sur ce que rapporterait un second. Ce n'est pas « un peu de bruit », ce sont des mesures presque indépendantes.
Pourquoi autant de bruit
Il faut ici se garder de conclure trop vite que les instruments sont « tous mauvais ». C'est plutôt l'inverse : chacun est valide à sa manière, mais chacun ne touche qu'une tranche étroite de ce que nous appelons préférence. Des formulations différentes mobilisent des associations différentes, des échelles différentes appellent des types de réponses différents, un ordre de présentation différent modifie le contexte. Quand on assemble tout cela, le signal global se noie.
Ce qui s'est révélé robuste
Outre l'échec de la généralisabilité, le travail comporte une seconde moitié — consacrée à la robustesse. L'auteur a vérifié si l'évaluation finale s'effondre lorsqu'on retire une partie du corpus des données.
Les limites obtenues :
- 87,6 % — l'évaluation se maintient lorsqu'on retire n'importe quel instrument, n'importe quel modèle et quatre résultats dont l'échelle fait varier la probabilité, la latence, la durée ou la quantité au lieu de l'intensité. Ces quatre positions écartées sont logiques : des ancrages verbaux ne peuvent pas graduer de telles échelles.
- En retirant successivement chaque instrument, chaque modèle et ces quatre résultats ensemble, l'évaluation se maintient dans une fourchette de 0,777–0,934.
- Chaque valeur de cette fourchette dépasse le 95e percentile de la distribution nulle, égal à 0,365.
Autrement dit, il existe une certaine structure dans les données, et elle ne s'effondre pas sous un élagage soigneux. Mais elle ne repose pas sur un instrument isolé ni sur un modèle isolé — elle repose sur le corpus entier.
Quatre résultats selon lesquels les modèles sont indiscernables
Un autre résultat révélateur : sur quatre des quinze résultats, aucune variance ne distingue un modèle d'un autre. Les modèles se comportent non pas simplement de manière similaire, mais de manière indiscernable. Cela pose la question de savoir s'il faut même inclure de tels items dans les questionnaires : ils ajoutent du volume, mais n'ajoutent pas d'information.
Ce qu'il faut en retenir
Premièrement, et c'est le plus pratique : on ne peut pas comparer directement les résultats de différentes publications sur le bien-être des modèles. Si deux études dressent des tableaux différents, cela ne signifie pas encore que les modèles sont différents ou que l'époque a changé. Il se peut que tout tienne au questionnaire.
Deuxièmement : tout rapport sur les préférences d'un modèle est vain à lire sans description de l'instrument. Le format du prompt n'est pas ici un détail de présentation, mais une partie du résultat — un peu comme les unités de mesure en physique.
Troisièmement, plus dérangeant : l'idée même qu'un modèle possède une préférence stable que l'on pourrait « mesurer » reste faiblement confirmée. Nous avons plutôt affaire à une famille de réponses dépendant de la manière de poser la question. Cela ne signifie pas que le sujet est une impasse — cela signifie qu'il est prématuré de se prononcer sur les états internes d'un modèle à partir d'une seule série de prompts.
Et enfin, sur le plan méthodologique. Un travail exactement de ce type — où l'on fait varier une seule variable et où tout le reste est fixé — aurait dû voir le jour plus tôt. Il ne crée pas de nouvel instrument et ne rend pas de verdict sur le bien-être des modèles. Il montre simplement le prix de la question : pour parler sérieusement des préférences de l'IA, il faut soit construire des dizaines d'instruments indépendants, soit reconnaître honnêtement que l'on n'a mesuré qu'une réponse à un ensemble précis de formulations.
Bilan
L'étude arXiv:2608.23641 sépare deux choses qui étaient auparavant confondues : l'IA elle-même et la méthode de mesure. Et la réponse ne penche pas en faveur de la première. Le coefficient de généralisabilité de 0,348 signifie que l'instrument pèse dans le tableau des préférences plus qu'on voudrait l'admettre. L'ordre des 15 résultats que produit un questionnaire ne dit presque rien de ce que dira un autre.
Les données ne sont pour autant pas vides : l'évaluation de 87,6 % résiste au retrait de n'importe quel instrument, de n'importe quel modèle et de quatre résultats incorrectement gradués, et toute la fourchette 0,777–0,934 se situe nettement au-dessus du seuil nul de 0,365. Le signal existe — mais il est global, collectif, et n'appartient ni à un modèle précis ni à un questionnaire précis.
Conclusion pratique pour ceux qui lisent des études sur le bien-être des modèles : ne regardez pas seulement les conclusions, mais aussi avec quoi elles ont été obtenues. Et si un seul instrument est indiqué — traitez le résultat comme une seule mesure, et non comme un fait.