
RBS-Attention : accélération du préremplissage des longs prompts par la recherche de blocs sous-estimés
L’article présente une méthode qui complète la sélection de blocs fondée sur la similarité moyenne en recherchant des candidats susceptibles de masquer des tokens importants. Avec un contexte de 128K, les auteurs rapportent une accélération de l’attention en préremplissage allant jusqu’à 20,65 fois ; sur Qwen3-32B, le score RULER atteint 88,65, contre 89,52 pour l’attention dense.
Quelle partie de l’inférence la méthode accélère
Le préremplissage traite le prompt avant le début de la génération. Le self-attention dense s’applique à l’ensemble de l’entrée ; un contexte long augmente donc la charge de calcul de cette étape.
RBS-Attention sélectionne de manière clairsemée les blocs pour le préremplissage et peut réduire les coûts de calcul. Mais le centroïde d’un bloc moyenne la pertinence des tokens et peut masquer un token important parmi des tokens non pertinents. Les auteurs appellent cette défaillance mean dilution.
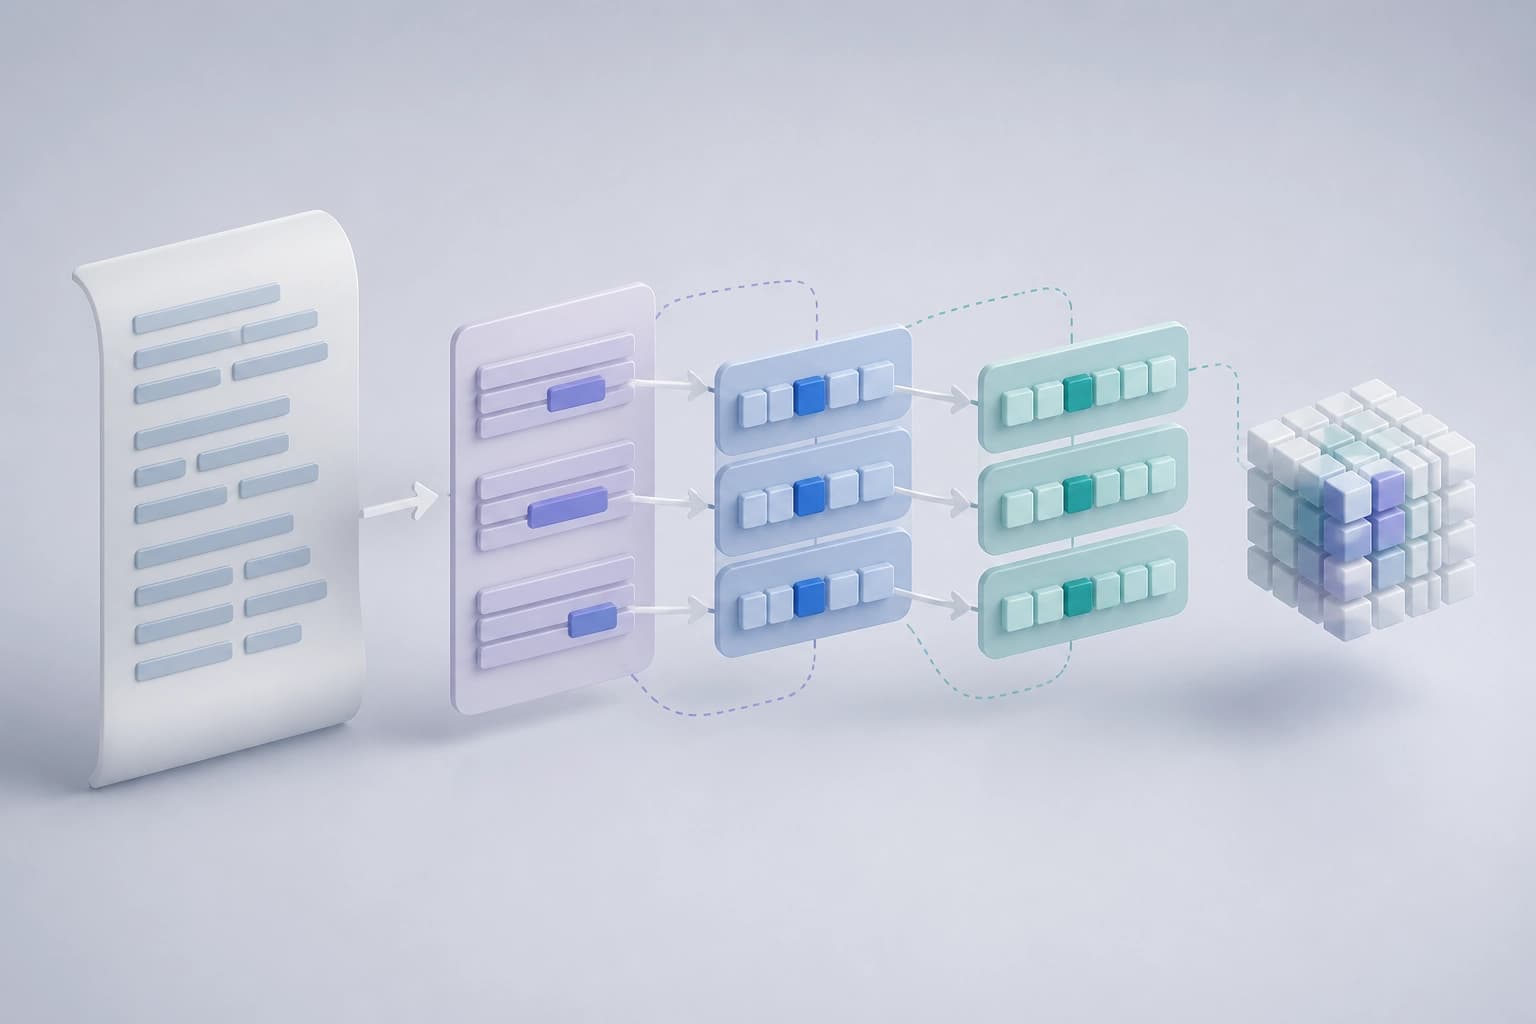
En pratique, la méthode vise à accélérer le préremplissage sans se fier uniquement à la pertinence moyenne d’un bloc entier.
Comment s’effectue la sélection des blocs
La méthode ne nécessite pas d’entraînement et utilise deux branches complémentaires :
- Branche de base : elle évalue la pertinence moyenne du bloc à l’aide du centroïde.
- Branche de récupération : elle tient compte du rayon maximal du bloc de clés et de sa distribution, qui dépend du prompt, de la couche et de la tête. Elle détecte ainsi les blocs dont la pertinence pourrait être sous-estimée.
Chaque branche applique séparément un seuil à sa sélection. La méthode combine ensuite les masques et contrôle la contribution des blocs de récupération. L’exécution reste assurée par FlashAttention régulier à blocs clairsemés.
Cette architecture convient aux scénarios où la sélection par centroïde risque de passer à côté de certains tokens pertinents, tout en permettant de conserver une exécution à blocs clairsemés.
Quels résultats de vitesse sont présentés
Les mesures ont été réalisées sur H100 avec un contexte de 128K. Pour Qwen3-30B-A3B-Instruct-2507-FP8, l’article indique les accélérations suivantes :
| Étape | Accélération |
|---|---|
| Attention de préremplissage autonome | 20.65× |
| Attention de préremplissage dans vLLM | 11.92× |
| Délai total jusqu’au premier token | 5.97× |
Ces résultats concernent une configuration précise. Il convient de les considérer séparément de l’évaluation de la qualité et de ne pas les extrapoler à d’autres modèles sans mesures correspondantes.
Que sait-on de la qualité et des évaluations
Sur le modèle dense Qwen3-32B, la précision globale de RULER était de 88.65. Pour l’attention dense, la valeur indiquée est de 89.52.
Des évaluations supplémentaires de la qualité ont été menées sur LongBench-v2, InfiniteBench et Video-MME. Des expériences complémentaires ont mesuré la conservation des données pertinentes, comparé les sélecteurs à densité égale et testé différentes tailles de blocs, différents seuils et différents volumes de mémoire.
Pour choisir une méthode, il convient d’évaluer séparément la vitesse et la qualité : les résultats RULER présentés ne remplacent pas une vérification sur les tâches importantes pour l’application concernée.
Foire aux questions
Matériaux connexes
Tous matériaux
Toollery : sélection d’outils pour agents LLM parmi des dizaines de milliers d’options sans réentraînement
Toollery construit un index de recherche à partir des descriptions des compétences et des outils, puis ne transmet au modèle qu’un nombre limité de candidats pour chaque requête. Lors d’expériences menées sur des bibliothèques comptant jusqu’à plusieurs dizaines de milliers de fonctions, cette approche permet de maintenir la qualité de sélection avec un top-K fixe, même si l’effet final dépend du profil de charge et de la mise en cache côté fournisseur.
11 novembre 2026
Diagnostic étape par étape des agents GUI lors de l’analyse de tableaux de bord : benchmark DashAct
Découvrez DashAct, un benchmark de 348 trajectoires vérifiées par des humains, qui décompose le travail des agents GUI avec des panneaux interactifs en trois étapes et quatre conditions visuelles. Les résultats révèlent des difficultés persistantes à prédire les actions et à les ancrer sur des cibles visuelles, ainsi que la dépendance des réactions des agents à l’égard du soutien contextuel et spatial.
11 novembre 2026
WILSON : regroupement des grossissements et des lames du patient pour l’analyse pathomorphologique et la rédaction de comptes rendus
La prépublication présente WILSON, un modèle vision-langage qui encode des images de lames entières ainsi que des séries de prélèvements d’un même patient à différents grossissements, plutôt qu’une seule lame « optimale ». Sans entraînement supplémentaire pour une tâche donnée, il surpasse des modèles spécialisés et de plus grande taille dans plusieurs métriques, tout en nécessitant beaucoup moins de ressources de calcul, et ses descriptions diagnostiques ont obtenu de meilleures évaluations de la part des pathologistes.
11 novembre 2026