
Diagnostic étape par étape des agents GUI lors de l’analyse de tableaux de bord : benchmark DashAct
Découvrez DashAct, un benchmark de 348 trajectoires vérifiées par des humains, qui décompose le travail des agents GUI avec des panneaux interactifs en trois étapes et quatre conditions visuelles. Les résultats révèlent des difficultés persistantes à prédire les actions et à les ancrer sur des cibles visuelles, ainsi que la dépendance des réactions des agents à l’égard du soutien contextuel et spatial.
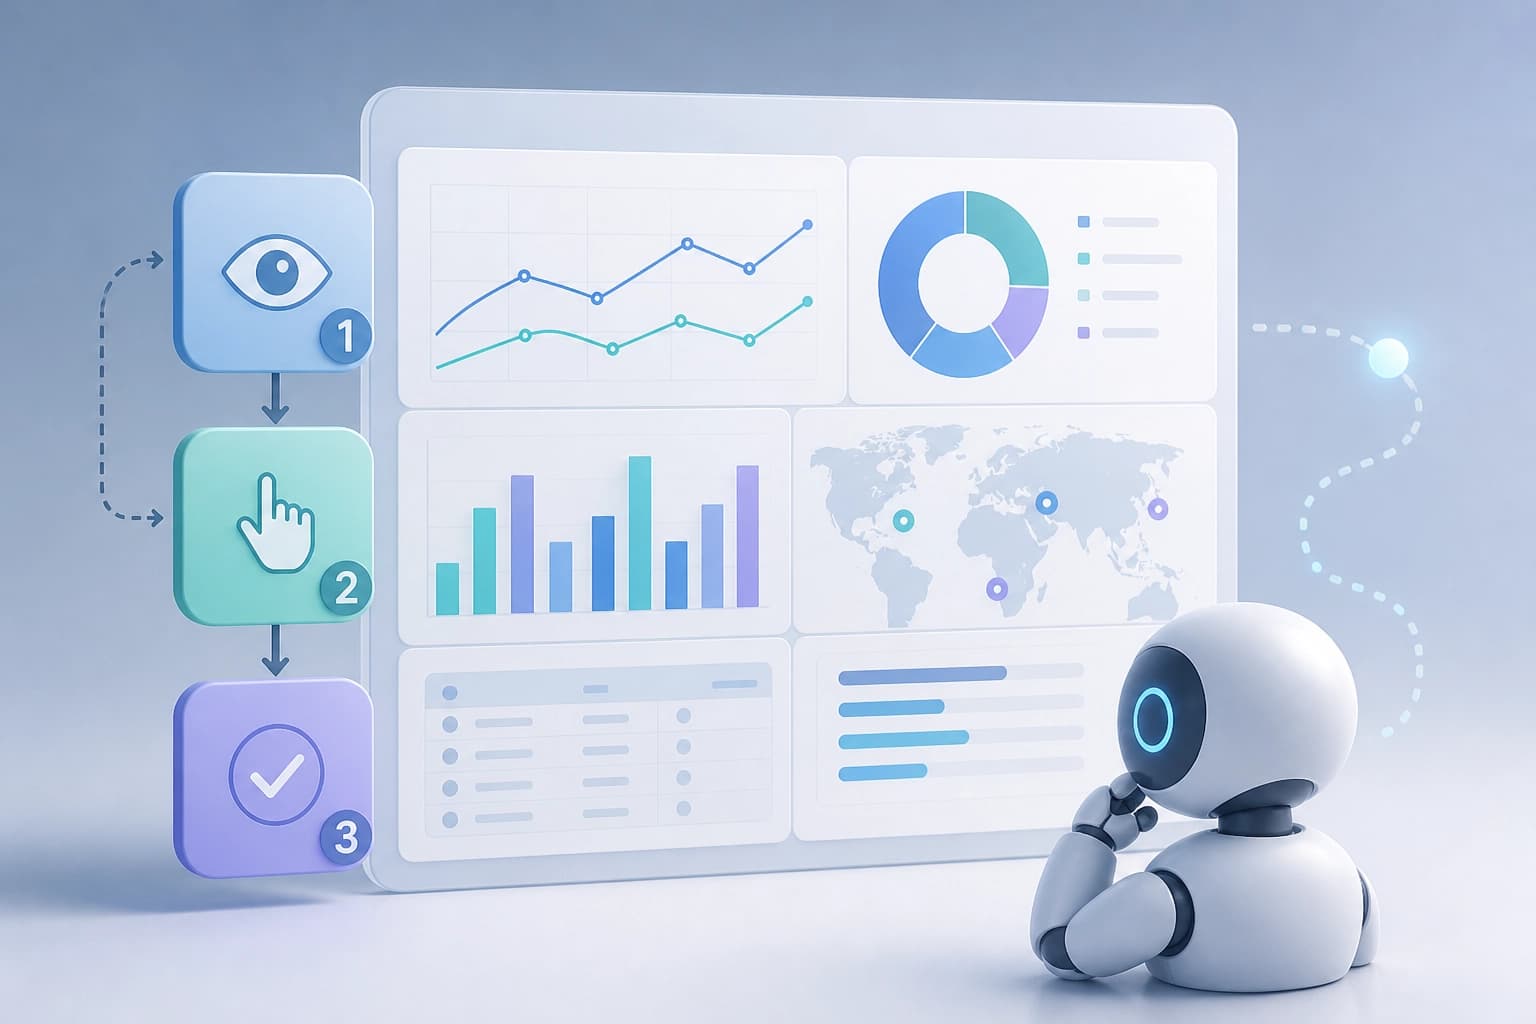
Ce que teste DashAct
DashAct est un benchmark d’évaluation des agents GUI lors de l’analyse interactive de tableaux de bord. Il teste les mêmes interactions annotées avec des niveaux de soutien contextuel et spatial qui varient de façon systématique. La version v2 est datée du 19 octobre 2026 ; la première version, du 26 septembre 2026.
Conclusion : DashAct compare les agents GUI sur les mêmes interactions annotées. Critère pratique : choisir un benchmark pour diagnostiquer les défaillances, et pas seulement pour obtenir une métrique finale.
Trois étapes de diagnostic
Le benchmark divise le diagnostic en trois étapes. Elles vont de l’exécution complète à des vérifications isolées. Quatre conditions visuelles modifient les conditions d’évaluation des mêmes interactions.
| Étape | Ce qui est évalué | Rôle dans le diagnostic |
|---|---|---|
| exécution de bout en bout | Exécution complète de l’interaction avec le tableau de bord | Révèle les défaillances lors de l’exécution en ligne |
| prédiction d’action avec contexte vérifié | Prédiction de l’action avec un contexte vérifié | Distingue les erreurs de prédiction de l’action |
| ancrage conditionné par la cible | Justification visuelle de la cible à partir de la condition | Vérifie la précision de la localisation de la cible |
Les annotations cohérentes des actions et de la disposition spatiale relient les résultats des étapes. Elles aident à interpréter les défaillances lors de l’exécution en ligne.
Conclusion : les étapes ne font pas double emploi. Critère pratique : commencer par l’exécution de bout en bout pour examiner une défaillance générale, puis passer à la prédiction de l’action et à l’ancrage pour en trouver l’origine.
Structure des trajectoires et des annotations
Le jeu de données contient 348 trajectoires d’interaction vérifiées par des humains. Les trajectoires comportent des dépendances entre les étapes (dépendances entre jalons). Les annotations hiérarchiques des cibles (annotations hiérarchiques des cibles) définissent la structure des tâches. Les annotations cohérentes des actions et de la disposition spatiale sont associées aux mêmes interactions.
Ces annotations permettent de comparer les résultats des étapes. Si un agent échoue lors de l’exécution de bout en bout, les annotations indiquent à quelle étape et pour quelle cible la défaillance s’est produite. Le diagnostic est ainsi reproductible.
Conclusion : la valeur de DashAct réside dans la cohérence des annotations. Critère pratique : vérifier que les annotations de l’action et de la disposition spatiale concordent avant de conclure à une erreur de l’agent.
Conditions visuelles et réaction des modèles
DashAct évalue les mêmes interactions dans quatre conditions visuelles. La réaction au soutien contextuel et spatial dépend du modèle. Un même agent peut obtenir des résultats différents lorsque le soutien change. Une comparaison dans une seule condition ne permet pas d’évaluer sa robustesse.
Conclusion : pour établir un diagnostic, il faut examiner les quatre conditions visuelles. Critère pratique : noter comment les résultats évoluent avec le soutien contextuel et spatial, et pas seulement la précision finale.
Résultats des expériences et adaptation de Qwen
Les expériences ont révélé des difficultés persistantes dans la prédiction des actions et la justification visuelle précise des cibles. L’étude de l’adaptation basée sur Qwen a également amélioré la localisation des cibles et l’Online Milestone Coverage. L’amélioration a concerné la localisation des cibles et l’Online Milestone Coverage. Ces résultats correspondent à différentes étapes du diagnostic.
Conclusion : l’adaptation basée sur Qwen est utile pour la localisation des cibles et l’Online Milestone Coverage. Critère pratique : évaluer l’Online Milestone Coverage indépendamment de la localisation des cibles afin d’observer l’effet de l’adaptation.
Intégrer DashAct à un diagnostic par étapes
Le diagnostic par étapes commence par l’exécution de bout en bout. Vient ensuite la prédiction d’action avec contexte vérifié. L’ancrage conditionné par la cible clôt le processus. Les quatre conditions visuelles reproduisent les mêmes interactions dans des conditions différentes.
L’ordre est important : chaque étape suivante permet de mieux cerner l’origine de l’erreur. Les annotations relient les résultats et évitent de perdre le contexte. Si une défaillance se répète à différentes étapes, sa cause vient plus probablement de l’agent que d’une condition particulière.
Conclusion : DashAct fournit une structure pour analyser les défaillances. Critère pratique : utiliser les trois étapes et les quatre conditions visuelles. Évaluer le résultat de l’adaptation de Qwen à l’aide de la localisation des cibles et de l’Online Milestone Coverage.
Foire aux questions
Matériaux connexes
Tous matériaux
Toollery : sélection d’outils pour agents LLM parmi des dizaines de milliers d’options sans réentraînement
Toollery construit un index de recherche à partir des descriptions des compétences et des outils, puis ne transmet au modèle qu’un nombre limité de candidats pour chaque requête. Lors d’expériences menées sur des bibliothèques comptant jusqu’à plusieurs dizaines de milliers de fonctions, cette approche permet de maintenir la qualité de sélection avec un top-K fixe, même si l’effet final dépend du profil de charge et de la mise en cache côté fournisseur.
11 novembre 2026
WILSON : regroupement des grossissements et des lames du patient pour l’analyse pathomorphologique et la rédaction de comptes rendus
La prépublication présente WILSON, un modèle vision-langage qui encode des images de lames entières ainsi que des séries de prélèvements d’un même patient à différents grossissements, plutôt qu’une seule lame « optimale ». Sans entraînement supplémentaire pour une tâche donnée, il surpasse des modèles spécialisés et de plus grande taille dans plusieurs métriques, tout en nécessitant beaucoup moins de ressources de calcul, et ses descriptions diagnostiques ont obtenu de meilleures évaluations de la part des pathologistes.
11 novembre 2026
Invariants polynomiaux canoniques pour le diagnostic des défaillances des simulateurs RL : où sont-ils vraiment utiles
Ce travail évalue la pertinence d’intégrer les lois physiques dans des modèles de dynamique entraînables : les invariants extraits des trajectoires et mis sous forme canonique à l’aide de bases de Gröbner n’apportent qu’un gain modeste en matière de prédiction, mais se révèlent très utiles pour le diagnostic — ils permettent de localiser la contrainte violée et d’identifier le paramètre erroné.
10 novembre 2026