
WILSON : regroupement des grossissements et des lames du patient pour l’analyse pathomorphologique et la rédaction de comptes rendus
La prépublication présente WILSON, un modèle vision-langage qui encode des images de lames entières ainsi que des séries de prélèvements d’un même patient à différents grossissements, plutôt qu’une seule lame « optimale ». Sans entraînement supplémentaire pour une tâche donnée, il surpasse des modèles spécialisés et de plus grande taille dans plusieurs métriques, tout en nécessitant beaucoup moins de ressources de calcul, et ses descriptions diagnostiques ont obtenu de meilleures évaluations de la part des pathologistes.
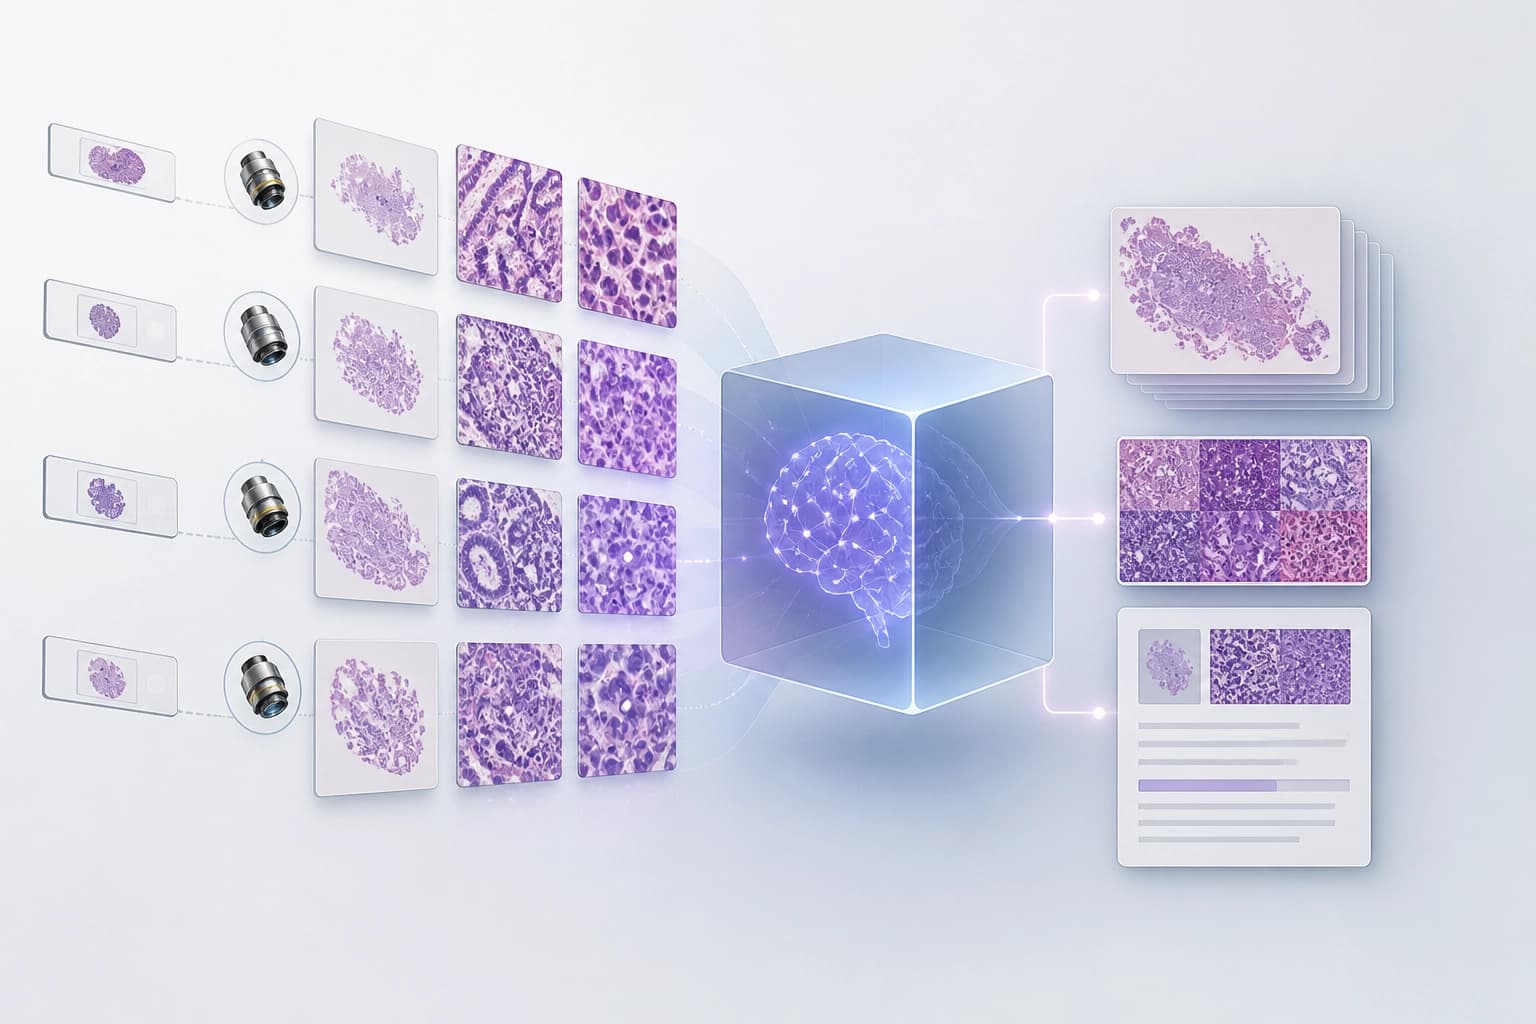
Pourquoi une seule lame représentative ne suffit pas
Les pathologistes examinent des coupes de tissus à différents grossissements et sur plusieurs lames. Ils combinent les informations morphologiques pour établir un diagnostic. La plupart des modèles de fondation pour la pathologie encodent des milliers de fragments d’image provenant d’une seule lame représentative (« best »). Les modèles agrègent ensuite ces caractéristiques.
Limites de cette approche :
- le modèle reçoit une seule lame « best », et non l’ensemble du cas ;
- les caractéristiques issues de différents grossissements ne sont pas réunies dans une représentation commune ;
- le contexte au niveau du patient est perdu lors de l’agrégation des fragments.
Critère pratique : pour une tâche au niveau du cas, il faut un modèle qui accepte plusieurs lames et différents grossissements. Une seule lame représentative ne couvre pas ce type de tâche.
Comment le modèle combine les grossissements et les lames
WILSON est un modèle de fondation vision-langage. Il représente les images de lames entières et les cas comportant plusieurs lames au moyen de composites multi-grossissements. Il prend en charge l’analyse au niveau du patient.
Éléments inclus dans la représentation :
- images de lames entières ;
- cas comportant plusieurs lames ;
- plusieurs grossissements intégrés dans des composites multi-grossissements.
Conclusion : le modèle préserve les informations morphologiques provenant de différentes échelles et de différentes lames dans une seule représentation. Cela le distingue d’une approche fondée sur une seule lame « best ».
Entraînement et couverture des données
L’échantillon d’entraînement de WILSON comprend environ 189 000 lames. Les données couvrent 42 organes et 838 entités diagnostiques.
Couverture :
- 189 000 lames ;
- 42 organes ;
- 838 entités diagnostiques.
La liste des organes et des entités définit le cadre de vérification de la tâche. Le spécialiste vérifie que l’organe et l’entité diagnostique figurent dans cette liste.
Résultats sans entraînement spécifique à la tâche
WILSON a surpassé un modèle spécialisé au niveau du cas en macro-F1, sans entraînement spécifique à la tâche. Le score était de 0,52 contre 0,38.
| Comparaison | WILSON | Alternative |
|---|---|---|
| Macro-F1 pour une tâche au niveau du cas | 0,52 | 0,38 |
| Opérations de calcul | 400 à 1 350 fois moins | modèles au niveau de la lame beaucoup plus volumineux |
Le modèle a également obtenu des résultats comparables à ceux de modèles au niveau de la lame beaucoup plus volumineux. Il nécessite toutefois 400 à 1 350 fois moins d’opérations de calcul.
Conclusion : la qualité de l’analyse au niveau du cas n’a pas nécessairement à augmenter avec le coût de calcul. Une représentation compacte à plusieurs échelles constitue un repère pratique.
Ajustement pour des tâches spécifiques
Le fine-tuning de bout en bout a amélioré les résultats de WILSON pour les tâches suivantes :
- sous-typage du cancer du sein ;
- gradation des lymphocytes stromaux.
Critère pratique : pour une tâche spécifique, il convient d’envisager un fine-tuning de bout en bout. Le modèle de base effectue l’analyse au niveau du cas sans fine-tuning, tandis que le fine-tuning améliore les performances pour certaines tâches.
Recherche et génération de texte diagnostique
Pour la recherche image-texte, WILSON a surpassé PRISM en recall@1. Le résultat était de 75,6 % contre 58,1 %.
| Métrique | WILSON | PRISM |
|---|---|---|
| recall@1 | 75,6 % | 58,1 % |
Les descriptions diagnostiques de WILSON ont reçu des évaluations plus élevées de la part de cinq pathologistes certifiés par un board. Les modèles concurrents ont reçu des évaluations plus faibles.
Critère pratique : pour la recherche et la préparation d’un compte rendu, deux capacités sont importantes : la recherche d’informations et la génération de texte. Elles sont évaluées à l’aide de tâches proches du flux de travail.
Ce que cela signifie pour le choix d’un modèle
Les auteurs concluent que les représentations compactes à plusieurs échelles peuvent soutenir des modèles de fondation efficaces en calcul et adaptés à la pratique clinique. Pour choisir un modèle, cela implique plusieurs vérifications.
Critères :
- le modèle accepte plusieurs lames ;
- le modèle relie différents grossissements ;
- l’analyse se fait au niveau du patient ;
- la qualité est mesurée sur des tâches au niveau du cas ;
- les opérations de calcul sont prises en compte ;
- la recherche d’informations et la génération de texte sont évaluées séparément.
Conclusion : une seule lame « best » et l’agrégation de milliers de fragments ne suffisent pas à couvrir le contexte du patient. Le choix du modèle dépend de la façon dont il rassemble ce contexte et du nombre d’opérations de calcul nécessaires.
Foire aux questions
Matériaux connexes
Tous matériaux
Diagnostic étape par étape des agents GUI lors de l’analyse de tableaux de bord : benchmark DashAct
Découvrez DashAct, un benchmark de 348 trajectoires vérifiées par des humains, qui décompose le travail des agents GUI avec des panneaux interactifs en trois étapes et quatre conditions visuelles. Les résultats révèlent des difficultés persistantes à prédire les actions et à les ancrer sur des cibles visuelles, ainsi que la dépendance des réactions des agents à l’égard du soutien contextuel et spatial.
11 novembre 2026
Invariants polynomiaux canoniques pour le diagnostic des défaillances des simulateurs RL : où sont-ils vraiment utiles
Ce travail évalue la pertinence d’intégrer les lois physiques dans des modèles de dynamique entraînables : les invariants extraits des trajectoires et mis sous forme canonique à l’aide de bases de Gröbner n’apportent qu’un gain modeste en matière de prédiction, mais se révèlent très utiles pour le diagnostic — ils permettent de localiser la contrainte violée et d’identifier le paramètre erroné.
10 novembre 2026
AURA-Eval : comment vérifier qu’un agent LLM a reconnu le risque et modifié l’étape suivante
Le framework évalue le comportement des agents LLM non pas d’après leur verdict final, mais selon leur réaction au risque aux étapes clés : les trajectoires d’appels aux outils sont interrompues, puis le modèle doit poursuivre son raisonnement et son action, tandis qu’un panel de juges LLM examine la détection du risque, sa nature et la sécurité de l’étape. Sur 1 249 tâches issues de 157 trajectoires R-Judge, les actions dangereuses deviennent plus fréquentes chez 20 modèles en l’absence de voie sûre, et la levée de la supervision avant l’exécution fait basculer 52,3 % des cas initialement sûrs dans la catégorie des cas dangereux.
10 novembre 2026