Un backdoor arrive par le pipeline, pas par l'utilisateur
Les modèles multimodaux s'intègrent toujours plus étroitement dans les scénarios applicatifs : ils lisent des captures d'écran, analysent des photos de produits, répondent à des questions sur des scans de documents. Avec le confort, une vulnérabilité étrangère s'invite aussi dans le produit. Le modèle est assemblé à partir de composants prêts à l'emploi — un encodeur visuel, une projection, une partie linguistique — et à chaque étape de l'assemblage, un déclencheur caché peut s'y glisser. Parfois il est dissimulé dans une image, parfois dans le texte, et parfois il exige la combinaison des deux signaux.
Ensuite commence la partie désagréable. Les outils qui se débrouillaient plutôt bien avec les classificateurs « empoisonnés » perdent nettement pied sur les modèles multimodaux : trop de couches, des modalités trop différentes, une géométrie interne des représentations trop complexe. Et les solutions conçues spécialement pour les MLLM opèrent le plus souvent en entrée — elles filtrent les requêtes suspectes avant même qu'elles n'atteignent le réseau. Un filtre peut arrêter une attaque précise, mais l'infection elle-même reste dans les poids. Contourner le filtre n'est qu'une question d'ingéniosité pour l'attaquant.
L'incohérence couche par couche comme empreinte de l'attaque
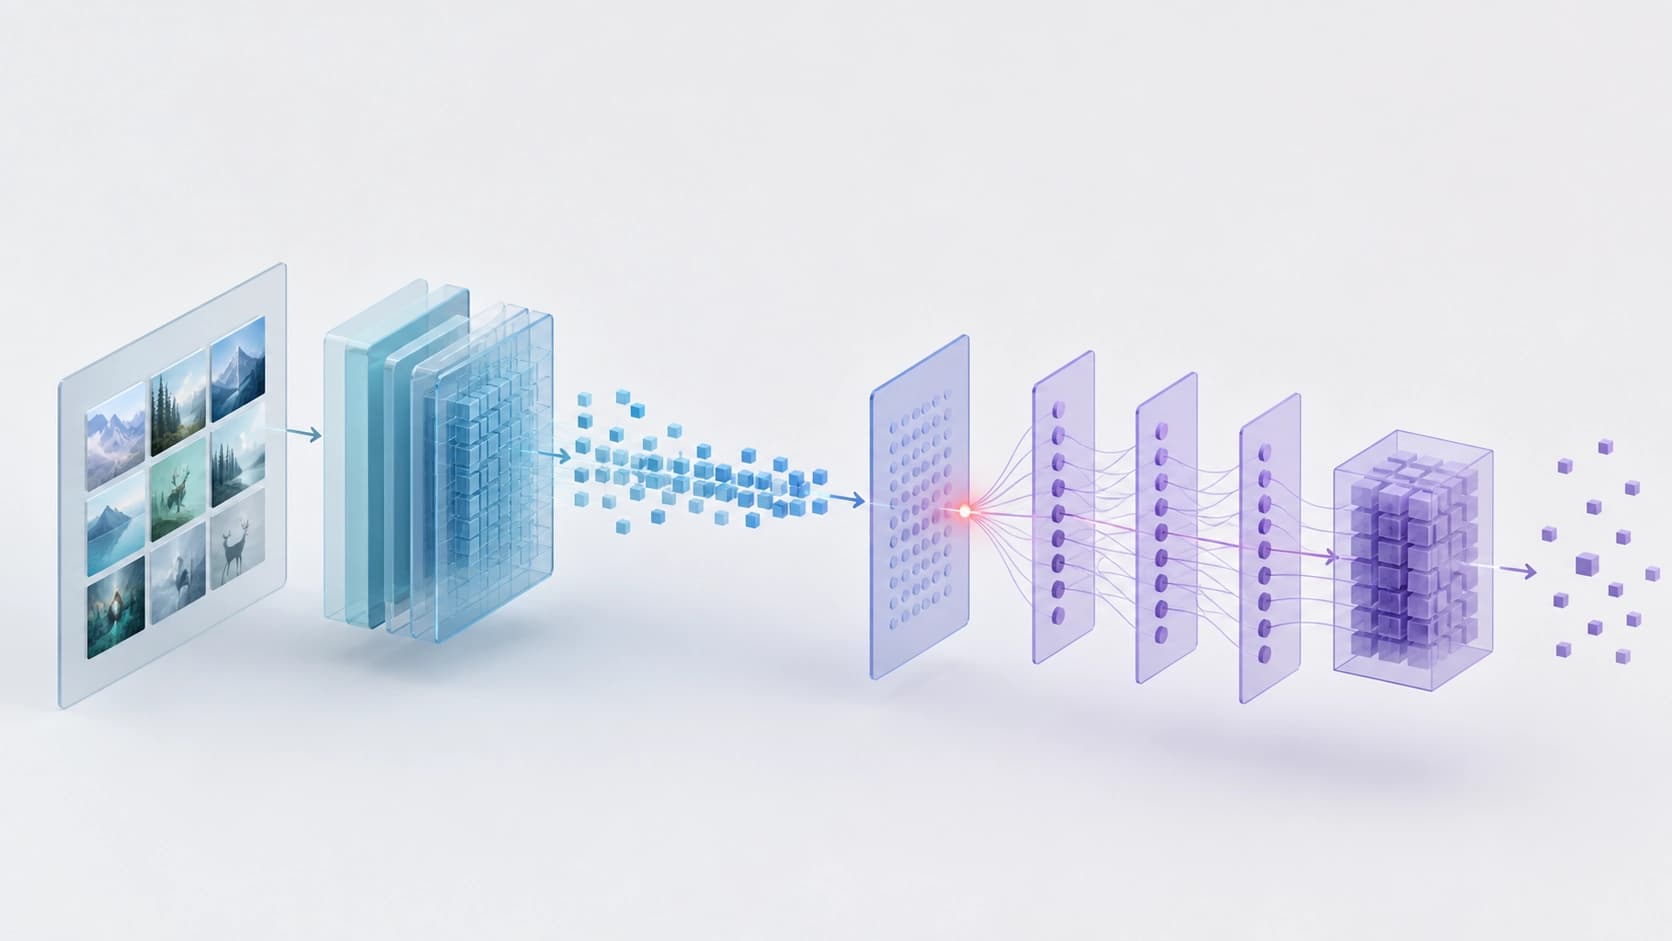
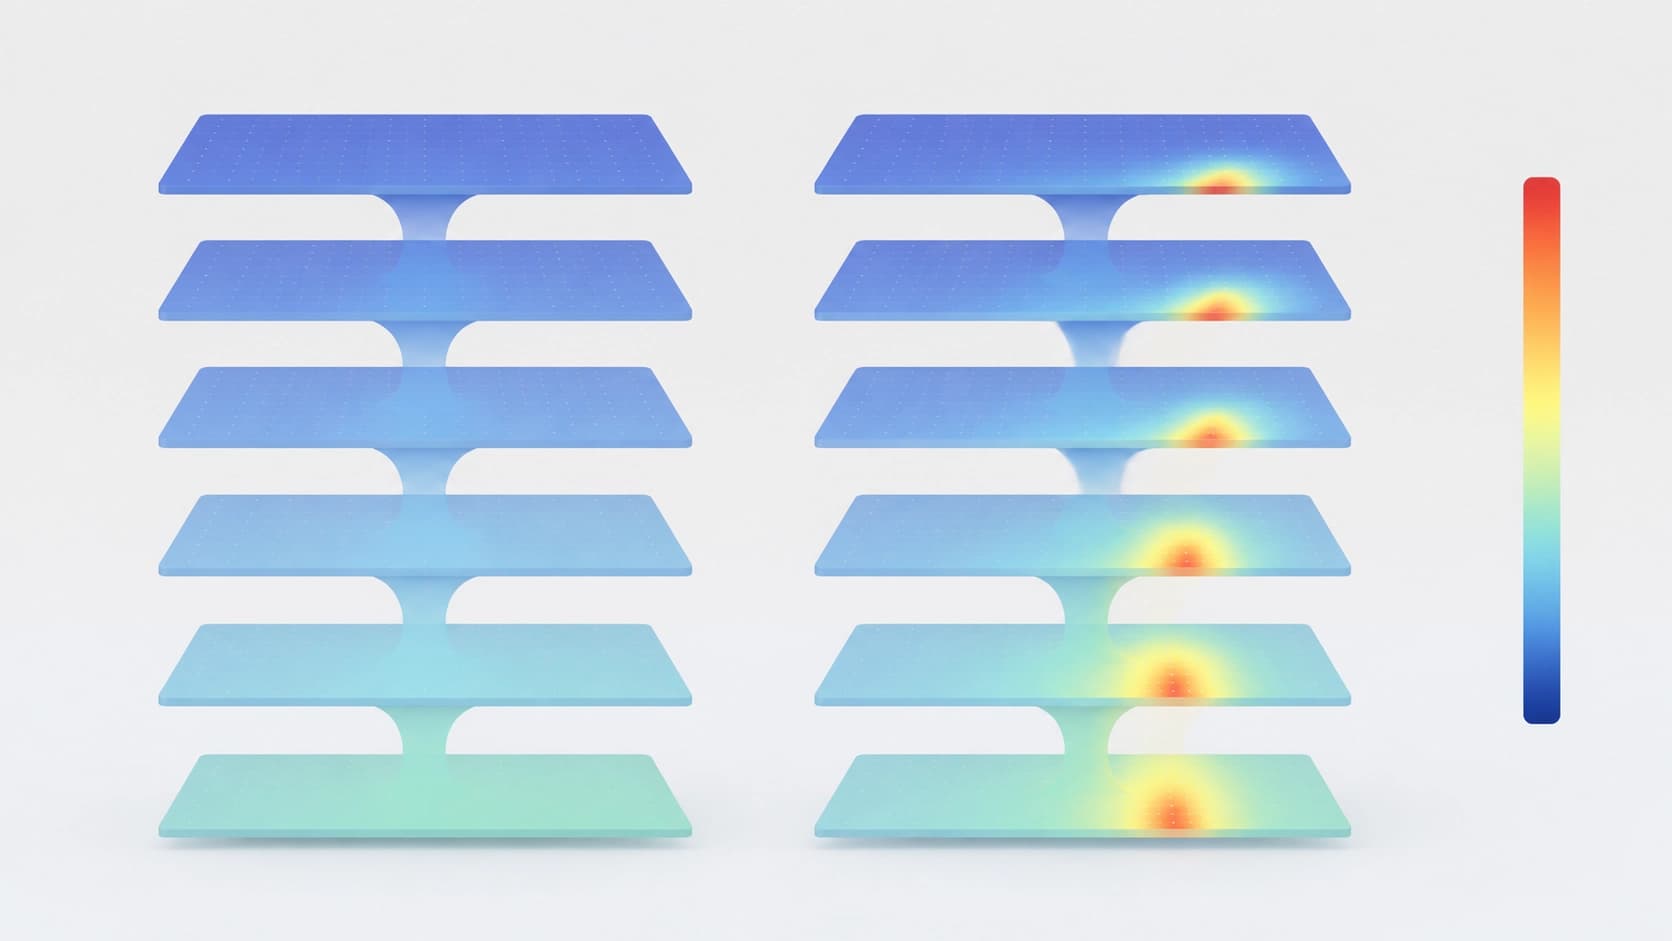
Les auteurs du travail arXiv:2608.24354 (Jiali Wei et huit autres coauteurs ; catégories cs.CR, cs.AI, cs.CL, soumission — août 2026) ont prêté attention à une chose facile à manquer si l'on ne regarde que l'entrée et la sortie. Le backdoor laisse une trace non pas dans une seule couche, mais dans la trajectoire : les représentations, en passant de couche en couche, évoluent de manière atypique. C'est ce qu'ils ont appelé l'anomalie d'incohérence couche par couche.
Le détail clé : l'anomalie n'est pas étalée uniformément sur tout le réseau. Elle est liée à la modalité et, plus important encore, localisée dans la zone de tokens où réside le signe du déclencheur. Autrement dit, le modèle « s'appuie » sur une portion étroite de la représentation, et c'est précisément là qu'apparaît un décalage absent sur des données propres.
D'où une conclusion pratique : si l'on moyenne l'incohérence sur toute la représentation, le signal se noie dans le bruit des caractéristiques utiles. Il faut d'abord séparer ce que le modèle a déjà mélangé.
Comment fonctionne RACER
Séparation par modalités
Le framework de restauration au niveau du modèle — et non une surcouche au-dessus de l'inférence — a reçu le nom de RACER (Region-Aware Consistency Repair). La logique est la suivante : la représentation fusionnée est décomposée à nouveau en zones de tokens visuelle et textuelle, l'incohérence couche par couche est calculée séparément pour chacune, puis le tout est recomposé, mais avec des pondérations tenant compte de la modalité. Le travail s'effectue dans une fenêtre de couches profondes — là où se forment des décalages stables et directionnels.
Le résultat est une fonction objectif sensible aux régions. Elle est plus sensible aux anomalies locales qu'une métrique globale sur tout le vecteur, et empêche les caractéristiques utiles d'étouffer le signal du backdoor.
Min-max plutôt qu'un simple réentraînement
Ensuite entre en jeu un schéma adversarial. Via une optimisation min-max, le framework cherche d'abord la pire perturbation — celle qui amplifie au maximum l'incohérence détectée — puis réentraîne le modèle pour que cette perturbation ne le casse pas. En clair : ils s'attaquent eux-mêmes pour durcir les directions de représentation sur lesquelles repose le comportement nuisible.
Le côté pratique n'est pas moins important que le technique. La méthode n'a besoin que de 100 exemples propres. Elle n'a besoin de connaître ni le déclencheur lui-même, ni le label cible de l'attaque, ni même si le modèle fourni est infecté. C'est fondamental : la défense ne se transforme pas en une tâche de « devine l'attaque ».
Ce qu'ont montré les mesures
Les auteurs ont passé la méthode sur trois modèles multimodaux ouverts dans 36 configurations de backdoor — avec des déclencheurs dans l'image, dans le texte et dans les deux canaux à la fois. L'ASR moyen (la proportion de cas où l'attaque finit par fonctionner) a pu être ramené à 1,1 %, et dans 32 configurations sur 36, l'indicateur est tombé à zéro.
Le second résultat n'est pas moins important, même s'il est évoqué plus rarement : l'utilité sur les tâches propres est préservée. Et ce, aussi bien pour les modèles infectés que pour ceux initialement propres — autrement dit, la restauration ne transforme pas un modèle opérationnel en un modèle prudent mais inutile. C'est le prix typique des méthodes de nettoyage agressives, et ici, d'après les mesures, il a été évité.
Ce que cela change en pratique
La différence entre le filtrage en entrée et la restauration des poids n'est pas académique. Le filtre vit dans l'infrastructure autour du modèle : il faut le maintenir, le mettre à jour face à de nouveaux types d'attaques, et il reste contournable par un autre canal. La correction au niveau des poids élimine la cause, pas le symptôme, et n'ajoute pas de latence à l'inférence.
Il y a aussi un enjeu plus large. Nous avons l'habitude d'évaluer la sécurité d'un modèle d'après ses réponses aux tests, mais RACER montre que le signal informatif est caché dans les représentations intermédiaires — dans la façon dont le réseau pense, et non dans ce qu'il dit. Si cette approche passe à l'échelle au-delà des trois architectures testées, les fournisseurs de MLLM disposent d'une étape d'hygiène relativement peu coûteuse : une centaine d'exemples propres et un peu de calcul avant de publier les poids. Les limites sont elles aussi claires — le travail porte sur une classe précise d'attaques et exige un accès aux entrailles du modèle, ce qui rend le schéma directement inapplicable aux modèles à API fermée.