Pourquoi les agents avaient besoin d'une nouvelle mesure
La plupart des benchmarks d'agents répondent à des questions claires : le modèle a-t-il choisi le bon outil, a-t-il correctement assemblé les arguments, a-t-il atteint le résultat attendu. Presque toutes ces mesures sont construites autour d'une exécution séquentielle — un appel après l'autre, sans hâte ni concurrence pour les ressources.
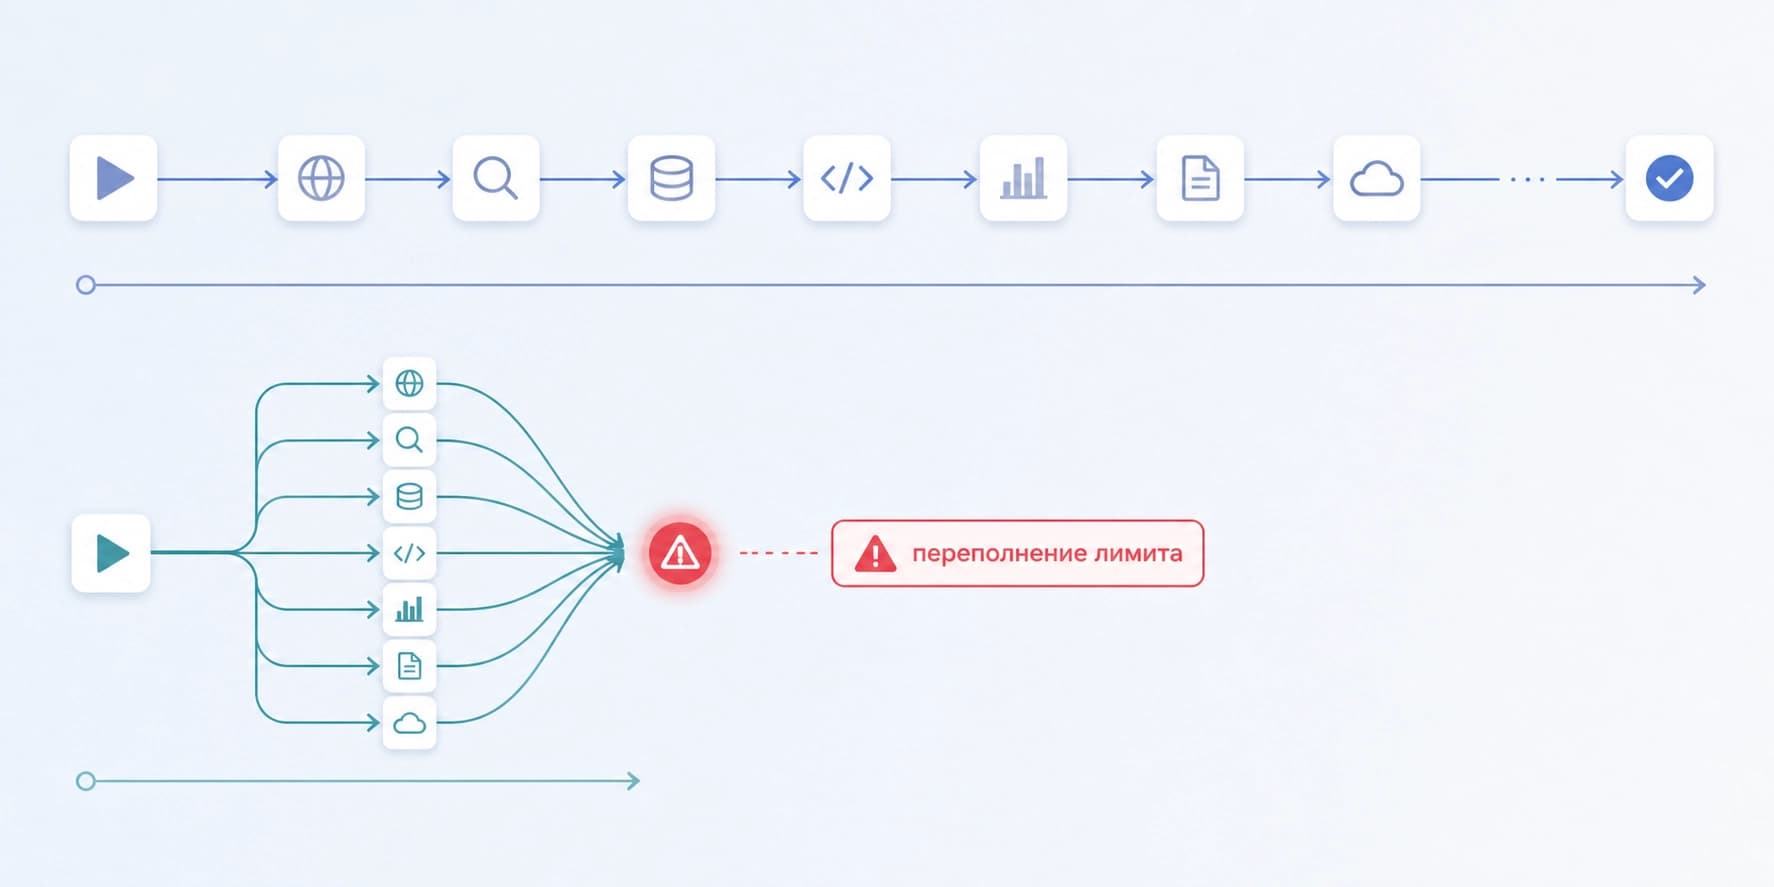
L'exploitation, elle, se présente autrement. Pour tenir une latence acceptable, l'agent doit lancer des appels indépendants en parallèle. Mais le parallélisme sans égard pour les limites se heurte à un autre mur : quotas épuisés, mémoire saturée, service externe défaillant.
PeakBench porte précisément sur cette zone aveugle. Les auteurs Zhi-Kai Chen, Xu-Xiang Zhong, Song-Yan Li, De-Chuan Zhan et Han-Jia Ye la décrivent dans le préprint arXiv:2608.24509 (v1 du 25 août 2026, catégories cs.AI et cs.SE) ; le code promis sera publié avec l'article.
L'idée clé d'où découle tout ce travail : un agent a deux façons d'échouer, et elles sont opposées. L'exécution séquentielle est sûre mais lente — les limites ne sont pas dépassées simplement parce que rien ne s'exécute simultanément. Le parallélisme sans prise en compte des ressources est rapide, mais conduit à des saturations qu'il était facile d'éviter. C'est entre ces deux pôles que se situe ce que personne n'a vraiment mesuré.
Ce que représente le benchmark
Au lieu de tâches statiques avec des réponses de référence, on utilise ici des flux de travail multi-outils exécutables. Chacun comporte deux éléments importants : des annotations de dépendances, montrant quelles étapes sont réellement liées entre elles, et des profils de ressources mesurés — combien de mémoire, de temps ou de quota consomme un appel donné.
Cette construction change l'objet même de l'évaluation. La question « a-t-on obtenu la bonne réponse » passe au second plan, et c'est la question « comment l'agent a-t-il réparti le travail dans le temps et est-il resté dans le budget » qui passe au premier.
Planification logique contre planification physique
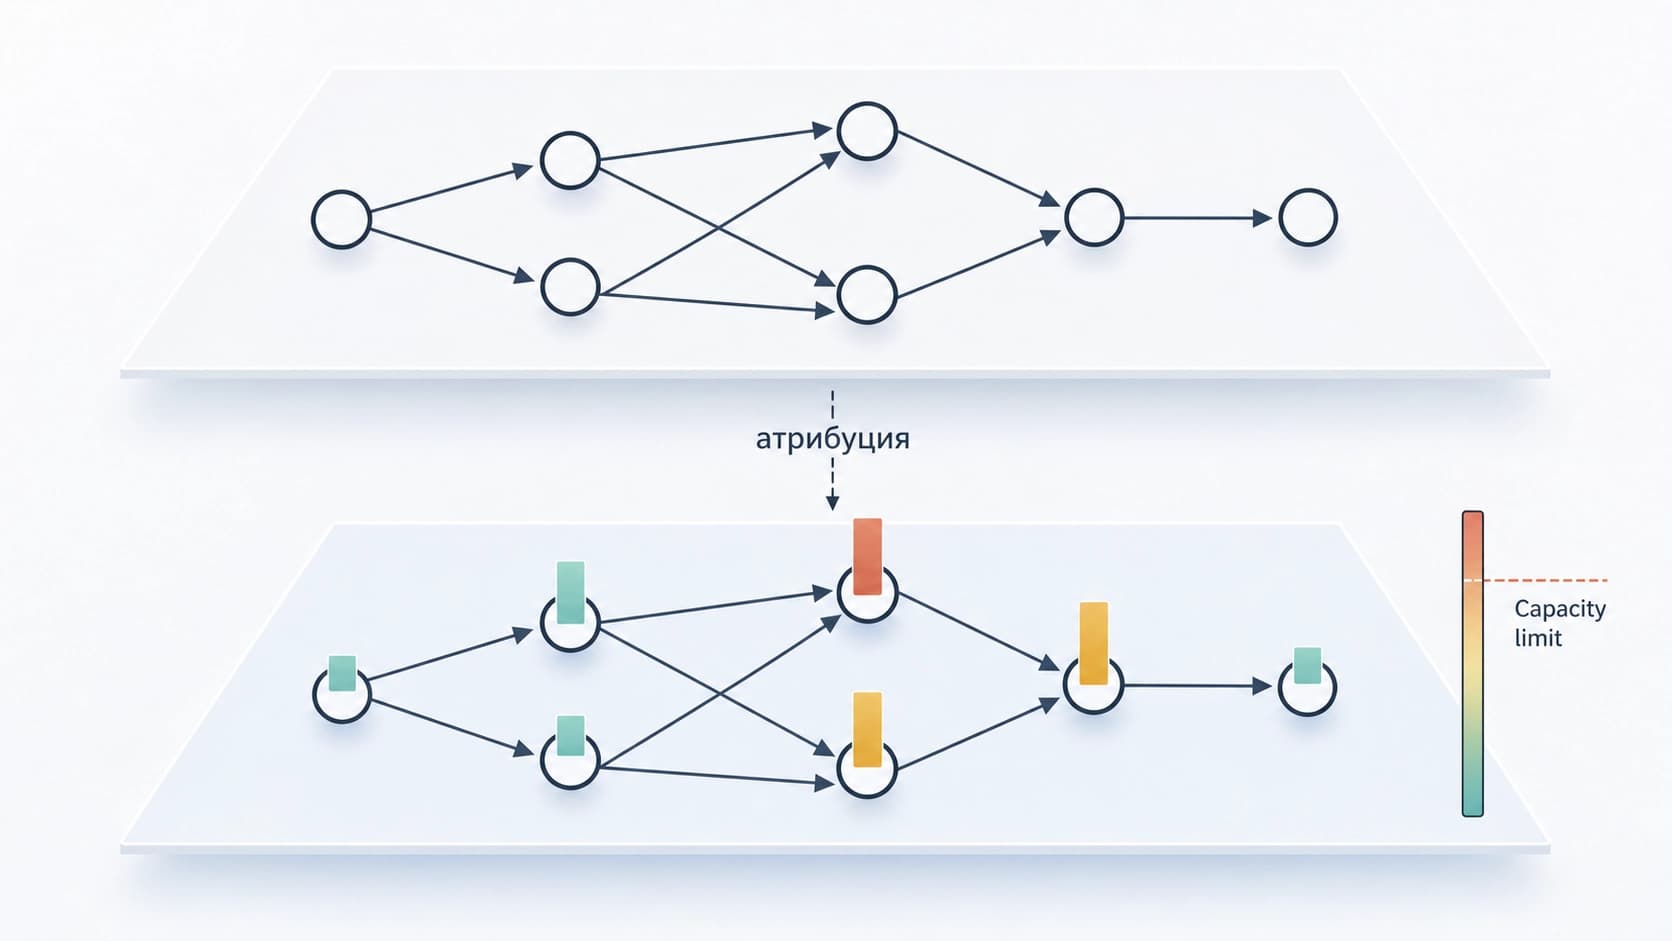
La difficulté centrale dans l'évaluation de tels processus est l'attribution. Quand une exécution s'effondre, on ne sait pas ce qui est en cause : l'agent a mal analysé les dépendances, ou les a bien analysées mais n'a pas tenu compte des ressources disponibles, ou les deux à la fois. Tout ramener à une seule métrique de succès, c'est perdre le plus utile.
C'est pourquoi l'évaluation est divisée en deux parties. Une dimension répond de la planification logique : l'ordre des étapes, la justesse des dépendances, l'absence de liens inventés. L'autre — de la planification physique, c'est-à-dire de l'ordonnancement compte tenu des contraintes réelles. Ces dimensions ont leurs propres métriques, et un échec dans l'une ne masque pas un succès dans l'autre.
Mauvais ordre et mauvais budget — deux maladies différentes
Le schéma en deux parties n'est pas là pour une belle taxonomie, mais pour le diagnostic. Si l'agent s'est trompé au niveau de la logique, il est inutile de lui parler de la taille du quota — il n'a pas compris ce qui dépend de quoi. Si la logique est bonne mais que l'exécution échoue, le problème vient de l'ordonnanceur ou de la manière dont les ressources disponibles ont été communiquées à l'agent.
Conclusion pratique pour ceux qui conçoivent des systèmes d'agents : avant de réparer quoi que ce soit, il vaut la peine de comprendre à laquelle des deux couches appartient la défaillance. L'ingénierie de prompts, l'apprentissage sur trajectoires et la correction des outils soigneront des pannes tout à fait différentes.
Résultat principal : une logique soignée ne protège pas de la surcharge
La conclusion la plus désagréable du travail est la suivante : une forte planification logique ne garantit ni une exécution sûre, ni une exécution efficace dans des conditions de ressources limitées. L'agent peut construire un graphe de dépendances impeccable — et malgré tout faire tomber le système en lançant d'un coup tout ce qui n'est pas relié par des arêtes.
La divulgation des ressources réduit le nombre de saturations évitables
Deuxième observation : si l'on donne à l'agent des informations sur les ressources disponibles, le nombre de saturations évitables diminue et l'utilisation augmente. Ce n'est ni magie ni nouvelle architecture — simplement, le contexte n'inclut plus seulement les descriptions des outils, mais aussi les budgets à respecter.
Il importe ici de ne pas surestimer l'effet. Il s'agit de dire que la transparence sur les ressources est une intervention peu coûteuse et efficace, et non qu'elle résout le problème entièrement : l'agent doit encore gérer cette information avec discernement.
À qui cela sera utile
Le benchmark est conçu comme un banc d'essai pour diagnostiquer le comportement des agents conscient des ressources, et c'est là sa vocation principale. Il ne se contente pas de donner une note finale : il montre où exactement le modèle craque — dans la compréhension des dépendances ou dans la discipline des dépenses.
D'où plusieurs scénarios d'utilisation. Pour les développeurs de frameworks d'agents — un moyen de tester l'ordonnanceur avant la production, et non après l'incident. Pour les chercheurs — une configuration reproductible pour des expériences sur les budgets en contexte. Pour ceux qui choisissent un modèle pour une tâche à limites strictes — la possibilité de voir une différence entre modèles que les tests de réussite habituels ne montrent tout simplement pas.
Ce qu'il faut garder en tête
L'approche a un coût d'entrée évident : les profils de ressources doivent être mesurés, et les dépendances — annotées. Dans les systèmes réels, les limites sont bruitées, les services externes changent de comportement sous charge, et le coût d'un appel n'est pas toujours connu à l'avance. La rigueur en laboratoire est ici supérieure à celle du terrain, et il ne faut pas transposer les conclusions telles quelles en production.
Mais le cadre lui-même est utile même sans le benchmark. Deux questions — « l'agent a-t-il correctement compris ce qui dépend de quoi » et « est-il resté dans le budget » — méritent d'être posées à tout système d'agents, même sans banc d'essai prêt à les vérifier.