
Une courte chaîne de raisonnement n'est pas toujours la meilleure
Les grands modèles entraînés à « penser à voix haute » tirent leur force de longues chaînes de raisonnement. Plus la tâche est complexe, plus le modèle écrit d'étapes intermédiaires avant de donner une réponse. L'un des mécanismes généralement considérés comme essentiels à cette qualité est l'autoréflexion : la capacité à revenir sur les étapes déjà effectuées, à repérer une erreur et à réécrire le déroulement de la solution.
Le problème, c'est que cette capacité a un coût. Chaque acte de révision représente des tokens supplémentaires à l'inférence, donc de l'argent, du temps et des ressources de calcul. Pourtant, jusqu'à récemment, personne n'expliquait vraiment ce qui régit la décision du modèle de « s'arrêter et se vérifier ». L'autoréflexion était une sorte de boîte noire dans une boîte noire : on sait qu'elle fonctionne, on ne comprend pas comment.
Les travaux de Ge Yan, Chung-En Sun, Linbo Liu et Tsui-Wei Weng (arXiv:2512.13979, acceptés à COLM 2026) abordent la question sous un angle inattendu — non pas par les prompts ni par l'affinage, mais par les représentations latentes du modèle.
La direction de la réflexion à l'intérieur du modèle
Ce qui a été recherché et ce qui a été trouvé
Les chercheurs ont appliqué à l'autoréflexion l'appareil du representation engineering — une approche qui étudie non pas les textes en sortie du modèle, mais ses activations internes. La logique est simple : si le modèle « décide » de réfléchir, cette décision se reflète quelque part dans ses représentations. Elle peut donc être trouvée, décrite et — surtout — utilisée.
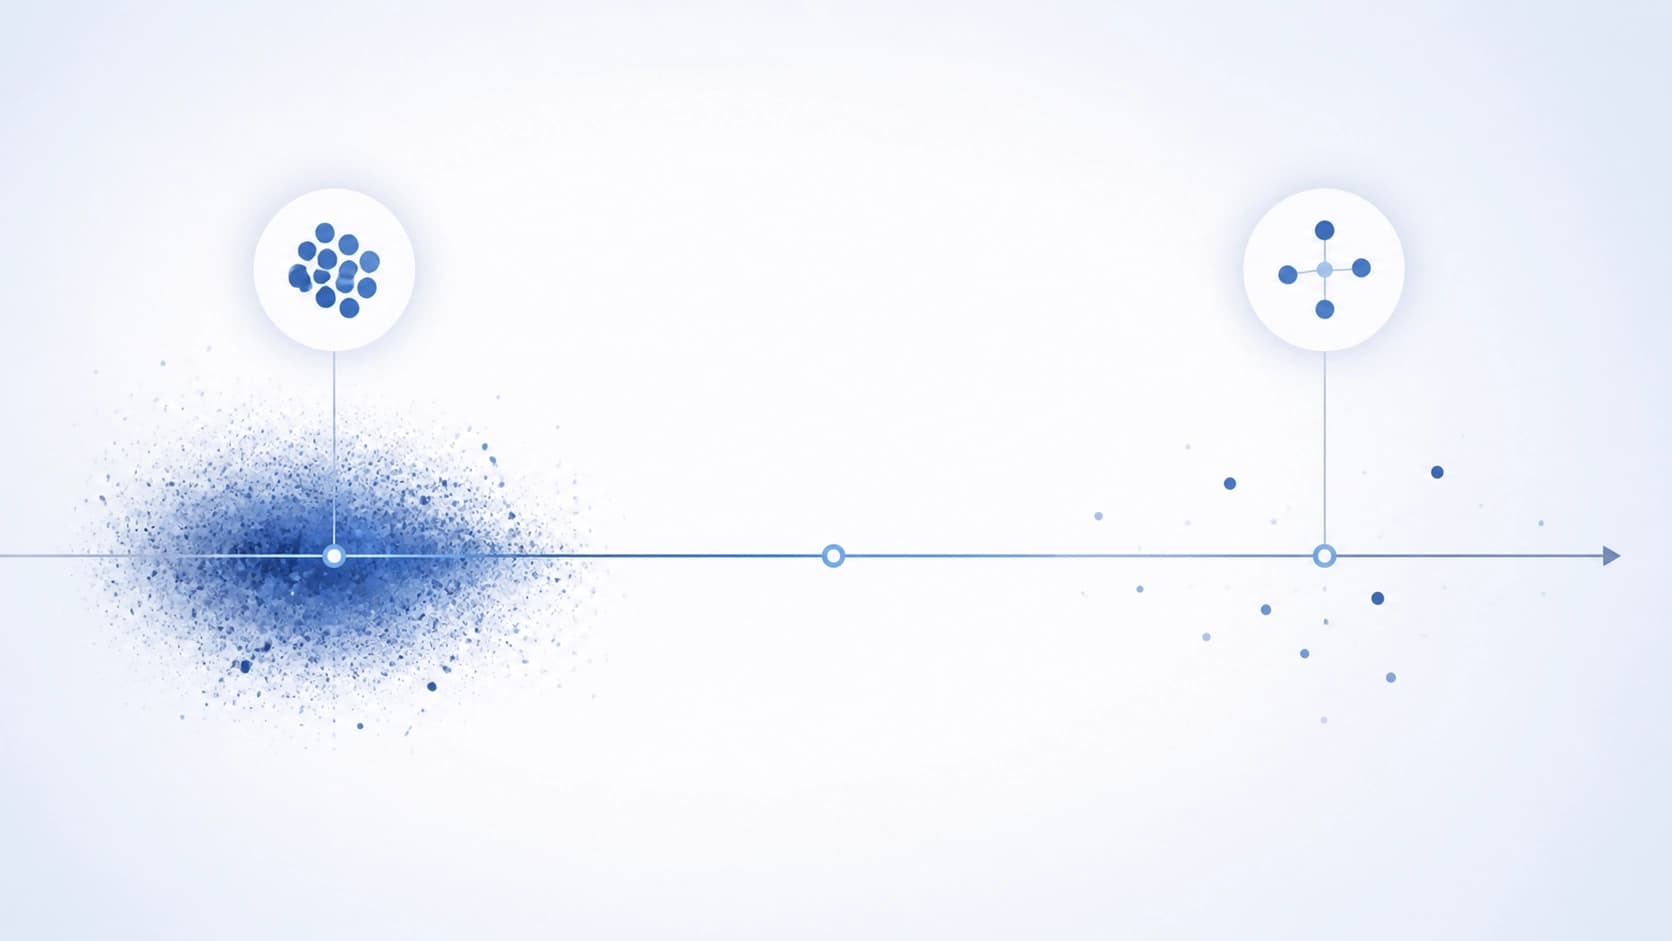
C'est bien ce qui s'est produit. Dans l'espace latent, une direction privilégiée a été découverte, le long de laquelle les étapes avec réflexion se distinguent des étapes sans réflexion. Il s'agit en substance d'un axe « vérifier / ne pas vérifier », et la position du point sur cet axe distingue de manière stable les deux types d'étapes.
La réflexion est gouvernée par l'incertitude
L'observation la plus intéressante de l'article : l'amplitude de l'activation le long de la direction trouvée prédit bien si la réponse finale sera correcte. Autrement dit, la réflexion ne s'active ni par hasard ni selon un planning — elle est liée à l'incertitude interne du modèle. Quand le modèle « sent » que ça glisse, il freine et révise ; quand tout est clair, il continue.
C'est un changement important de vision. La réflexion cesse d'être une capacité distincte qu'il faudrait développer et devient plutôt un signal — un indicateur du fait que le modèle doute lui-même de son étape.
Comment fonctionne ReflCtrl
Si la décision de réfléchir réside dans les activations, on peut l'influencer directement — en intervenant sur les représentations, plutôt qu'en réécrivant le prompt. C'est sur cela que repose ReflCtrl : un framework qui gouverne l'autoréflexion par le steering — un décalage des activations le long de la direction trouvée.
Le détail clé — le moment précis de l'intervention
L'approche naïve est évidente : ajouter le décalage voulu à chaque token généré. C'est la première idée qui vient à l'esprit — et c'est précisément celle qui fonctionne mal. Une pression constante sur les représentations dégrade la qualité de la génération : le modèle perd sa cohérence, parce que l'intervention s'applique aussi là où elle n'a pas de sens.
Les auteurs proposent une variante par étapes (step-level). L'intervention est appliquée exactement une fois — tout au début de chaque nouvelle étape de raisonnement. Ensuite, le modèle génère les tokens de cette étape librement, sans entrave. Le résultat est un réglage fin : la fréquence de la réflexion change, mais le déroulement même de la pensée à l'intérieur de l'étape reste intact.
C'est précisément cette combinaison — une intervention rare et ciblée plutôt que continue — qui apporte le gain principal.
Ce que les expériences ont montré
Les tests ont été menés sur des benchmarks de raisonnement mathématique et général. Les résultats convergent vers une conclusion assez gênante pour l'industrie : la réflexion est souvent superflue.
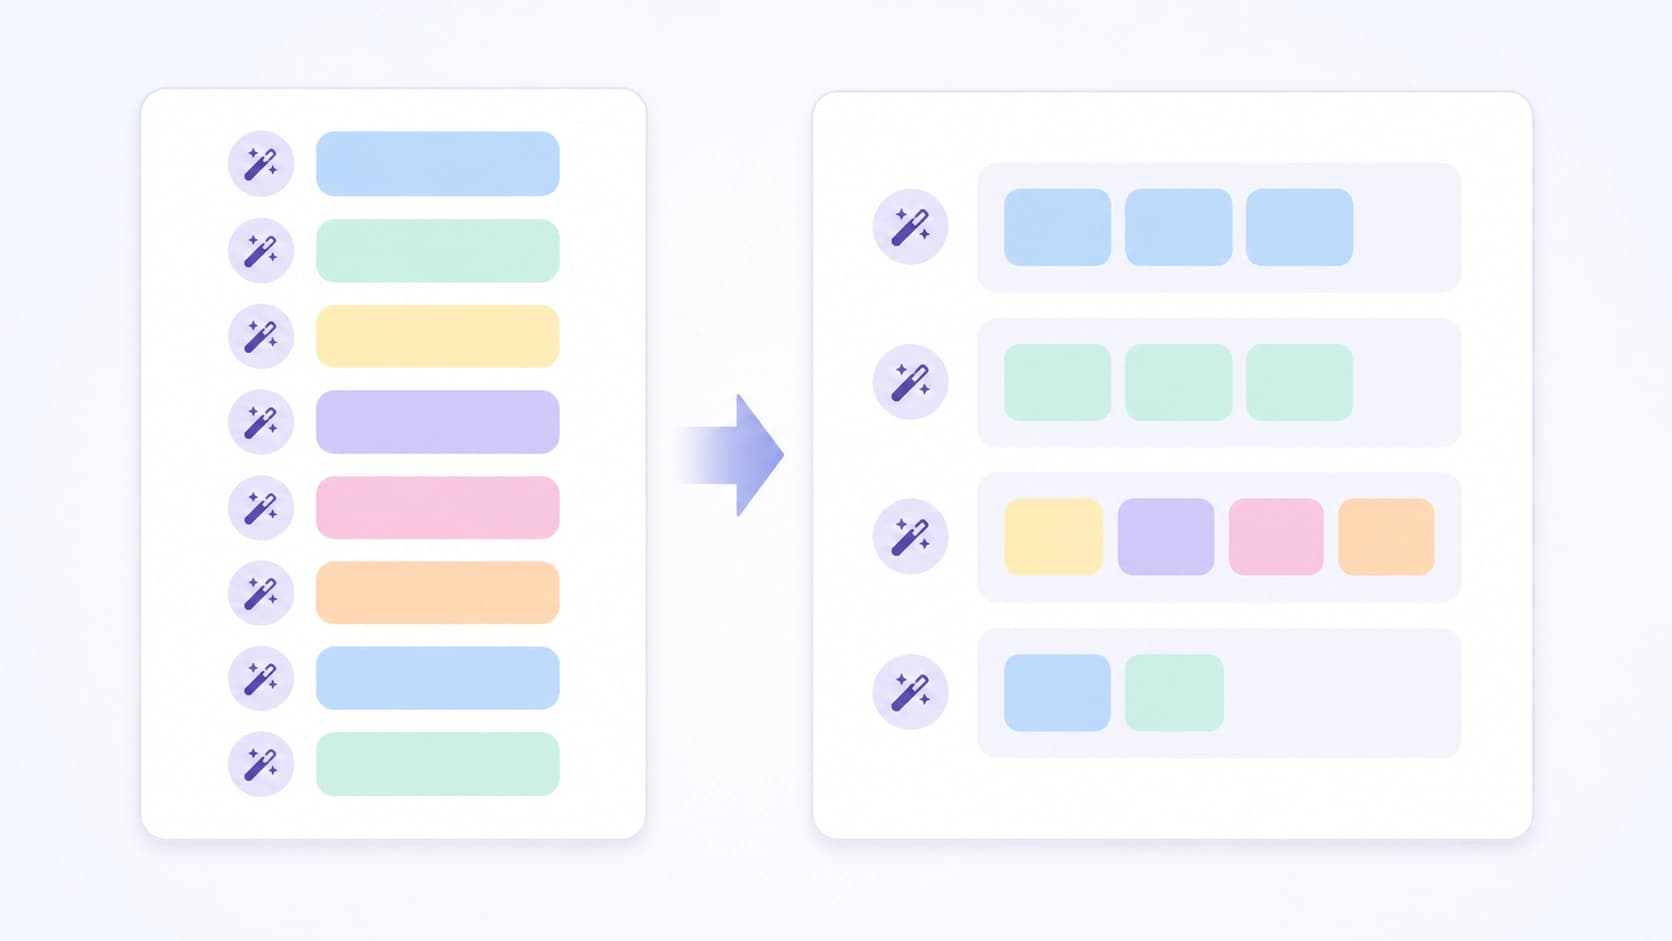
- Le nombre de tokens de raisonnement peut être réduit jusqu'à 43,2 % du volume initial — tout en préservant la précision.
- L'effet est particulièrement marqué sur les modèles plus puissants : meilleur est le modèle, plus souvent il se vérifie sans nécessité.
- Le steering par étapes surpasse nettement le steering token par token traditionnel à budgets de tokens comparables.
Les deuxième et troisième points sont liés. Un modèle puissant est plus sûr de ses étapes, donc sa réflexion se révèle plus souvent être un coup dans le vide — et le steering token par token souffre justement de ne pas savoir s'arrêter à temps.
Pourquoi c'est important au-delà du laboratoire
L'économie du raisonnement n'est pas une abstraction. Les longues chaînes gonflent les factures d'inférence, augmentent la latence et limitent le nombre de requêtes qu'on peut faire passer sur le matériel disponible. Si l'on peut retirer près de la moitié des « réflexions » sans perte de qualité, c'est une économie directe à l'échelle.
Il y a aussi une couche moins évidente. Le travail montre que le comportement du modèle peut être réglé au niveau des représentations — plus souplement et plus précisément qu'avec des prompts, et moins cher qu'avec l'affinage. La contrôlabilité devient une dimension d'ingénierie à part entière : non pas « quoi écrire dans l'instruction », mais « où décaler l'activation et à quel moment ».
Enfin, c'est une contribution à l'interprétabilité. Nous comprenons de mieux en mieux ce qui se passe réellement à l'intérieur lorsque le modèle s'arrête et se dit « voyons, je révise ».
Questions ouvertes
Les limites d'applicabilité ne sont pas encore entièrement tracées. Le steering le long d'une seule direction est un outil étroit : il capte bien l'axe de réflexion trouvé, mais on ne sait pas quoi faire des autres formes d'autocorrection. Reste aussi la question de la transférabilité de la direction trouvée entre architectures : chaque modèle a ses propres représentations, et rien ne garantit qu'un vecteur efficace pour l'un sera utile pour un autre.
Le compromis entre économie et fiabilité sur les tâches où une erreur coûte cher n'est pas non plus entièrement clair. Réduire de 43,2 % les tokens tout en préservant la précision moyenne est un résultat solide, mais la précision moyenne n'équivaut pas à l'absence de rares défaillances catastrophiques. Chercher comment distinguer la réflexion « superflue » de celle, unique, qui sauve la réponse — voilà probablement la prochaine tâche dans cette ligne de recherche.


