
Méthode Genesis Steering : pilotage par activation sur les données utilisées pour le fine-tuning
La méthode extrait un vecteur de contrôle à partir d’exemples contrastifs présents dans les données de fine-tuning et, si celles-ci ne sont pas disponibles, sélectionne des échantillons d’entraînement probables par inférence d’appartenance et constitue un jeu de données proxy. La partie théorique décrit le déplacement optimal vers la frontière de décision et l’évaluation sur des données proxy ; empiriquement, les données internes de Tülu-3-8B produisent un effet plus marqué que les jeux de données externes, tandis que l’utilité du proxy MIA sur Llama-3.1-8B-Instruct est limitée par le rapport entre les décalages directionnels.
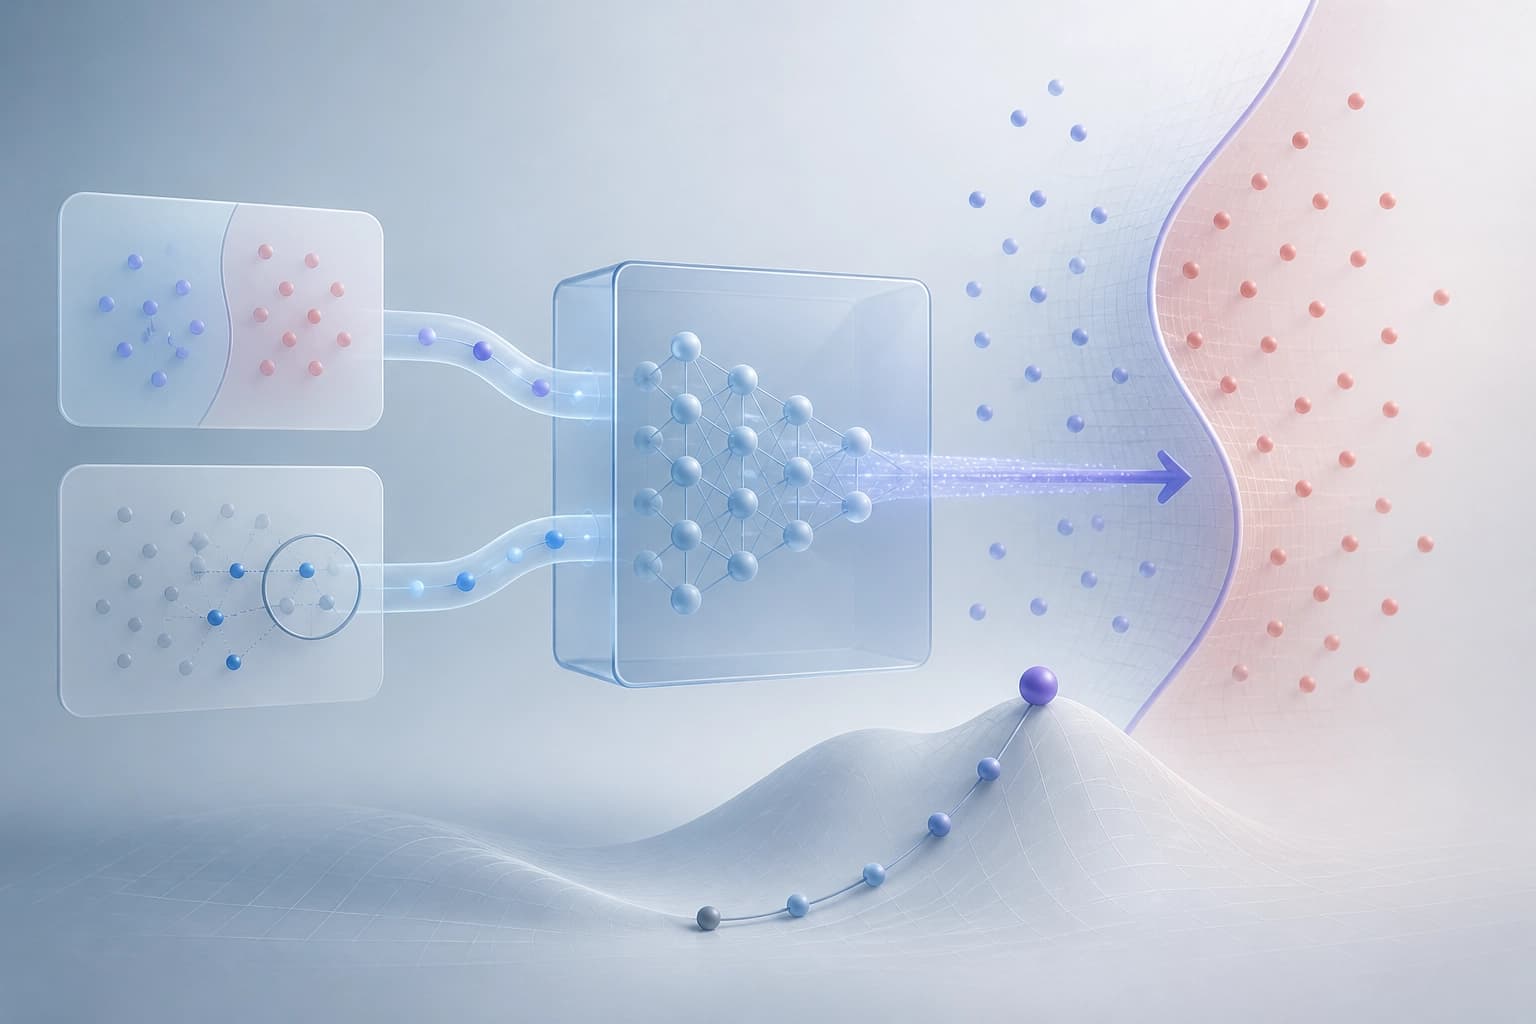
Qu’est-ce que Genesis Steering
Le pilotage des activations contrôle les grands modèles de langage pendant l’inférence. L’efficacité de la méthode dépend du choix des données de référence. Genesis steering construit un vecteur Genesis à partir d’exemples contrastifs issus des propres données de fine-tuning du modèle.
Si ces données ne sont pas disponibles, la méthode utilise des approches issues de la littérature sur l’inférence d’appartenance (membership inference). Ces approches trouvent des exemples d’entraînement probables et constituent un jeu de données proxy.
L’article « Genesis Steering: Better Activation Steering Through Training Data » a été soumis le 13 octobre 2026 (v1). Mise à jour : 19 octobre 2026 (v2). Auteurs : Tora Bodin, Eric Aubinais, Ilaria Torre, Chih-Hong Cheng.
Conclusion : Genesis steering ancre le pilotage dans les données de fine-tuning. Le paramètre clé est la source des exemples contrastifs.
Comment le vecteur Genesis est construit
La méthode extrait des exemples contrastifs des données de fine-tuning. Un vecteur de direction est construit à partir de ces exemples. Ce vecteur est appliqué au modèle pendant l’inférence.
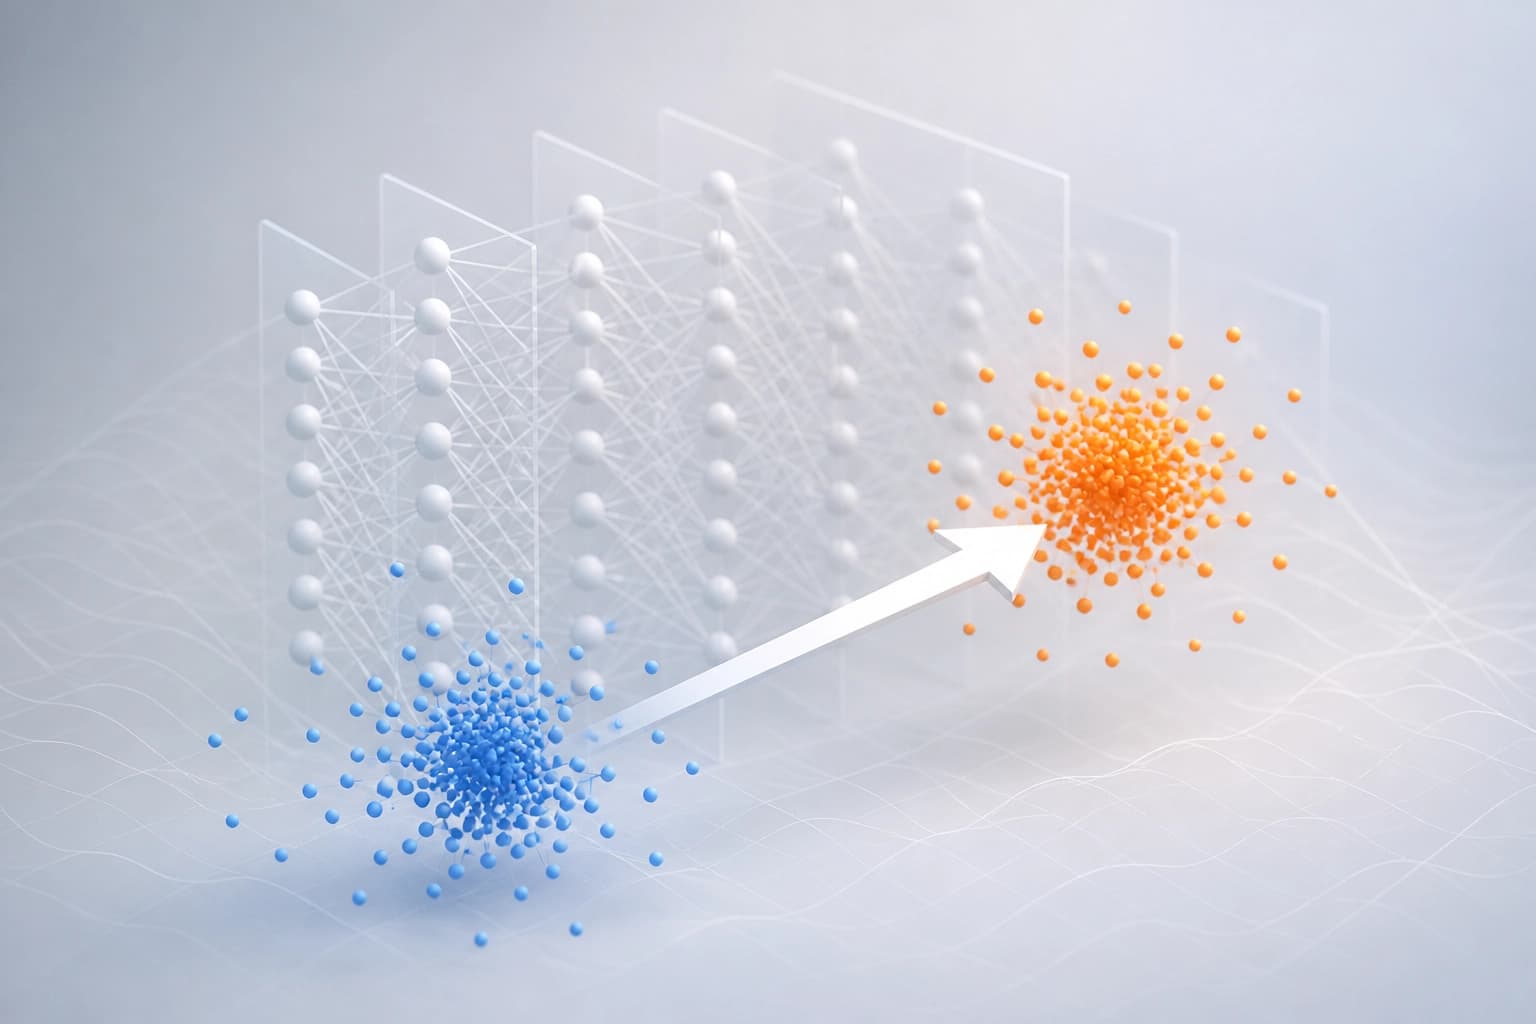
Les auteurs établissent deux résultats théoriques. Le premier porte sur le décalage optimal vers la frontière de décision. Le second porte sur la réduction du biais lors de l’évaluation sur des données proxy.
Conclusion : la théorie fournit des repères pour le décalage. La qualité du vecteur dépend du choix des exemples contrastifs.
Données proxy par inférence d’appartenance
Lorsque les données de fine-tuning ne sont pas disponibles, la méthode fait appel à l’inférence d’appartenance. Cette approche recherche des exemples d’entraînement probables. Les exemples trouvés servent à constituer un jeu de données proxy.
Le jeu de données proxy remplace les données d’origine pour construire le vecteur Genesis. La méthode utilise les exemples trouvés comme données de référence. La différence tient à la source des exemples.
Conclusion : le jeu de données proxy élargit les possibilités d’application de la méthode. Le critère d’application est l’absence d’accès aux données de fine-tuning.
Résultats des évaluations sur les modèles
Les évaluations ont été réalisées sur Tülu-3-8B et Llama-3.1-8B-Instruct. Les données de fine-tuning de Tülu-3-8B sont accessibles au public. Llama-3.1-8B-Instruct a été utilisé comme modèle de contrôle.
Les données de sécurité issues du mélange d’entraînement de Tülu-3-8B ont permis un pilotage plus efficace que les jeux de données externes. Cela vaut pour les deux modèles.
Sur Tülu-3-8B, les scores d’appartenance concordaient largement pour identifier les exemples d’entraînement. Les vecteurs construits à partir des exemples ayant obtenu les scores les plus élevés ont donné des résultats comparables à ceux de sous-échantillons aléatoires de même taille.
Les résultats sur Llama-3.1-8B-Instruct définissent une condition pour la MIA. La méthode n’aura un effet positif que si le décalage directionnel moyen des données intra-domaine filtrées par MIA est nettement inférieur à celui des données OoD.
Conclusion : les données de fine-tuning propres au modèle permettent un pilotage plus efficace que les jeux de données externes. La MIA nécessite de vérifier la condition portant sur le décalage directionnel.
Critères pratiques de sélection
Le choix de la méthode dépend de l’accès aux données de fine-tuning. Le tableau ci-dessous met en relation la situation, l’action et la vérification.
| Situation | Action | Vérification |
|---|---|---|
| Les données de fine-tuning sont accessibles | Construire un vecteur Genesis à partir d’exemples contrastifs tirés de ces données | Comparaison avec des jeux de données externes |
| Les données ne sont pas accessibles | Rechercher des exemples d’entraînement probables par inférence d’appartenance et constituer un jeu de données proxy | Vérification de la condition portant sur le décalage directionnel moyen |
| Le jeu de données proxy est constitué | Construire des vecteurs à partir des exemples ayant obtenu les scores les plus élevés | Comparaison avec des sous-échantillons aléatoires de même taille |
Conclusion : le choix de Genesis steering dépend de la disponibilité des données de fine-tuning. Pour un jeu de données proxy, il faut vérifier la condition portant sur le décalage et comparer les résultats à ceux de sous-échantillons aléatoires.
Foire aux questions
Matériaux connexes
Tous matériaux
Réparation limitée des tactiques dans Lean 4 à l’aide des diagnostics du compilateur
Un module itératif est proposé : au lieu d’écarter une tactique rejetée, il demande au modèle correcteur de la corriger jusqu’à R fois en tenant compte de l’erreur Lean ; avec K candidats, cela augmente le taux de résolution des problèmes. Les expériences menées sur LeanDojo et Lean Workbook montrent que les gains proviennent principalement de défaillances d’exécution superficielles, au prix d’un temps de recherche accru.
16 novembre 2026
Apprentissage tabulaire en contexte avec des experts clairsemés : le modèle compact OrionMoE-Small-v1.0
Un modèle de base compact pour les tâches tabulaires est présenté : il prédit de nouvelles observations à partir d’un tableau de référence annoté, sans ajustement supplémentaire des paramètres. La sélection adaptative d’experts en fonction du jeu de données et des représentations des caractéristiques offre des résultats compétitifs, en particulier avec un contexte limité et une grande dimensionnalité.
15 novembre 2026
Recherche locale des décalages de covariables pour les profils avec des prévisions peu fiables
L’article décrit un pipeline diagnostique qui identifie d’abord des groupes de patients interprétables pour lesquels le modèle affiche un faible niveau de confiance, puis vérifie la présence d’un décalage de covariables nuisible au sein de ces groupes. Lors d’expériences menées sur MIMIC-IV, avec trois tâches cliniques et trois décalages artificiels entre sous-groupes, cette approche a permis de localiser un décalage lié à l’âge, peu visible dans l’évaluation agrégée.
15 novembre 2026