
Tâches vérifiables et entraînement complémentaire sur de longues trajectoires : comment Navalia renforce les agents LLM coopératifs
Ce travail décrit un cadre qui, à partir de rapports financiers d’entreprise, construit des chaînes de calcul accompagnées de preuves traçables, les valide de manière indépendante, puis les utilise pour le SFT et le RL. Avec Qwen3.6-35B-A3B, ce pipeline améliore les performances sur cinq benchmarks et, selon les auteurs, renforce le rattachement des preuves, l’utilisation des outils et l’exécution de tâches longues, y compris dans des scénarios de bureautique.
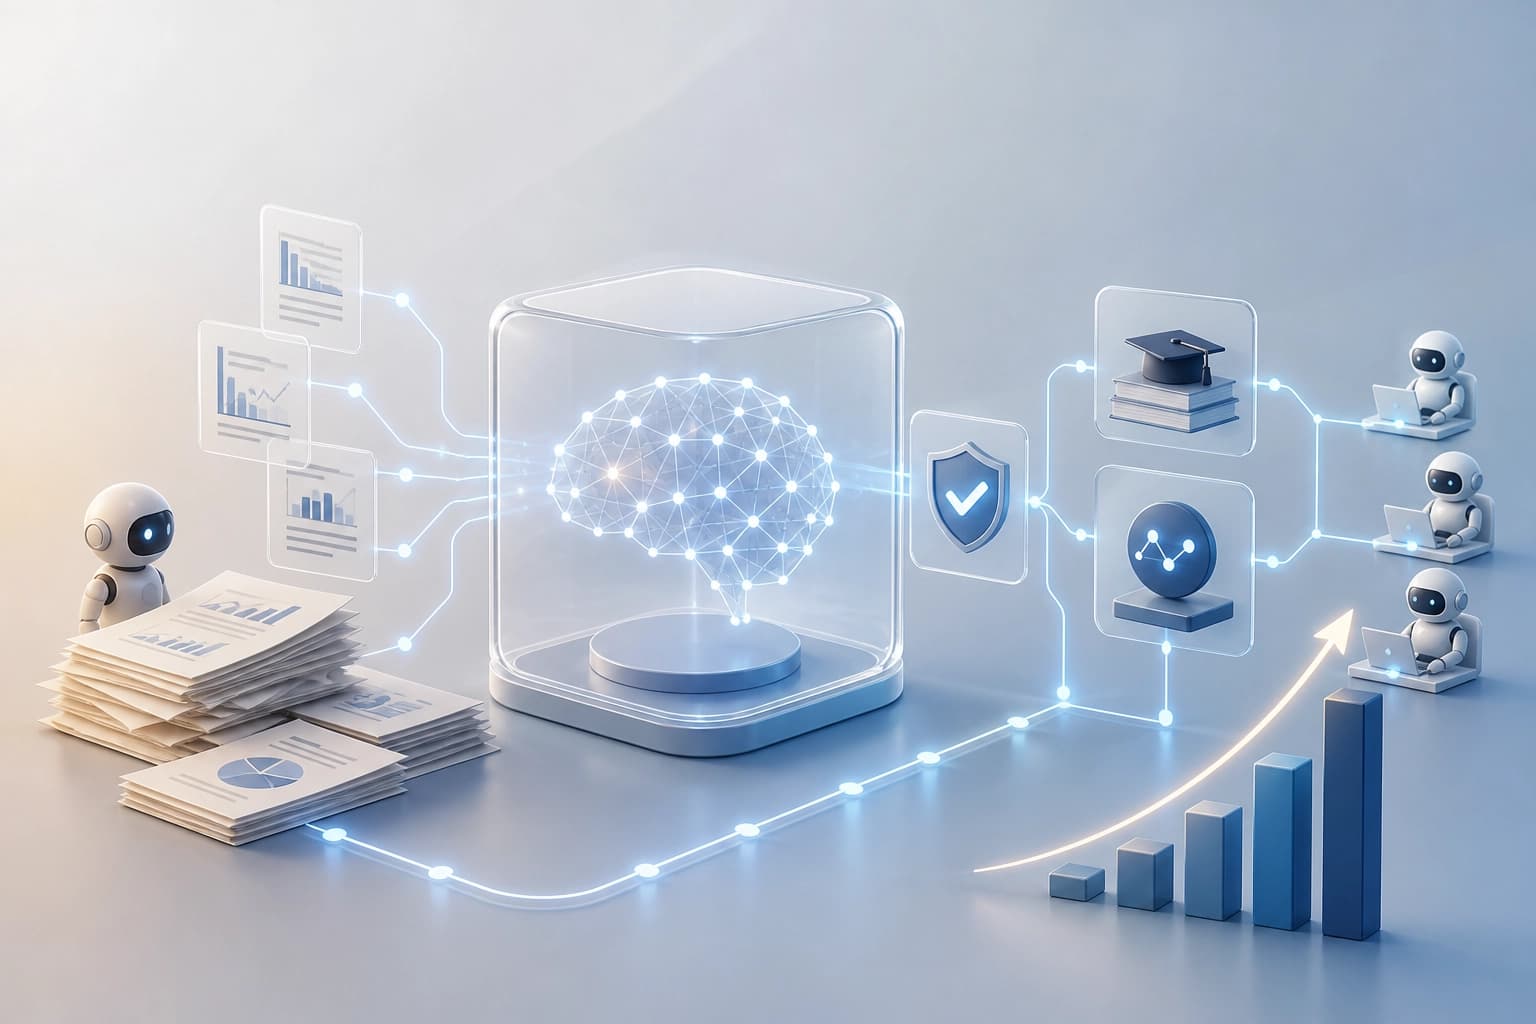
Problème résolu par Navalia
Navalia est un framework pour Cowork Agents. Il associe la synthèse de tâches vérifiables au post-entraînement sur un horizon long. Pour l’analyse financière, le framework utilise des rapports financiers d’entreprise.
Navalia sélectionne sémantiquement des éléments de preuve à l’appui parmi des ensembles complets de faits. Il construit ensuite des chaînes de calcul exécutables. Le framework crée ainsi des tâches analytiques dont les éléments de preuve sont traçables et les dépendances entre les données des différentes étapes sont factuelles.
Critère pratique : une tâche se prête à la synthèse vérifiable si ses éléments de preuve et les dépendances entre les étapes sont traçables.
Vérification des éléments de preuve et des réponses
La cohérence des éléments de preuve et l’exactitude des réponses sont vérifiées au moyen d’une vérification indépendante par LLM et de contrôles programmatiques. Il s’agit de deux circuits de contrôle distincts. Le premier évalue l’aspect sémantique, le second la conformité formelle.
Critère pratique : une tâche vérifiable nécessite à la fois une vérification par LLM et des contrôles programmatiques.
Post-entraînement sur des trajectoires longues
Les tâches vérifiées fournissent la matière nécessaire à la collecte de trajectoires. Navalia applique le fine-tuning supervisé à partir d’une initialisation à froid et l’apprentissage par renforcement. Ces deux étapes améliorent l’exécution des tâches sur un horizon long.
Le framework initialisé sur Qwen3.6-35B-A3B affiche des gains constants par rapport au modèle de base. Ces gains sont visibles sur les cinq benchmarks. Les auteurs indiquent que Navalia améliore l’intégration des éléments de preuve, l’utilisation des outils et l’exécution des tâches sur un horizon long.
Critère pratique : le post-entraînement est pertinent lorsqu’une tâche nécessite une longue séquence d’actions et l’utilisation d’outils.
Benchmarks et transfert des résultats
Navalia est évalué sur cinq benchmarks : OfficeQA Pro, FinSearchComp, Finance Agent Benchmark, APEX-Agents-AA et Workspace-Bench-Lite. Le framework affiche des gains constants par rapport au modèle de base sur les cinq benchmarks.
Les auteurs indiquent que les résultats se transfèrent à des scénarios Cowork plus larges, notamment aux tâches générales de bureau. Critère pratique : vérifier le transfert des compétences au-delà de l’analyse financière. Les tâches générales de bureau sont un signe d’une applicabilité plus large.
Foire aux questions
Matériaux connexes
Tous matériaux
IA physique : limites du concept, outils et difficultés
Cette monographie de 388 pages rassemble dans un cadre unifié les définitions de l’IA physique, ses différences avec les domaines connexes et ses principales méthodes — de la perception et de la simulation au contrôle et aux systèmes multiagents coordonnés. Elle offre une cartographie des défis de recherche et des limites qui freinent le passage de solutions spécialisées à des systèmes capables d’une généralisation étendue.
17 novembre 2026
Agents LLM en production : taxonomie, architecture et limites du déploiement
L’article synthétise les recherches sur l’utilisation des grands modèles de langage dans les agents de production : il met en évidence les obstacles, les niveaux de capacité et une architecture à quatre couches. Il permet de comprendre quels scénarios du cycle de vie sont déjà étudiés et où subsistent des lacunes pour une planification autonome fiable.
17 novembre 2026
Approche OWP : redistribution des éléments de preuve et des signaux a priori dans Omni-LLM
Le framework Omni-Woodpecker, qui ne nécessite aucun entraînement, détecte les conflits entre les modalités et ajuste, avant le décodage, l’équilibre entre les données contextuelles et les a priori mémorisés dans les états cachés. Sur Qwen2.5-Omni-7B et VideoLLaMA2-AV, la méthode améliore la robustesse face aux erreurs audiovisuelles sur CMM et AVHBench, et apporte un gain modéré sur les benchmarks généraux de raisonnement.
17 novembre 2026