
Le vecteur moléculaire comme infrastructure
En chimie computationnelle, l'embedding d'une molécule a depuis longtemps cessé d'être un détail technique. C'est une infrastructure réutilisable : une même représentation vectorielle sert à la fois à la prédiction des propriétés d'un composé, au criblage virtuel et à la recherche de molécules similaires. Calculée une fois, elle s'applique à une dizaine de scénarios, du classement de bibliothèques à la sélection de candidats pour le laboratoire.
L'impasse d'une seule représentation
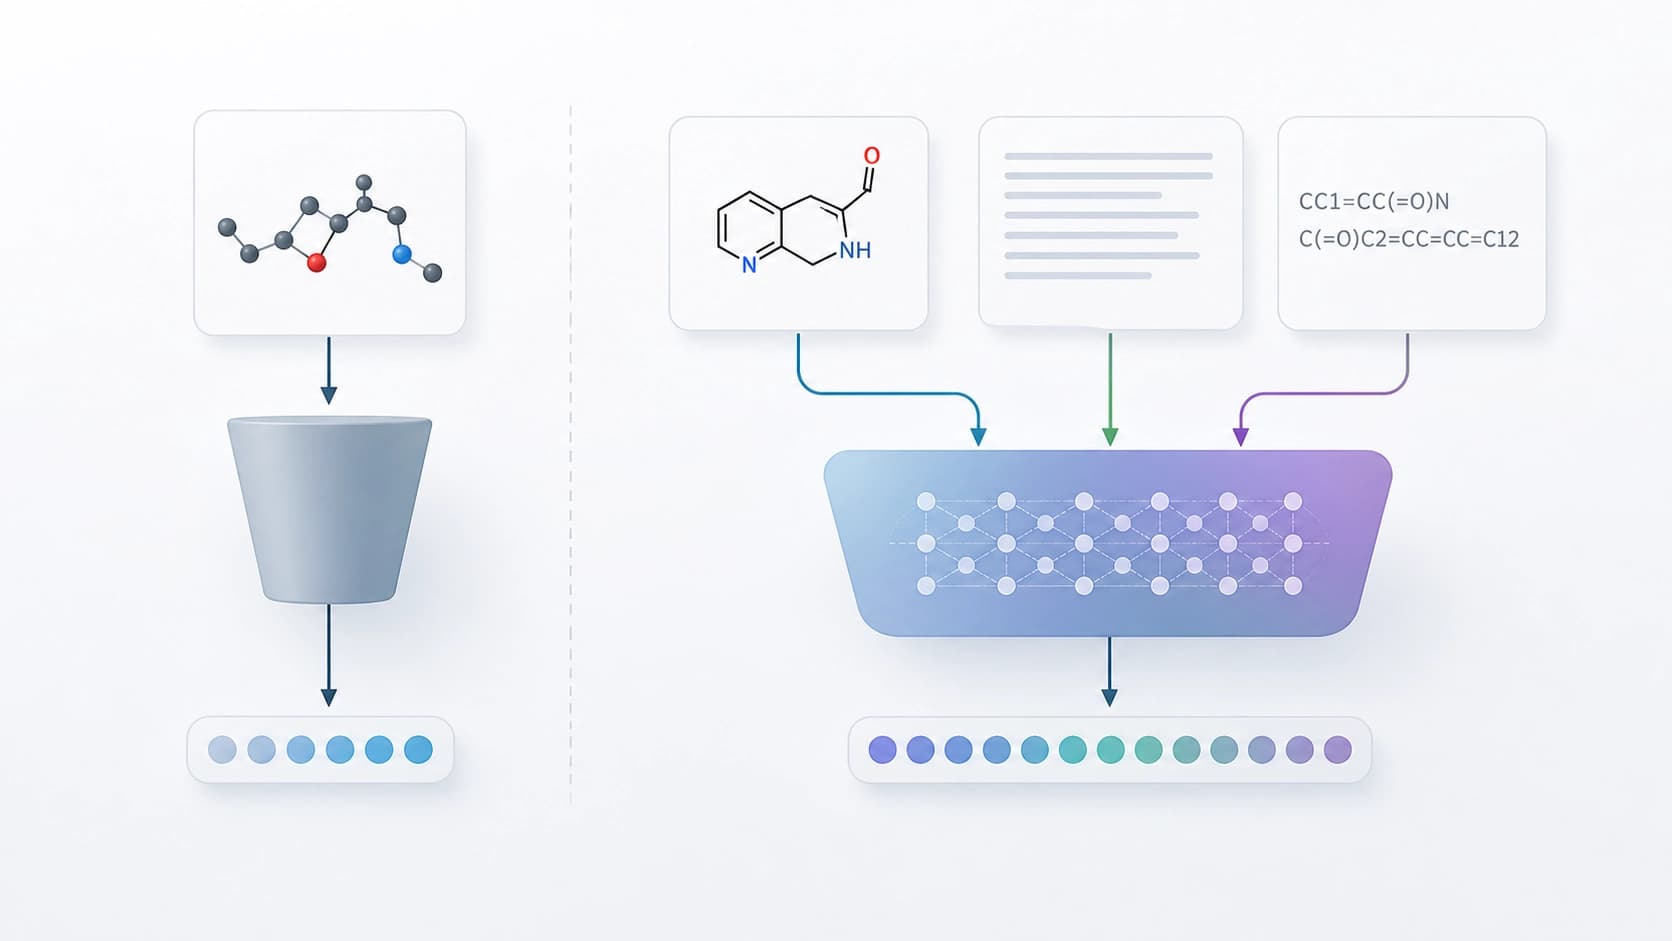
Presque tous les encodeurs moléculaires reposent sur un même schéma : on choisit une modalité unique — graphe d'atomes, chaîne SMILES, ensemble de descripteurs physico-chimiques ou conformation 3D — et le modèle est entraîné strictement sur celle-ci. Le vecteur obtenu en sortie est inconditionnel. Il n'existe aucun interface permettant d'affiner la requête : « il me faut un analogue par mécanisme d'action, pas par squelette carboné » ou « un composé similaire, mais orienté vers la solubilité ».
Il en découle un effet désagréable. Une même molécule est perçue différemment par différents modèles, et leurs représentations ne peuvent pas être comparées directement — les espaces ne sont pas alignés. Le chimiste doit donc garder en tête quel encodeur convient à quelle tâche, au lieu de simplement formuler la tâche en mots.
La question posée par les auteurs
Le travail de Xinjian Zhao, Xiangru Jian, Yaoyao Xu, Xiaozhuang Song, Wei Pang, Lei Bai et Tianshu Yu (arXiv:2608.23646, 24 août 2026 ; présenté au workshop FM4LS dans le cadre d'ICML 2026, non-archival) part précisément de cette insatisfaction. Les chercheurs se demandent : pourquoi construire un encodeur distinct pour chaque représentation d'une molécule, alors que les LLM multimodaux savent déjà traiter nativement des images, du texte et des notations symboliques ?
La logique est simple. Si le modèle « voit » déjà l'image d'une formule structurale, lit une description et analyse un SMILES, on peut le transformer non pas en assistant-conseil, mais en générateur de vecteurs. Et qui plus est, de vecteurs conditionnés — dépendant non seulement de la molécule elle-même, mais aussi de ce qu'on lui demande à son sujet en langage naturel.
Comment le framework est structuré
MolEmb est une surcouche légère, et non un nouveau grand modèle. Elle adapte une MLLM existante pour que les profils moléculaires et leurs descriptions textuelles se retrouvent dans un espace d'embeddings commun. L'élément clé est un objectif contrastif bidirectionnel : il rapproche les paires « molécule — texte » et éloigne simultanément les paires non correspondantes.
Pourquoi c'est plus important qu'il n'y paraît
L'apprentissage contrastif résout ici deux problèmes à la fois. Premièrement, il définit un système de coordonnées commun : le vecteur d'une molécule et le vecteur de sa description deviennent comparables. Deuxièmement, il permet une recherche cross-modale dans les deux sens — trouver un texte à partir d'une molécule, trouver une molécule à partir d'un texte — et ce au sein d'un même espace, sans traducteurs intermédiaires entre modalités.
Le résultat annoncé est plus modeste qu'un « on a battu tous les benchmarks », et c'est ce qui le rend plus crédible : les représentations obtenues sont compétitives pour la prédiction des propriétés moléculaires tout en prenant en charge la recherche entre modalités. Autrement dit, l'interface en langage naturel n'a pas été acquise au prix d'une dégradation des tâches classiques.
Le langage comme levier de contrôle
La principale différence avec les encodeurs traditionnels réside dans le conditionnement. Un modèle spécialisé produit pour une molécule un vecteur unique et figé. Le framework, lui, permet de formuler une condition en mots et d'obtenir une représentation décalée vers cette condition. Une même molécule peut être représentée différemment selon que vous vous intéressez à la toxicité, à la solubilité ou à la proximité avec une classe de composés donnée.
Une recherche moléculaire dépendante du contexte
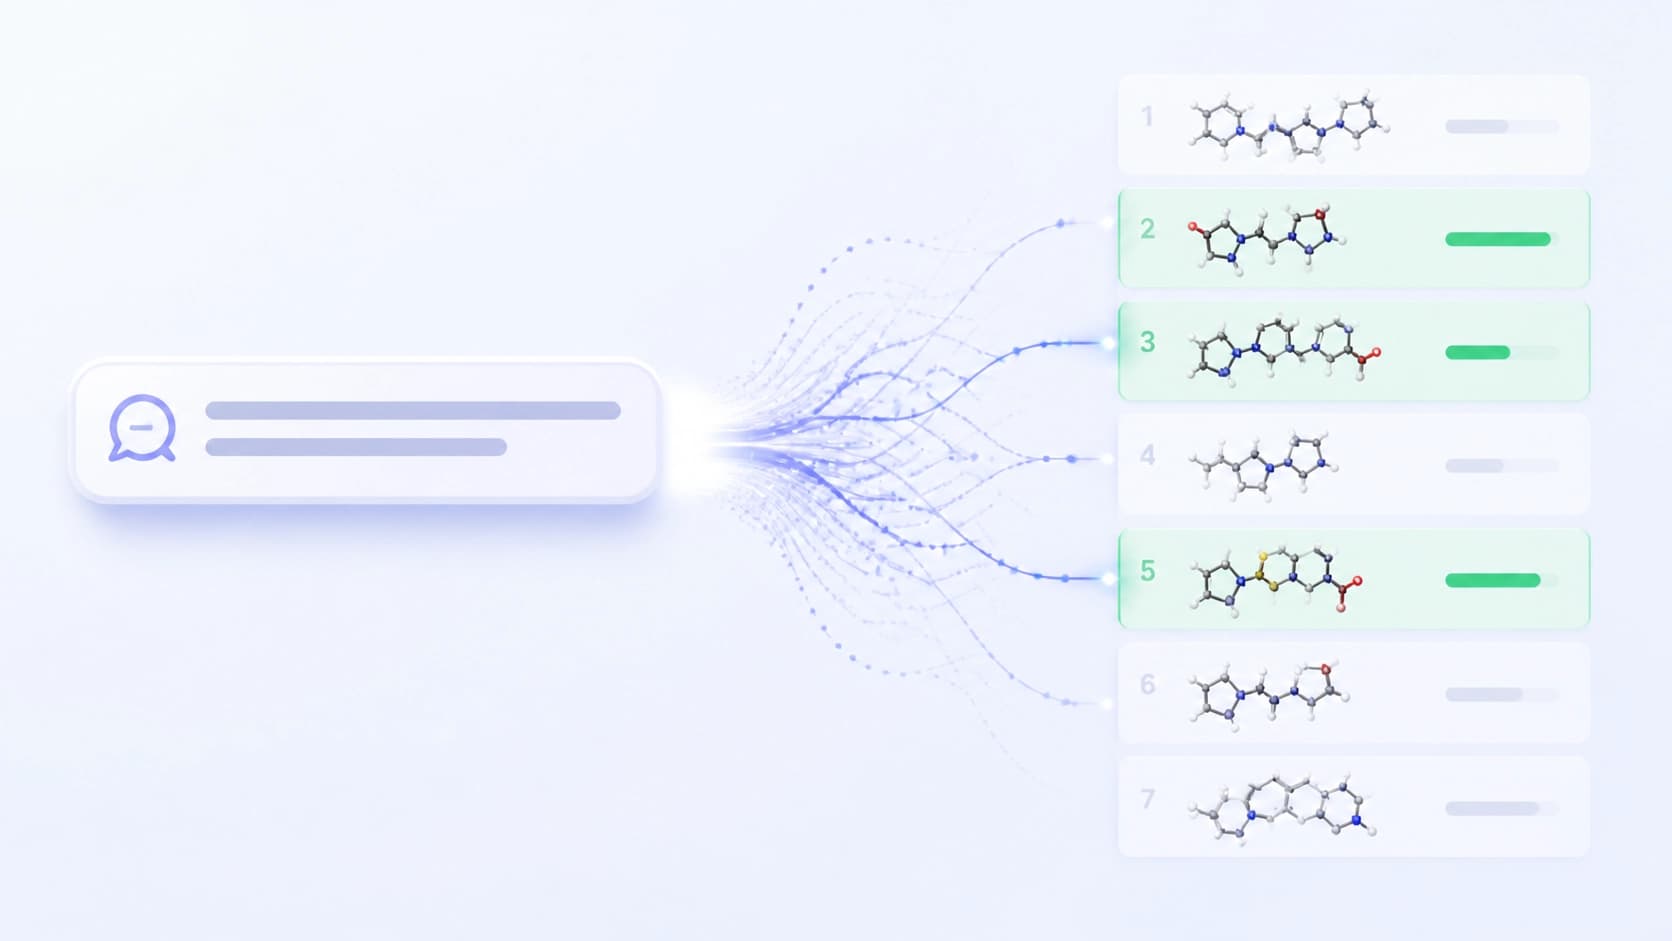
Une partie distincte du travail est le benchmark diagnostique MolCAR. Il a été créé pour tester la recherche dépendante du contexte, c'est-à-dire les situations où la bonne réponse change selon la formulation de la requête. C'est fondamentalement plus difficile que la recherche classique de structures similaires : ici, la référence dépend de l'énoncé du problème.
La conclusion la plus intéressante
L'observation la plus précieuse des auteurs sonne presque comme une banalité : un embedding moléculaire dépendant du contexte est avant tout une propriété des données de supervision, et non une astuce architecturale. En d'autres termes, le modèle commence à distinguer les contextes non pas parce qu'on y a intégré un module astucieux, mais parce qu'on l'a entraîné sur des paires où le contexte diffère réellement.
La conclusion est à la fois dégrisante et utile. Elle déplace l'attention de la course aux architectures vers la qualité et la structure des données d'entraînement : si les descriptions des molécules dans le jeu de données sont uniformes, aucune multimodalité ne dotera le modèle d'une sensibilité aux nuances de la requête.
Ce que cela change en pratique
Si une telle approche passe à l'échelle, le gain se présente ainsi :
- Une infrastructure unifiée au lieu d'un zoo d'encodeurs. Un seul modèle couvre à la fois les propriétés, la recherche et les requêtes cross-modales.
- Une requête en mots au lieu du choix d'un modèle. L'utilisateur n'a pas besoin de savoir quel encodeur convient le mieux à son cas.
- Des espaces compatibles. Les vecteurs de molécules et de textes cohabitent, ce qui signifie qu'on peut les comparer et les combiner.
- La réutilisation de MLLM existantes. Le framework adapte un modèle existant au lieu de l'entraîner de zéro.
Limites et questions ouvertes
Le travail est marqué comme non-archival, ce qui signifie qu'il s'agit plutôt d'une direction que d'un produit fini. Bien des questions subsistent : dans quelle mesure l'approche est-elle robuste en dehors des jeux de données testés, comment se comporte-t-elle sur des classes de composés rares, la partie linguistique ne commence-t-elle pas à dominer la partie chimique, et cela ne transforme-t-il pas le vecteur en un résumé du texte plutôt qu'en une représentation physiquement pertinente.
Néanmoins, l'idée principale s'énonce clairement. Les LLM multimodaux ne sont pas seulement des assistants chimiques ni seulement des générateurs de réponses. Ils prétendent au rôle de mécanisme général d'embeddings moléculaires : extensible, pilotable par les mots et ouvert à un affinage pour de nouvelles tâches.


