
Problème : la trace d'un agent est un journal, pas un modèle de comportement
Un agent LLM multi-étapes laisse derrière lui une longue traînée : appels d'outils, raisonnements intermédiaires, corrections, nouvelles tentatives. Le lire à l'œil nu n'a presque aucun sens — des centaines de lignes de texte où le signal utile est dilué dans l'ensemble du volume. Pour le développeur qui met un agent en production, ce journal se transforme en boîte noire : impossible de savoir où exactement l'exécution a mal tourné, ni quels états sont réellement typiques du système.
C'est précisément le sujet du travail arXiv:2608.23670 (cs.AI) « Automata from Agent Traces: Failure and Next-Step Prediction » — ses auteurs Seonglae Cho, Franklin Cardenoso Fernandez, Umar Mohammed, Zekun Wu, Kleyton Da Costa, Ilham Wicaksono et Adriano Koshiyama proposent de considérer les traces non pas comme du texte, mais comme des données sur les transitions entre états. La logique est simple : si le comportement de l'agent se répète d'une exécution à l'autre, alors il y a une structure derrière le chaos apparent, et elle peut être reconstruite.
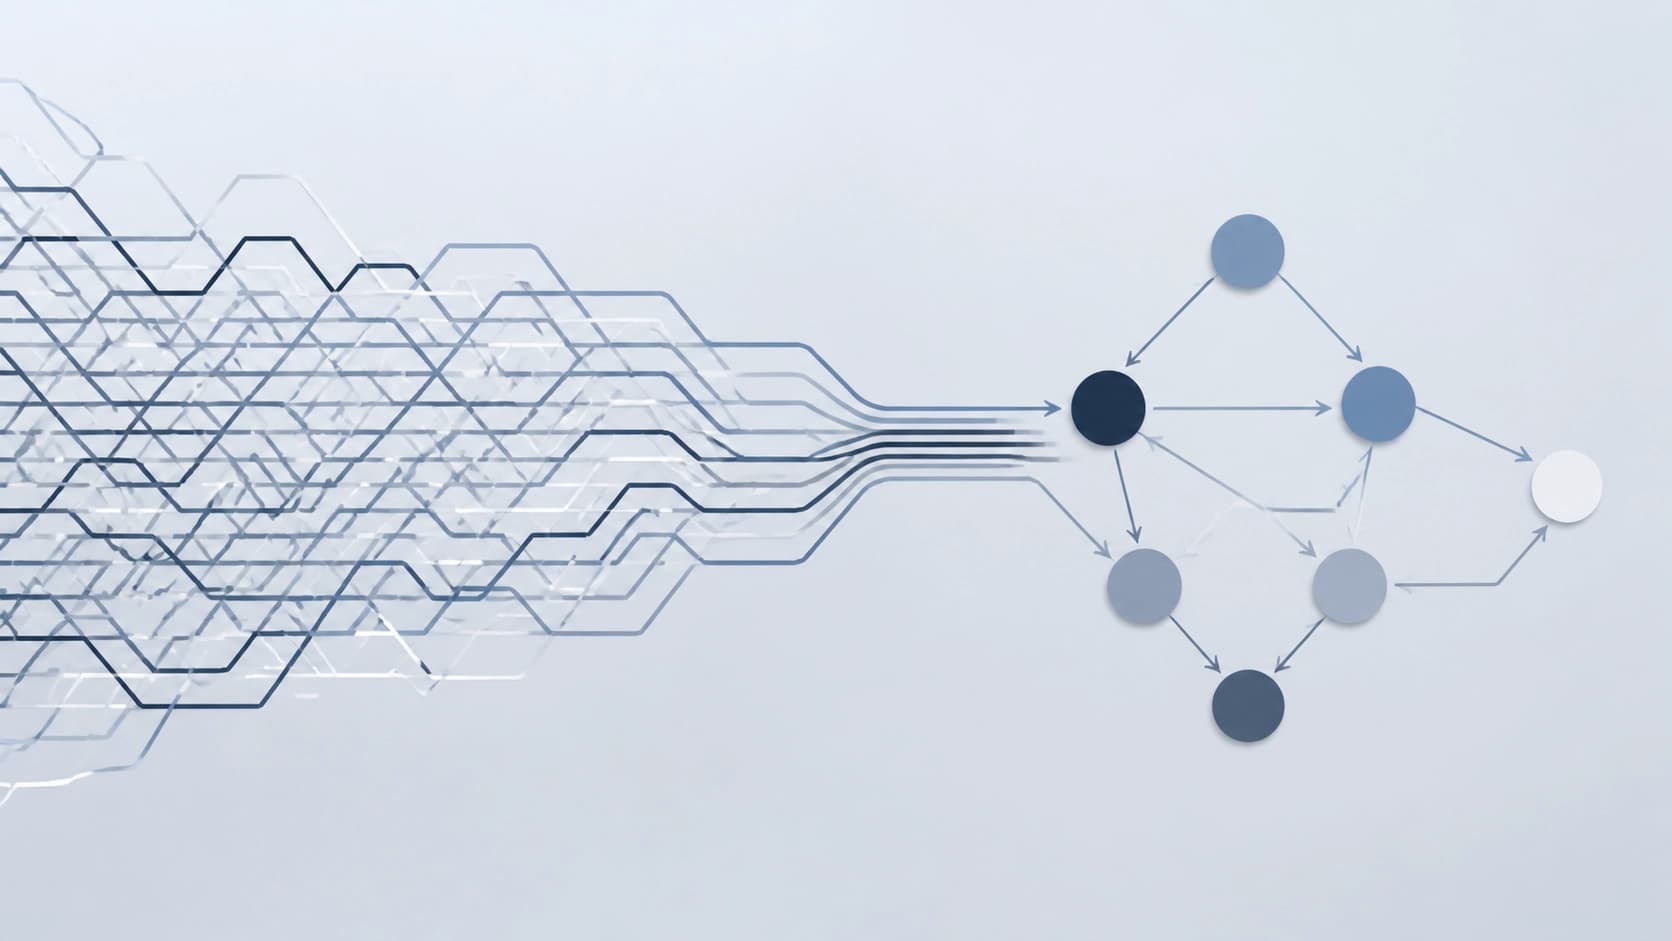
Il convient de souligner séparément ce qui manquait aux approches précédentes. L'analyse était généralement menée sur une seule trace à la fois, ou bien s'appuyait uniquement sur les exécutions réussies. Dans les deux cas, on perd la vue d'ensemble — cette topologie qui relie entre elles la prédiction de l'action suivante et la prédiction de l'échec. Or c'est précisément elle qui est nécessaire, tant pour l'audit de sécurité que pour la surveillance en temps réel.
Un seul automate pour tout le corpus
L'idée de la méthode : prendre l'ensemble des traces et le réduire à une unique machine à états finis (FSM) compacte. Pas un arbre de décision par exécution, pas des embeddings quelque part dans un espace vectoriel, mais un graphe ordinaire avec des états et des transitions — ce substrat structurel même qui rend le comportement de l'agent sinon prévisible, du moins descriptible.
Les résultats sur douze jeux de données publics sont encourageants :
- les automates obtenus sont petits — de 7 à 43 états, c'est-à-dire qu'on peut réellement les dessiner et en discuter en visio ;
- sur des données de validation, ils reproduisent les traces avec un fitness d'au moins 0,997 — une correspondance presque parfaite ;
- la topologie construite sur différents découpages d'un même jeu de données s'avère pratiquement identique ;
- l'assemblage lui-même prend des millisecondes, et non des heures d'entraînement.
Ce dernier point est plus important qu'il n'y paraît. Une méthode qui se construit instantanément peut être reconstruite après chaque modification du prompt ou de la configuration — et l'on voit immédiatement si le comportement du système a changé.
Pourquoi ce n'est pas qu'une jolie visualisation
La compacité n'est pas ici une fin en soi. Quand vous avez 20 états au lieu de milliers de lignes de texte, vous pouvez raisonner sur les modes de fonctionnement de l'agent : voici la boucle « essayé — erreur reçue — répété », voici la branche « la tâche est partie en questions de clarification », voici un état rare dont presque aucune sortie ne mène. Ensuite, on peut travailler sur ces modes de façon ingénierie — par exemple, construire des caractéristiques calculées pour chaque état.
Prédiction de l'étape suivante : l'état compte plus que la mémoire
Pour prédire l'action suivante de l'agent, les auteurs utilisent le contexte d'état de la FSM. Et cette approche surpasse Agent Workflow Memory sur chaque jeu de données où l'annotation est cohérente avec le déroulement réel de l'exécution. Autrement dit, savoir « dans quel mode se trouve actuellement l'agent » s'avère plus utile que la mémoire accumulée des épisodes de travail passés.
Il y a ici une nuance intéressante. Le contexte d'état n'est pas un simple numéro de nœud, mais une description condensée de ce qui s'est déjà produit et de ce qui se produira ensuite avec quelle probabilité. On obtient une sorte de carte des continuations probables, construite non pas sur la sémantique du texte, mais sur les statistiques de transition. En pratique, cela signifie que le prédicteur de l'étape suivante peut être entraîné moins cher : il n'a pas besoin d'accéder aux états cachés du modèle, la structure suffit.
Prédiction de défaillance et surveillance sur trace partielle
La seconde moitié du travail porte sur le diagnostic. Les caractéristiques calculées sur les états individuels de l'automate donnent un AUROC allant jusqu'à 0,94 sur des données de validation. Autrement dit, un modèle qui ne sait rien des rouages internes du LLM distingue, à partir de caractéristiques comportementales, les exécutions qui se termineront par un échec de celles qui iront jusqu'au bout.
Le plus pratique ici, c'est le moniteur en ligne. Il observe une trace incomplète et classe les exécutions défaillantes au-dessus des réussies, sans attendre la fin. Cela suffit pour déclencher un arrêt précoce bien avant que l'agent ne s'égare définitivement : économiser des tokens, du temps et, plus important encore, l'empêcher de nuire. Pour les agents qui écrivent dans des bases de données, appellent des API de paiement ou gèrent de l'infrastructure, une telle possibilité d'interrompre l'exécution en cours de route n'est pas un luxe, mais une exigence.
Conclusion principale : le comportement est déterminé par l'enveloppe, pas par le modèle
Le thèse sans doute la plus provocante de l'article se formule ainsi : la topologie comportementale de l'agent est largement déterminée non pas par le modèle de langage lui-même, mais par le deployment harness — cette enveloppe dans laquelle le modèle est exécuté. Le gabarit de prompt, l'ensemble d'outils, les règles de gestion des erreurs, les limites de pas — voilà ce qui façonne le graphe de transitions.
Il en découle plusieurs conclusions. Premièrement, remplacer le modèle par un autre avec la même enveloppe peut ne pas modifier radicalement la structure du comportement — et donc, l'automate construit sur un modèle mérite d'être vérifié sur un autre. Deuxièmement, il est souvent plus efficace d'améliorer l'agent par des changements dans le harness que par une mise à niveau des poids. Troisièmement, on obtient une primitive structurelle model-agnostic : la même approche convient pour l'audit de sécurité et pour la surveillance à l'exécution, indépendamment de l'API que vous appelez.
Ce qu'il faut garder à l'esprit
L'approche n'exclut pas la prudence. Douze jeux de données, c'est encore un échantillon limité, et un fitness de 0,997 indique à quel point l'automate décrit bien les traces déjà collectées, et non qu'il prédira le comportement du système dans un environnement inconnu. Le fort AUROC pour la prédiction de défaillance est lui aussi obtenu sur des tâches précises : dans de nouveaux domaines, les caractéristiques devront être recalculées.
Et pourtant, la direction semble saine. Au lieu d'augmenter sans fin la fenêtre de contexte en espérant que le modèle « se débrouillera tout seul », on peut construire une fois un modèle compact du comportement de son enveloppe — puis s'en servir comme schéma : voir où l'agent se bloque, quels états mènent à l'échec, et ce qui changera si l'on corrige la configuration. L'automate n'est pas plus intelligent que le LLM, mais il est plus honnête : on peut le contenir entièrement dans sa tête, et c'est déjà la moitié du succès en débogage.


