
En bref : où ça fait mal
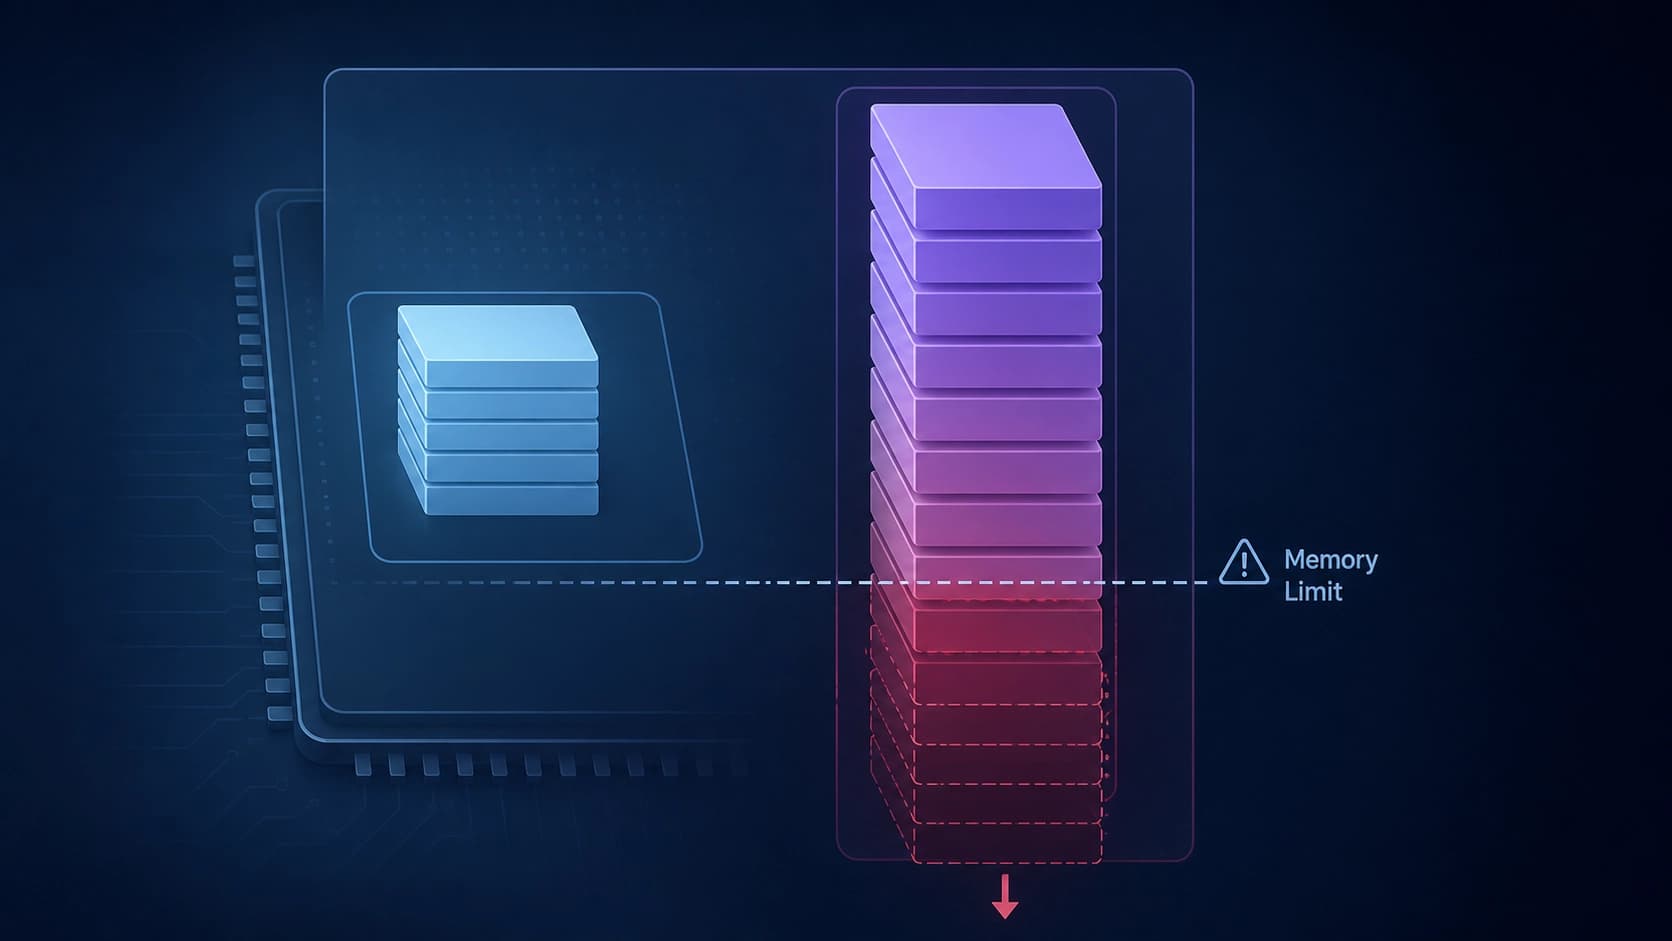
Quand un modèle à long contexte traite une requête, les principaux coûts ne viennent pas des poids, mais du cache KV — les clés et valeurs sauvegardées pour tous les tokens déjà lus. Plus le document ou le dialogue est long, plus il faut garder de tenseurs en mémoire et plus il faut relire de données à chaque étape de génération. D'où le dilemme classique : soit tronquer le contexte, soit le payer en mémoire et en vitesse d'inférence.
Les solutions existantes choisissent généralement l'un des deux extrêmes. Soit elles compressent tout l'état d'un coup, au risque de perdre l'information récente, justement celle qui est nécessaire pour la réponse suivante, soit elles gardent tout en précision d'origine et se heurtent à la capacité de l'accélérateur.
C'est précisément dans cette impasse que tente de s'insérer le travail dont il est question ci-dessous.
Ce que proposent les auteurs
L'article « Minima-KV: Retention-Preserving KV Cache Compression with Mixed-Format Paged Attention » a été soumis sur arXiv le 24 août 2026 sous le numéro 2608.23834, rubrique cs.AI, 13 pages et 3 figures, DOI 10.48550/arXiv.2608.23834. Les auteurs sont Sergii Kozyrev et Davyd Maiboroda de Minima AI, Inc. Détail curieux : dans le bloc de lien vers le PDF sur la page du preprint, la légende renvoie au premier auteur « et à deux autres », alors que la description bibliographique n'en liste que deux. Un détail, mais qui rappelle qu'il vaut mieux vérifier les métadonnées des preprints.
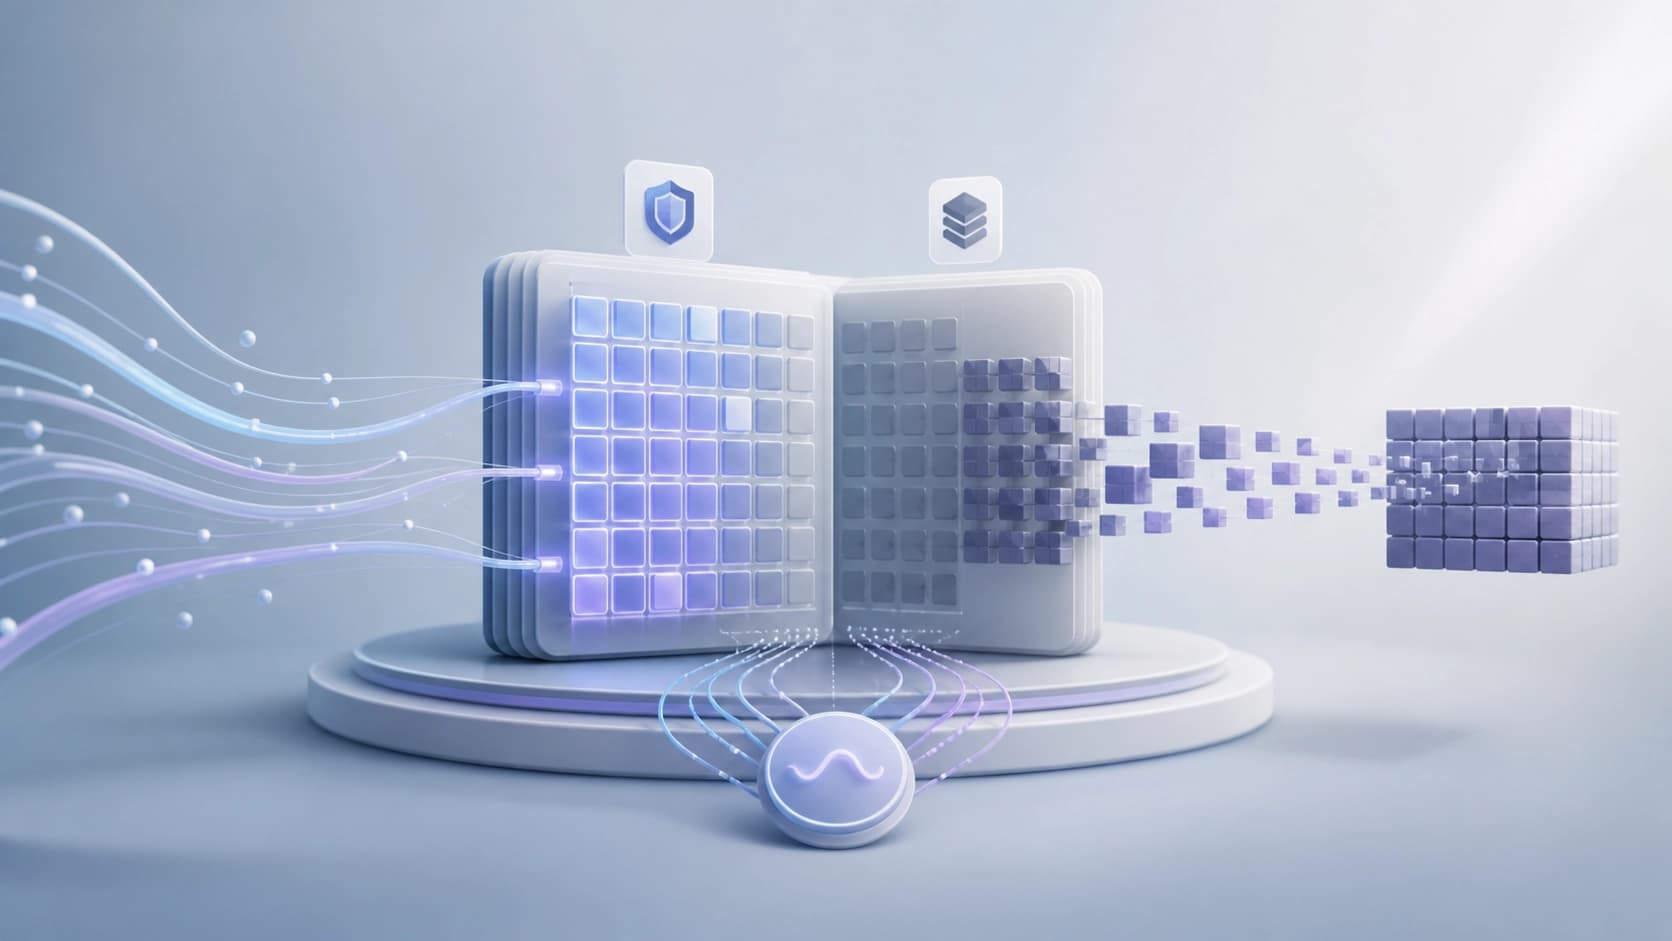
L'essence de la proposition de Minima-KV est une hiérarchie de pages du cache KV, où différentes pages sont stockées dans différents formats numériques. Le mot clé du titre — retention-preserving, c'est-à-dire « préservant la rétention » : l'état des requêtes récentes n'est évincé nulle part.
Des ancres en FP8, une archive en TQ3
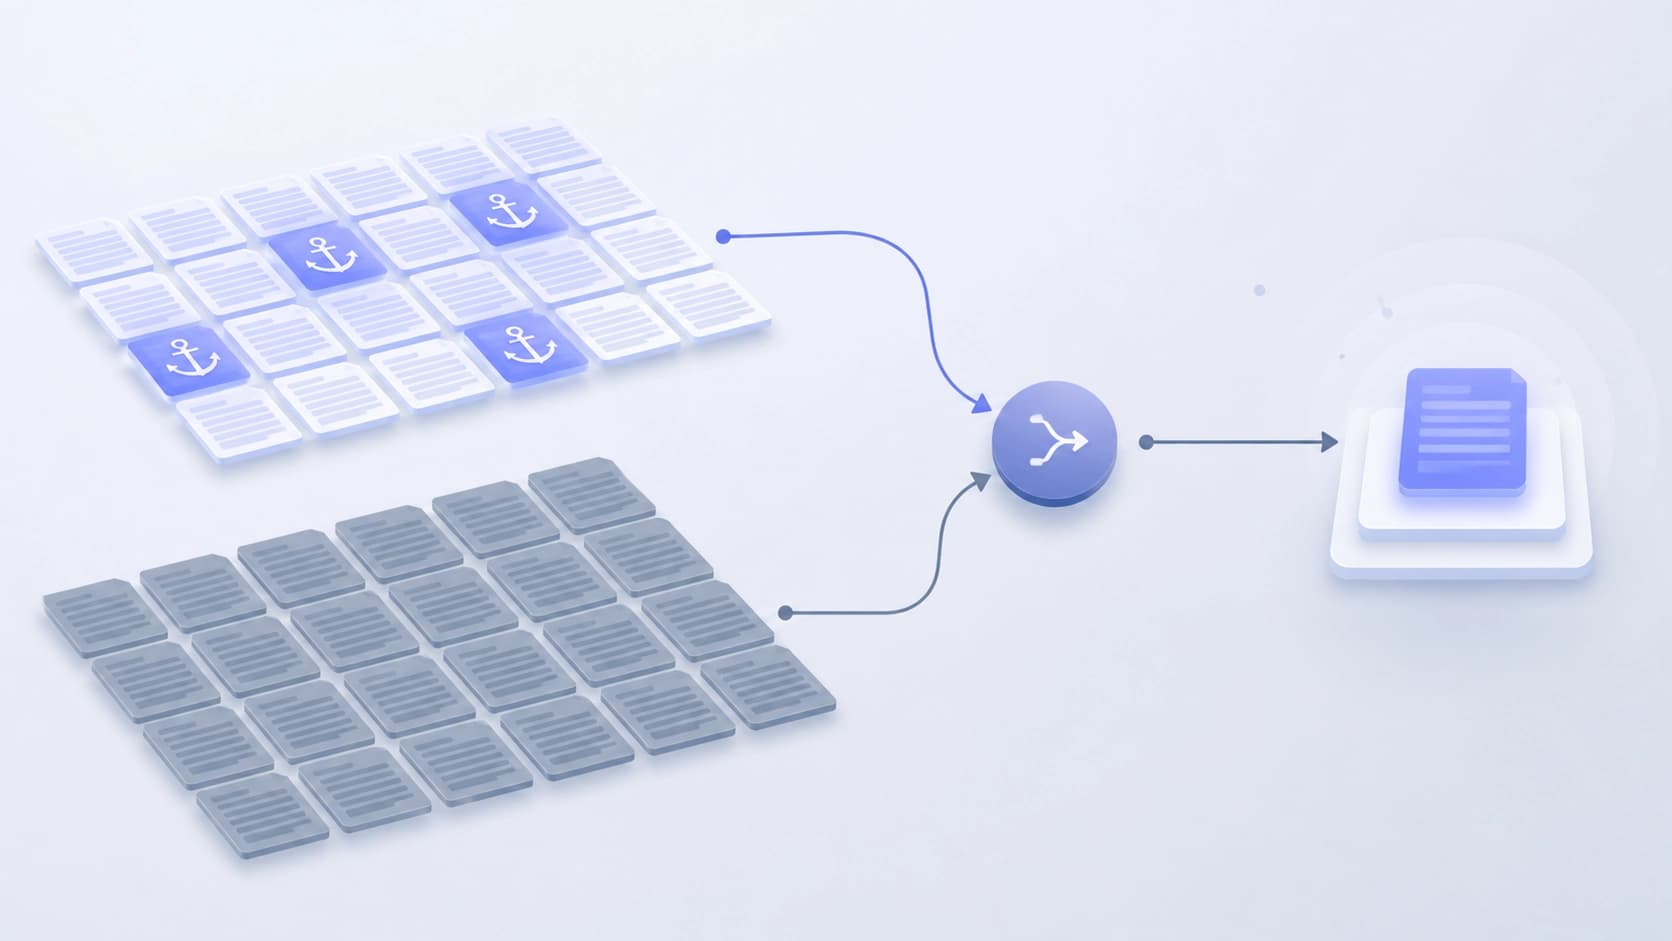
La logique de séparation est simple. Les pages récemment utilisées et marquées comme protégées (anchor) restent en FP8. Les pages plus anciennes, non retenues comme ancres, sont converties en packed TQ3 — un format empaqueté plus dense. Chaque page d'une requête vivante reste néanmoins adressable directement : rien n'est jeté de l'espace d'adressage ni remplacé par une copie approximative.
Comment les résultats partiels sont assemblés
Le plus intéressant, c'est l'arithmétique. Des noyaux distincts pour chaque format calculent leurs états d'attention partiels, puis sont fusionnés via un online-softmax merge globalement normalisé. En clair : au lieu de ramener toutes les pages à un seul type avant le calcul, le système calcule la contribution de chaque groupe dans son propre format et additionne correctement les résultats normalisés.
Grâce à cela, le décodage s'effectue directement sur un cache hétérogène, sans ce qu'on appelle une ombre dense — une copie complète du cache dans un format unique, qui annulerait toute l'économie de mémoire.
Ce que montrent les mesures
Mémoire et compression
Les mesures ont été effectuées sur des profils liés à une configuration précise du modèle Qwen3.6-27B sur un seul accélérateur NVIDIA RTX PRO 6000 Blackwell avec 96 Go de mémoire. On obtient 18,3 Kio de KV d'attention par token vivant. Cela représente un facteur de compression de 3,50x par rapport au BF16 et de 1,75x par rapport au FP8.
Le second chiffre est plus important qu'il n'y paraît à première vue. La comparaison avec le FP8 montre que le gain ne provient pas seulement du passage de la demi-précision à des formats plus économes, mais bien du schéma de stockage hybride.
Qualité sur long contexte
Le profil matérialisant — celui où les pages hybrides sont réellement déployées en tenseurs — a coïncidé avec son contrôle dense sur les tâches RULER needle-in-a-haystack à 16K. Autrement dit, sur la recherche d'une aiguille dans une botte de foin, aucune différence n'a été détectée.
Ensuite commencent les compromis. Sur le jeu LongBench v2 de 503 questions, les deltas se sont révélés négatifs : -0,80 point de pourcentage à 16K, -0,60 à 32K et -0,40 à 64K. Remarquez la forme de la courbe — les pertes ne croissent pas linéairement avec la longueur du contexte, mais fluctuent légèrement. Les auteurs n'en donnent pas d'explication, mais le fait mérite d'être gardé en tête lors de l'interprétation : une dispersion de quelques dixièmes de pourcentage se confond facilement avec du bruit de mesure.
Test canari
Un test distinct — single-pair canary — comparait deux décodages directs avec des requêtes de 59 008 tokens chacune. Résultats : le KV actif s'est compressé d'un facteur 3,625, le débit s'est établi à 0,9821x par rapport au contrôle, les 16 couches d'attention complète ont été routées sans fallback vers le mode dense, et aucune ombre dense n'a été conservée.
Un débit légèrement inférieur à un — c'est, en substance, un échange honnête : environ deux pour cent de vitesse contre une réduction multiple de la mémoire occupée.
Conclusions et réserves
La conclusion avancée par les auteurs est prudente : les résultats montrent une voie pratique vers la compression de l'état à long contexte dans des formats mixtes sans éviction des pages des requêtes vivantes. C'est exactement ce qui manquait aux approches précédentes — une compression qui ne sacrifie pas les données récentes au profit des anciennes.
Ce qu'il faut garder à l'esprit à la lecture :
- Les profils de test sont liés à la configuration. Il s'agit d'un modèle précis et d'un accélérateur précis ; la transférabilité des chiffres à d'autres architectures n'est pas démontrée.
- Le test canari est étroit. Une seule paire de requêtes, un seul scénario de décodage direct — c'est une illustration du fonctionnement, pas une statistique de charge.
- La baisse sur LongBench v2 n'est pas nulle. Quelques dixièmes de point de pourcentage — peu, mais dans des tâches où chaque unité de précision compte, c'est déjà une raison de faire sa propre mesure.
- Aucune donnée sur la latence en conditions de production. Le débit dans le test canari, d'après la description, passe entièrement par 16 couches sans chemin de réserve — il serait intéressant de voir comment le routage se comporte dans le pire des cas, lorsque les pages d'ancrage deviennent plus nombreuses que d'ordinaire.
La valeur pratique du travail ne réside pas dans des chiffres de compression record, mais ailleurs : il montre qu'un cache hétérogène peut être exploité directement, sans en assembler une copie complète à chaque étape. Si cette approche se transpose à d'autres modèles, les scénarios à long contexte disposent d'un levier supplémentaire en complément de la mise à l'échelle matérielle.


