Pourquoi le RAG agentique se heurte à une bifurcation
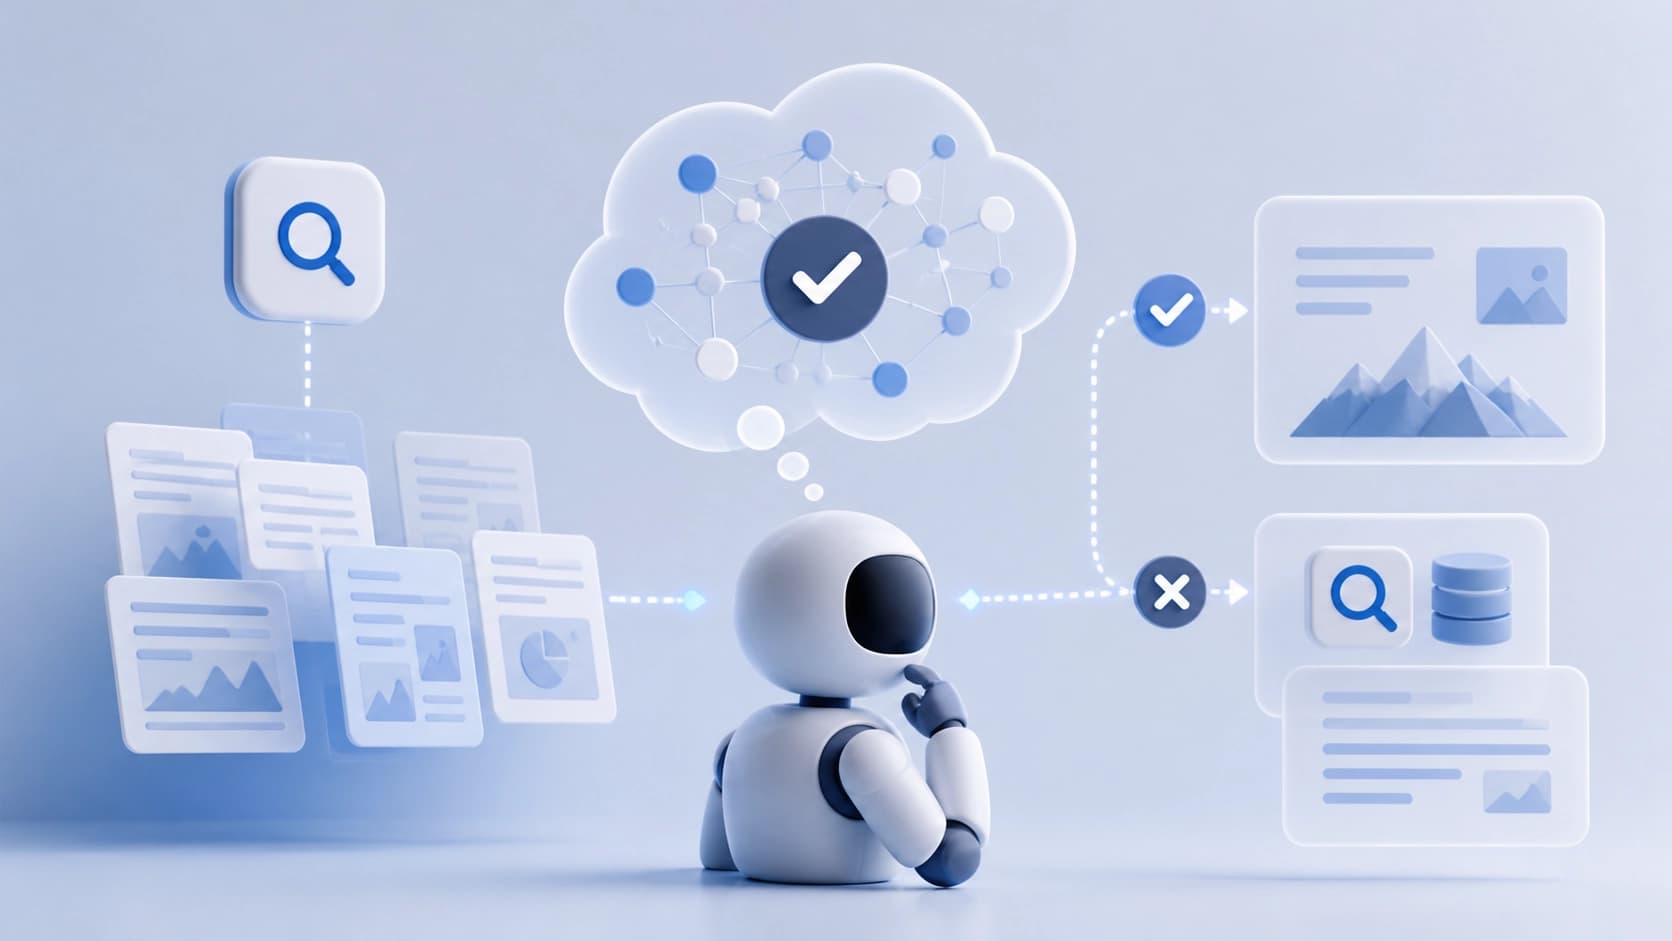
Le RAG agentique est structuré comme une boucle : le modèle lit la question, décide si une requête de recherche supplémentaire est nécessaire, reçoit les résultats et choisit à nouveau — continuer à chercher ou répondre. Chaque itération superflue coûte de l'argent et du temps, chaque itération manquée risque de donner une réponse incomplète. Il s'avère donc que la compétence principale de l'agent n'est pas l'extraction de documents, mais la capacité de dire à temps « les preuves sont suffisantes ».
L'apprentissage par renforcement classique évalue ce comportement de l'extérieur : la réponse correspond à la référence — plus, ne correspond pas — moins. Personne ne demande ce que le modèle lui-même pense de l'exhaustivité des faits collectés. D'où deux maux symétriques : la politique continue à creuser alors que tout est déjà clair en interne, ou bien elle interrompt la recherche alors que les données sont manifestement insuffisantes. La récompense externe ne distingue pas ces situations — le résultat est le même, mais le comportement est différent.
Un changement de formulation du problème
Les auteurs des travaux sur MetaRAG proposent de regarder non seulement l'action, mais aussi dans quelle mesure elle correspond à la conviction interne de l'agent quant à la suffisance des preuves. Ils appellent cette formulation l'alignement des convictions et des actions — belief-action alignment. L'idée est simple : la qualité de la décision de recherche n'est pas une métrique distincte superposée à la réponse, mais la cohérence entre ce que le modèle « pense » et ce qu'il fait.
Comment fonctionne MetaRAG
Le framework est assemblé à partir de trois parties : une vérification explicite avant l'action, une sonde de conviction interne et une récompense spéciale qui relie l'une à l'autre.
Vérification avant l'action
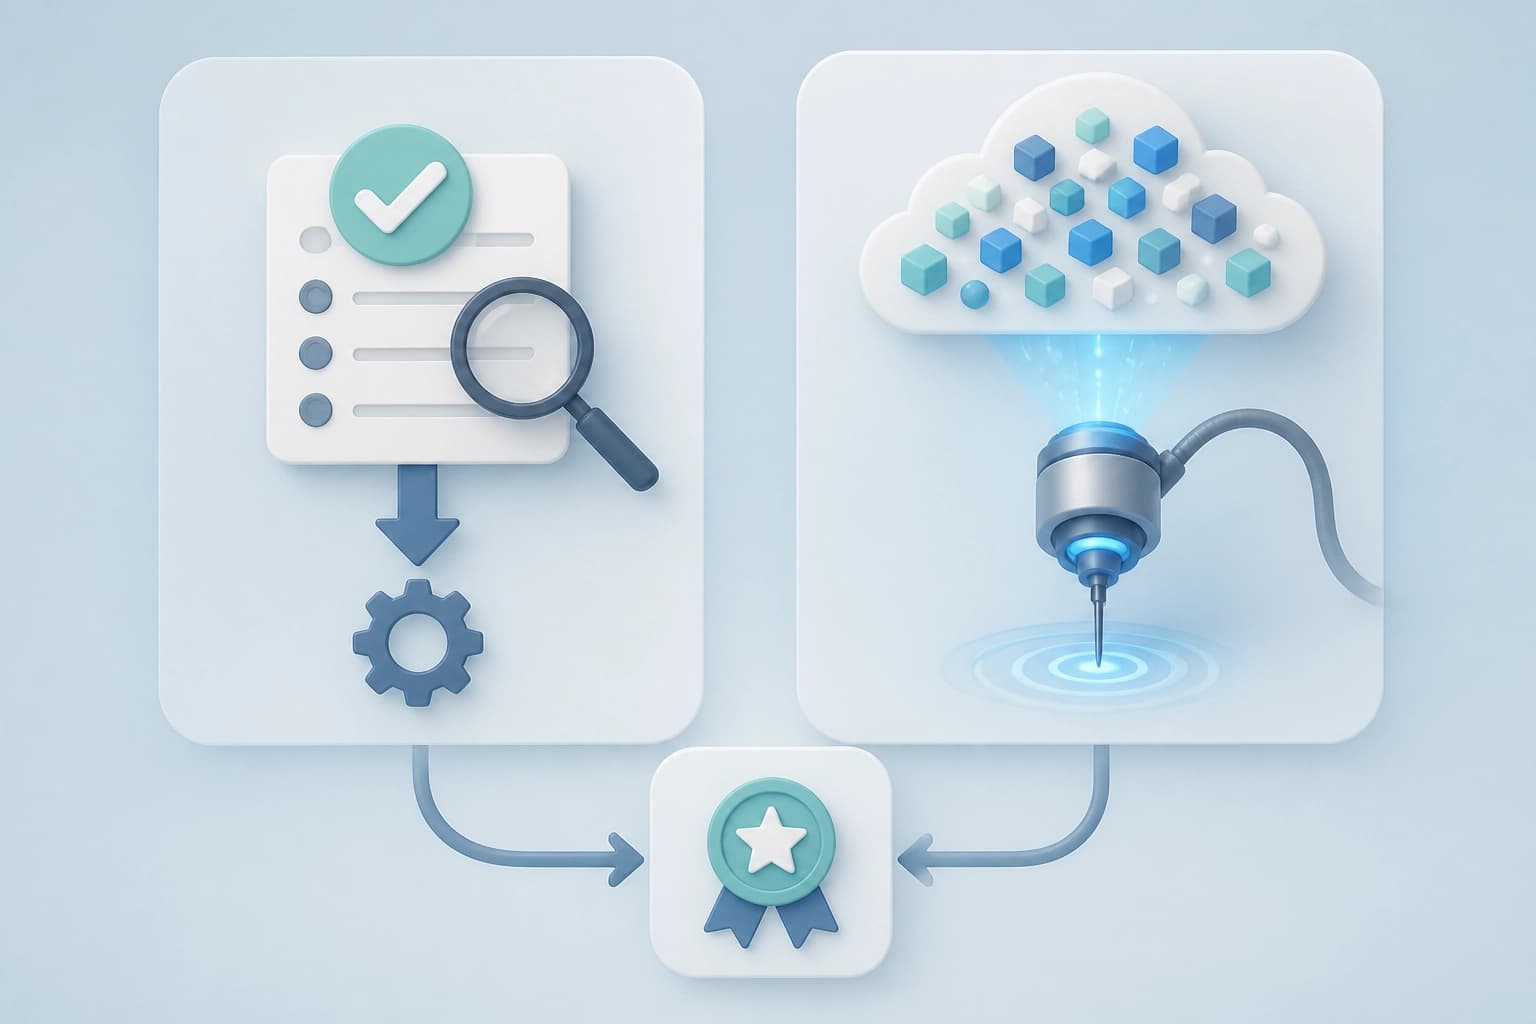
Le premier composant est Verify-first Action Generation. Au lieu de produire immédiatement l'étape suivante, la politique la fait d'abord passer par une procédure de vérification explicite : cette action convient-elle à l'état actuel de la recherche. L'idée est de filtrer les décisions impulsives avant qu'elles n'entrent dans la trajectoire. Il s'agit essentiellement d'un « arrêt sur image » intégré à la génération, qui manque généralement aux agents rapides.
Sonde de conviction interne
Le deuxième composant est Internal Belief Probing. À partir du même contexte que celui vu par la politique (question plus historique des actions et des observations), son propre avis est lu séparément : répond-on déjà à la question maintenant. Il est important de noter qu'il ne s'agit pas d'un modèle-juge externe ni d'une annotation humaine — le signal est prélevé sur la même politique, simplement obtenu d'une autre manière.
Une récompense de cohérence avec un garde-fou
De ces deux signaux est dérivée la consistency reward : l'agent est encouragé lorsque son action coïncide avec son évaluation interne de la suffisance des preuves. Il y a ici un piège évident — on peut commencer à récompenser un comportement « confiant et erroné » si le modèle se trompe de manière cohérente et structurée. Les auteurs le ferment par un garde-fou : la récompense de cohérence n'est prise en compte que lorsque la réponse s'avère correcte. Autrement dit, la cohérence n'est pas une fin en soi, mais un multiplicateur de l'exactitude.
Un détail particulier, important pour les praticiens : la sonde de conviction ne vit qu'à l'étape de l'entraînement. À l'inférence, elle n'est pas appelée, de sorte qu'aucun calcul supplémentaire n'apparaît à chaque requête — les coûts restent nuls.
Ce que les expériences ont montré
Les travaux ont été vérifiés sur sept benchmarks publics de questions-réponses. Le résultat annoncé est une amélioration durable du compromis entre précision et efficacité par rapport à de solides méthodes RL de base pour le RAG agentique. Autrement dit, le gain ne consiste pas simplement à répondre plus précisément, mais à ne pas payer cela par une recherche infinie.
Ensuite, les auteurs ont vérifié dans quelle mesure l'effet se transpose : sur un scénario de recherche approfondie (deep research), sur différents optimiseurs et sur différents modèles de base. Dans toutes ces configurations, la méthode, selon leurs données, conserve son avantage. C'est précisément le type de vérification qui manque souvent : une amélioration sur un seul modèle et un seul jeu de données peut facilement être confondue avec un réglage d'hyperparamètres réussi.
Ce que cela signifie en pratique
Pour les développeurs de systèmes de recherche agentiques, MetaRAG indique une direction moins coûteuse qu'il n'y paraît. Si vous disposez déjà d'un entraînement de politique, l'ajout d'un signal sur la conviction interne ne nécessite pas de nouveaux annotateurs : le même contexte que la politique voit déjà peut être utilisé comme source de signal. Le garde-fou par la correction est ici obligatoire — sans lui, l'agent peut apprendre à se tromper joliment et avec assurance.
La deuxième conclusion concerne la conception de la récompense en général. Les métriques externes répondent à la question « est-ce que ça a marché », mais ne disent presque rien sur « l'agent a-t-il été adéquat sur le moment ». Distinguer ces deux choses est l'idée principale de l'article : la cohérence entre la conviction et l'action est un objet autonome, optimisable séparément, et non un effet secondaire de la croissance de la précision.
Il convient toutefois de garder à l'esprit les limites : les expériences sont restreintes à des benchmarks de QA et à des scénarios de recherche approfondie, et l'approche elle-même est superposée à l'apprentissage RL, c'est-à-dire qu'elle n'est pas applicable « clé en main » aux systèmes où la politique n'est pas entraînée du tout. Pour de tels cas, l'idée elle-même est plus utile — vérifier explicitement l'action avant de l'exécuter et évaluer séparément si la décision coïncide avec la sensation interne de suffisance des données.
Le texte complet est disponible sous la référence arXiv:2608.24214 (v1, 25 août 2026, section cs.AI) — les travaux ont été acceptés au programme principal de la conférence EMNLP 2026.