
LLM multimodaux multi-agents en mathématiques : comment vérifier le raisonnement et la résistance aux perturbations
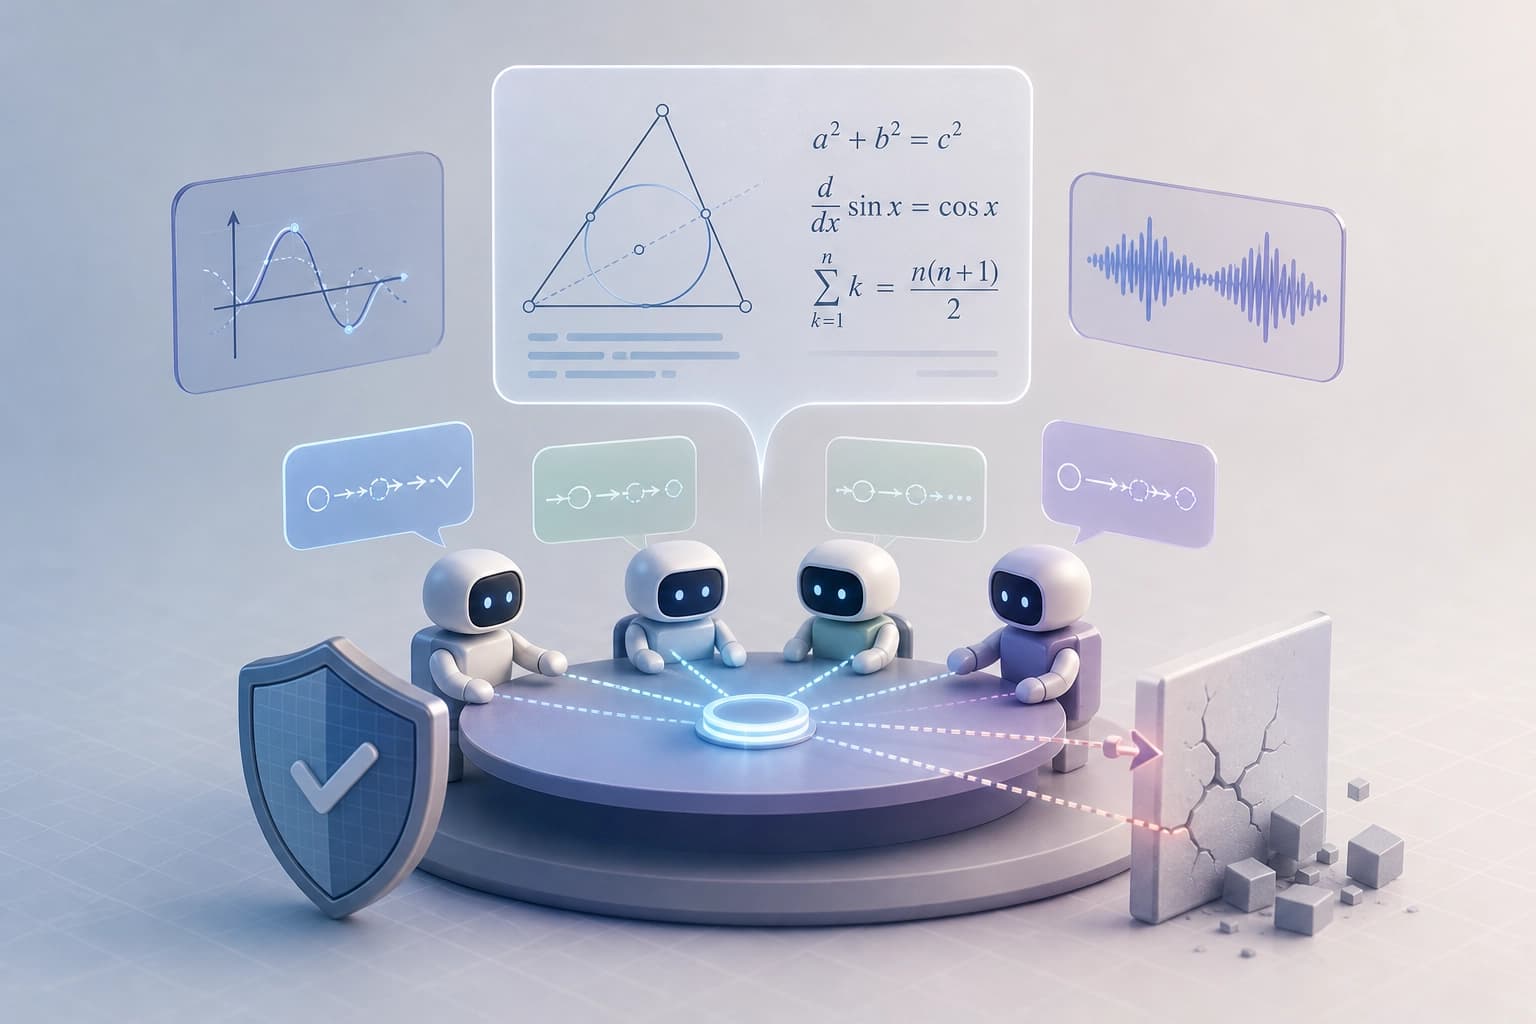
MAMath-Bench est un ensemble de 1 003 problèmes couvrant 11 domaines mathématiques, avec des contenus textuels, graphiques et audio. En plus de la réponse finale, il consigne les étapes de contrôle et la réaction du système face à des modifications adversariales du raisonnement. Les résultats montrent que la coopération entre plusieurs LLM n’améliore pas nécessairement la précision, qu’elle peut amplifier la redondance des justifications et que de subtiles perturbations structurelles restent une source majeure de vulnérabilité.
Ce que mesure le benchmark
MAMath-Bench est un benchmark destiné à évaluer le raisonnement mathématique multimodal des systèmes multi-agents. Il comprend 1 003 problèmes répartis dans 11 catégories mathématiques. Les problèmes couvrent plusieurs niveaux de difficulté et trois modalités : le texte, les images et l’audio.
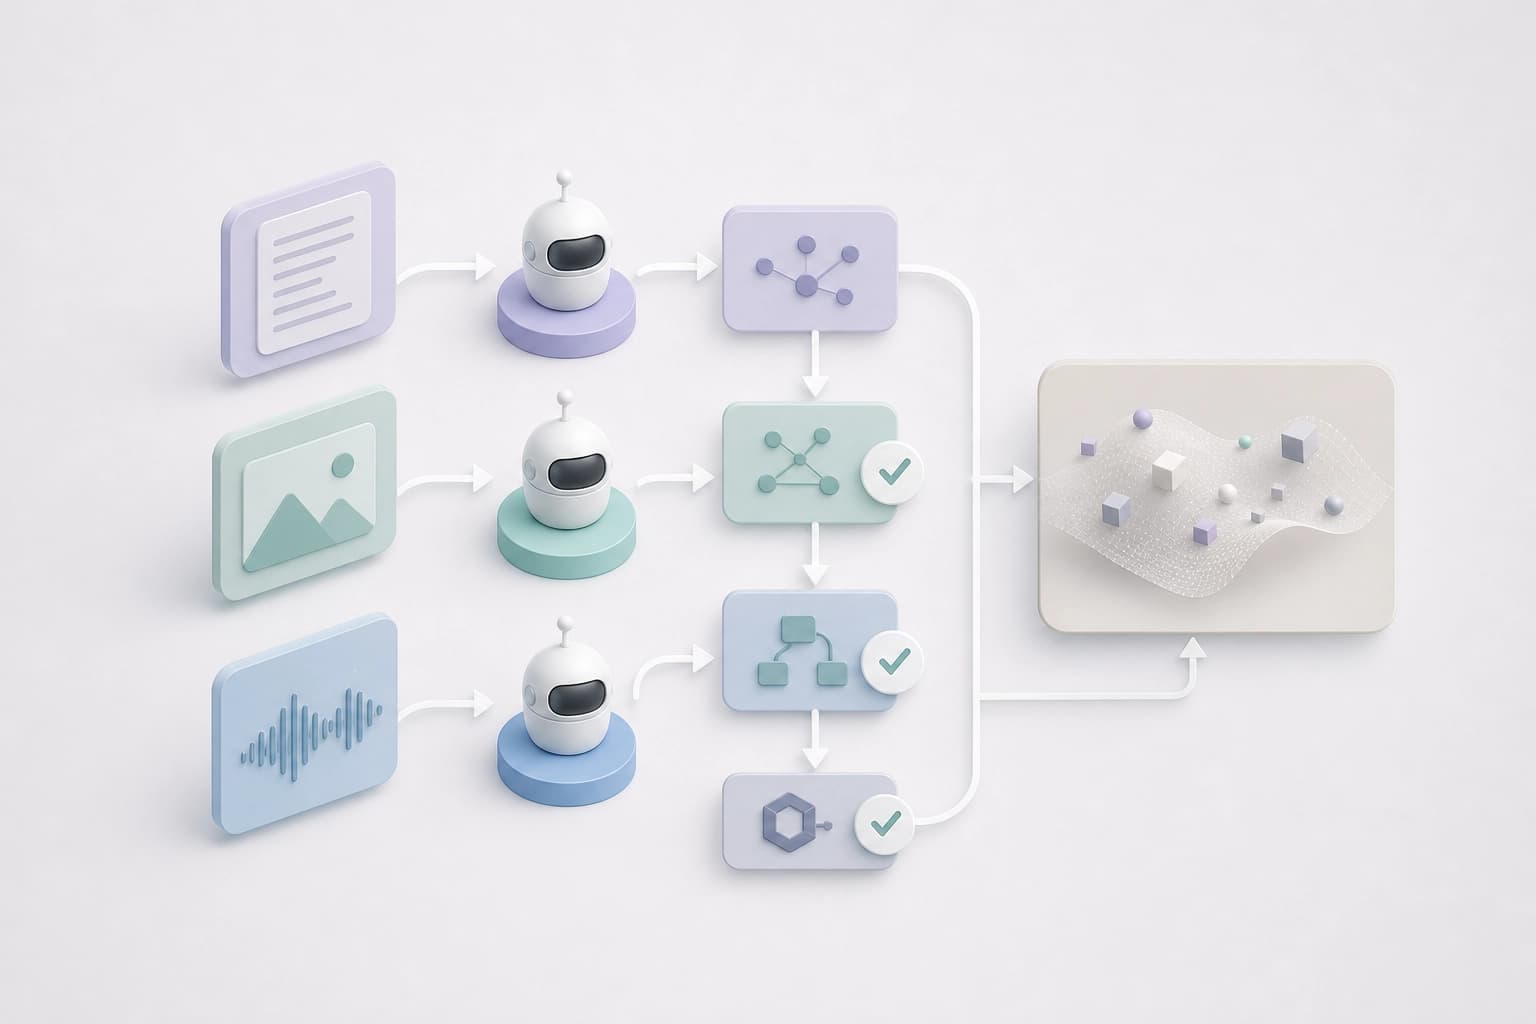
Le benchmark contient des annotations détaillées des étapes clés. L’évaluation porte sur trois dimensions :
- l’exactitude de la résolution du problème ;
- la fiabilité du processus de raisonnement ;
- la robustesse face aux perturbations adversariales de la chaîne de raisonnement.
Critère pratique : choisir une évaluation qui distingue l’exactitude de la réponse, la fiabilité du processus et la robustesse face aux perturbations. La réponse finale ne suffit pas pour effectuer cette vérification.
Vérification du raisonnement
Les annotations des étapes clés servent de repères pour vérifier les étapes intermédiaires. L’évaluation de la fiabilité du processus de raisonnement est distincte de celle de l’exactitude de la réponse finale. Cela permet de comparer les systèmes autrement qu’en fonction du seul résultat.
Points à vérifier dans le raisonnement :
- la présence des étapes clés indiquées dans les annotations ;
- la conformité des étapes intermédiaires à ces jalons ;
- la fiabilité du processus de raisonnement en tant que dimension distincte.
Critère de vérification : déterminer précisément où la résolution s’écarte des étapes clés. La réponse finale, à elle seule, ne permet pas d’évaluer la qualité du raisonnement.
Multi-agent : exactitude, couverture et redondance
L’évaluation met en évidence trois effets distincts de la collaboration entre plusieurs agents. L’exactitude de la réponse finale n’augmente pas toujours par rapport à celle de puissants LLM utilisés seuls. La couverture du raisonnement intermédiaire peut s’améliorer considérablement. Cette amélioration peut s’accompagner d’une hausse de la redondance du raisonnement.
| Que comparer | Ce que montre l’évaluation | Conclusion pratique |
|---|---|---|
| Exactitude de la réponse finale | La collaboration entre plusieurs agents n’améliore pas toujours l’exactitude par rapport à de puissants LLM utilisés seuls | Ne pas considérer une architecture multi-agent comme une garantie de réponse correcte |
| Couverture du raisonnement intermédiaire | La collaboration peut améliorer considérablement la couverture | Mettre en balance le gain de couverture avec les autres dimensions |
| Redondance du raisonnement | L’amélioration de la couverture peut s’accompagner d’une hausse de la redondance | Tenir compte de la hausse de la redondance lors de l’évaluation de la couverture |
Critère de choix : ne pas considérer une architecture multi-agent comme une garantie d’exactitude. La comparer à un puissant LLM utilisé seul en matière de réponse finale, de couverture et de redondance.
Robustesse face aux distorsions adversariales
L’évaluation inclut la robustesse face aux perturbations adversariales de la chaîne de raisonnement. Les systèmes actuels restent vulnérables aux erreurs de raisonnement adversariales, en particulier à celles liées à des perturbations structurelles subtiles.
Points à vérifier :
- la réaction du système aux perturbations adversariales de la chaîne de raisonnement ;
- les erreurs de raisonnement causées par des perturbations structurelles subtiles ;
- le maintien de la fiabilité du processus, et pas seulement de la réponse finale.
Critère de robustesse : tester le système face aux perturbations adversariales de la chaîne de raisonnement. La robustesse à ces perturbations fait partie de l’évaluation, au même titre que l’exactitude de la réponse.
Foire aux questions
Matériaux connexes
Tous matériaux
Tâches vérifiables et entraînement complémentaire sur de longues trajectoires : comment Navalia renforce les agents LLM coopératifs
Ce travail décrit un cadre qui, à partir de rapports financiers d’entreprise, construit des chaînes de calcul accompagnées de preuves traçables, les valide de manière indépendante, puis les utilise pour le SFT et le RL. Avec Qwen3.6-35B-A3B, ce pipeline améliore les performances sur cinq benchmarks et, selon les auteurs, renforce le rattachement des preuves, l’utilisation des outils et l’exécution de tâches longues, y compris dans des scénarios de bureautique.
18 novembre 2026
IA physique : limites du concept, outils et difficultés
Cette monographie de 388 pages rassemble dans un cadre unifié les définitions de l’IA physique, ses différences avec les domaines connexes et ses principales méthodes — de la perception et de la simulation au contrôle et aux systèmes multiagents coordonnés. Elle offre une cartographie des défis de recherche et des limites qui freinent le passage de solutions spécialisées à des systèmes capables d’une généralisation étendue.
17 novembre 2026
Agents LLM en production : taxonomie, architecture et limites du déploiement
L’article synthétise les recherches sur l’utilisation des grands modèles de langage dans les agents de production : il met en évidence les obstacles, les niveaux de capacité et une architecture à quatre couches. Il permet de comprendre quels scénarios du cycle de vie sont déjà étudiés et où subsistent des lacunes pour une planification autonome fiable.
17 novembre 2026