
Comment le prompt engineering ciblé des LLM révèle des données médicales cachées que les systèmes standard de déidentification négligent
Une nouvelle étude montre que les grands modèles de langage, avec des invites calibrées pour une clinique spécifique, comblent les lacunes dans la protection des informations médicales — y compris les codes internes et les noms de bâtiments — surpassant en précision les algorithmes existants tout en détectant les erreurs dans l'annotation de référence.
Pourquoi les dé-identificateurs standard laissent passer les données « locales »
Les systèmes de dé-identification automatique des dossiers médicaux gèrent généralement bien les types typiques d'informations protégées : noms, dates de naissance, numéros d'assurance. Mais dans un hôpital réel, on rencontre des données qui ne sont sensibles qu'au sein de cette organisation. Ce sont les noms abrégés des cliniques, les noms des bâtiments, les codes internes des services. Pour un humain, ces chaînes indiquent clairement le lieu de traitement, mais un algorithme universel ne peut pas connaître toutes les désignations locales.
Les solutions traditionnelles s'appuient soit sur des dictionnaires, soit sur des modèles entraînés avec des catégories fixes. Les unes comme les autres laissent passer ce qui ne figure pas dans leurs référentiels. Les chercheurs appellent cela la PHI « localisée institutionnellement », et c'est précisément là que surviennent des risques sérieux de fuite.
Comment les LLM parviennent à combler l'écart
Pour vérifier si les grands modèles de langage avec apprentissage contextuel (in-context learning) peuvent résoudre ce problème, les auteurs de l'expérience ont pris 100 notes annotées d'oncologie pédiatrique — soit plus de cinq mille fragments de PHI — puis ont comparé huit LLM à deux systèmes spécialisés (Stanford TiDE et OpenMed PII) et à deux modèles de base basés sur des motifs.
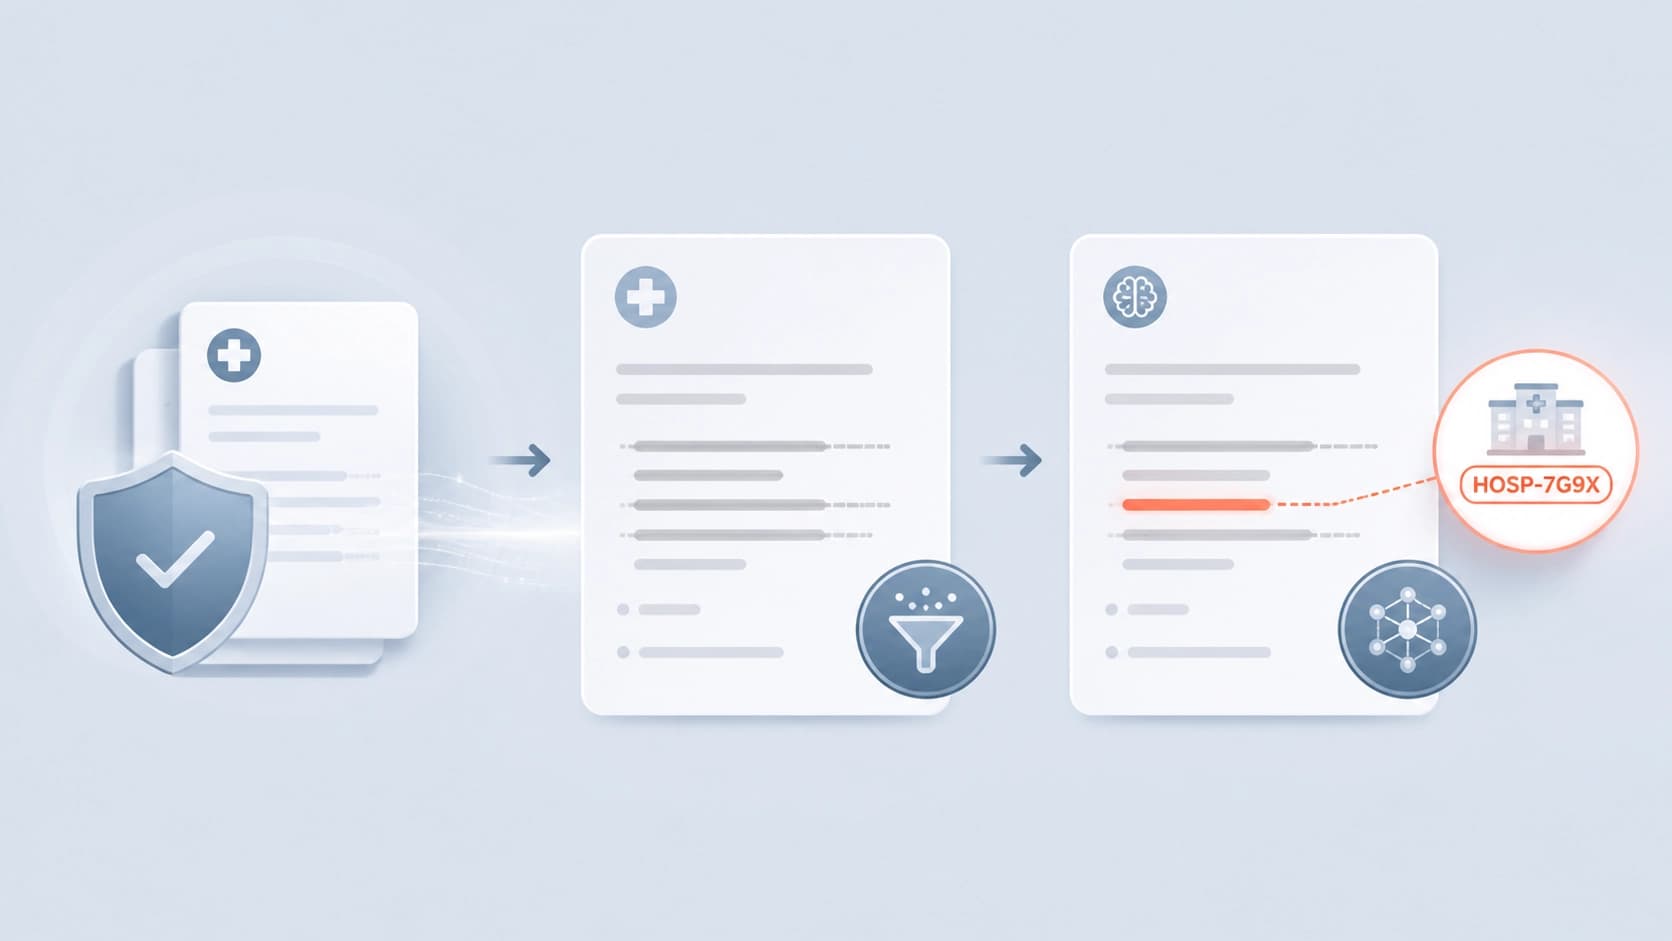
Le résultat a été en faveur des LLM : le meilleur modèle a atteint un F1 = 0,918 ± 0,001, tandis que le meilleur système spécialisé, TiDE, n'a obtenu que 0,779. L'avantage était particulièrement net sur les catégories dépendantes du contexte — ces fameuses désignations locales qui échappent généralement aux algorithmes.
Trois niveaux de prompts : de la HIPAA à l'ajustement fin
L'astuce clé n'est pas une simple requête, mais un réglage ciblé du prompt pour l'établissement concerné. L'expérience a utilisé trois variantes :
- Prompt de base — instruction générale selon la norme HIPAA.
- Prompt avec catégories locales — ajout d'une liste de types de PHI institutionnels que la norme ne prend pas en compte.
- Prompt avec protection contre la sur-édition — consigne supplémentaire de ne pas supprimer de contenu clinique superflu.
L'énumération des catégories manquées a récupéré 79 % des 61 fragments précédemment non trouvés (48 éléments). Et l'instruction contre la sur-édition a rétabli la précision, qui souffrait de la « sur-prudence » du modèle.
Les agents et les ensembles n'ont apporté aucun gain
On pourrait supposer qu'un résultat encore meilleur viendrait de l'exécution de plusieurs modèles ou d'un schéma multi-agents. Les auteurs ont testé 14 configurations de ce type et les ont comparées au meilleur prompt unique. Il s'est avéré qu'aucune architecture d'agents n'a surpassé un simple prompt calibré en une seule passe. Chez les agents, le F1 se maintenait dans une fourchette de 0,906 à 0,907 — c'est-à-dire pratiquement au même niveau, mais sans gain supplémentaire.
Les LLM comme auditeurs de l'annotation
Une valeur supplémentaire de l'approche LLM réside dans le fait qu'elle aide à vérifier la qualité de l'ensemble de référence lui-même. Les modèles ont signalé 414 endroits où l'annotation d'origine était probablement incomplète. Après vérification manuelle, 227 spans de PHI manquants ont été confirmés. Une fois l'annotation corrigée et le prompting relancé, le rappel est passé à 0,981 avec un F1 = 0,907 ± 0,002. Cela signifie que le LLM peut servir non seulement d'outil de dé-identification, mais aussi d'auditeur pour créer des ensembles d'entraînement plus précis.
Conclusions
Un prompt bien réglé permet au LLM de combler l'écart institutionnel de la PHI et de trouver un équilibre optimal entre précision et rappel en un seul appel au modèle. Cette approche est plus coûteuse que les méthodes traditionnelles basées sur des dictionnaires, mais ces coûts sont en partie compensés par la possibilité de vérifier et d'améliorer la référence elle-même.
Les auteurs considèrent les LLM comme une alternative légitime et adaptable aux dé-identificateurs spécialisés. La principale stratégie de déploiement est le développement de prompts spécifiques à chaque institution, tenant compte des réalités locales de chaque clinique.
Foire aux questions
Matériaux connexes
Tous matériaux
Le passage au simplexe probabiliste réduit l’écart modal dans les modèles multimodaux contrastifs
L’article arXiv:2610.32890 propose de remplacer les embeddings sphériques par un simplexe probabiliste, en ajoutant de légers adaptateurs softmax et une similarité fondée sur la variation totale. Sur cinq benchmarks de recherche, la distance ℓ2 entre les centroïdes des modalités diminue de 97 à 99 %, tandis que la qualité de la recherche est maintenue ou améliorée.
3 novembre 2026
Comment ActionRAG réévalue les preuves lors de la propagation dans le graphe de mémoire des agents LLM
Une architecture de mémoire en graphe a été proposée : lors de l’indexation, elle harmonise soigneusement les entités, puis réévalue les relations au moment de la requête en s’appuyant sur la structure locale. Sur MemoryAgentBench, la méthode a atteint une précision moyenne de 55,1 et dépassé de 5,4 points de pourcentage le meilleur modèle de référence en récupération, tout en maintenant un faible coût de synthèse par requête.
3 novembre 2026
Quinze entreprises ont soutenu MDK Tether pour automatiser le minage
Les fabricants d’équipements, les pools et les opérateurs ont pris en charge le développement d’intégrations avec l’ensemble ouvert de Tether afin d’unifier la surveillance et la gestion des équipements ; l’agent IA QVAC fonctionne déjà sur cette base. Aucune confirmation indépendante d’une baisse des coûts énergétiques ou d’une hausse de l’efficacité n’a encore été publiée.
2 novembre 2026