Pourquoi l'évaluation des agents vocaux est si difficile à automatiser
Un agent vocal conversationnel n'est pas un seul modèle, mais un pipeline : reconnaissance vocale, raisonnement, appel d'outils, génération de réponse, synthèse et streaming audio. Une défaillance à n'importe quelle étape ne reste pas locale — elle se propage le long de la chaîne et refait surface dans le dialogue lui-même. C'est précisément pourquoi juger la qualité de l'interaction n'a de sens que dans son ensemble, de bout en bout, et non par maillons isolés.
Maintenir une équipe d'évaluateurs humains coûte cher et s'avère peu pratique : impossible de la faire passer à l'échelle sur des centaines de milliers de conversations, et leur attention décline en fin de service. La solution naturelle consiste à confier l'évaluation à un modèle de langage. Un préprint arXiv récent :2608.24314 (Anupam Purwar, Shashank Singh, Kritika Srivastava) vérifie justement dans quelle mesure cette solution est justifiée et où elle échoue.
Comment les auteurs ont testé les juges LLM
L'expérience repose sur de vraies conversations d'agents vocaux issues de deux secteurs — les télécoms et le commerce de détail. Les évaluations humaines ont été comparées aux verdicts de GPT-4.1 et GPT-5, et ce non pas selon une échelle globale unique, mais selon dix métriques : certaines décrivent la qualité de la conversation elle-même, d'autres la sécurité.
Trois configurations au lieu d'une
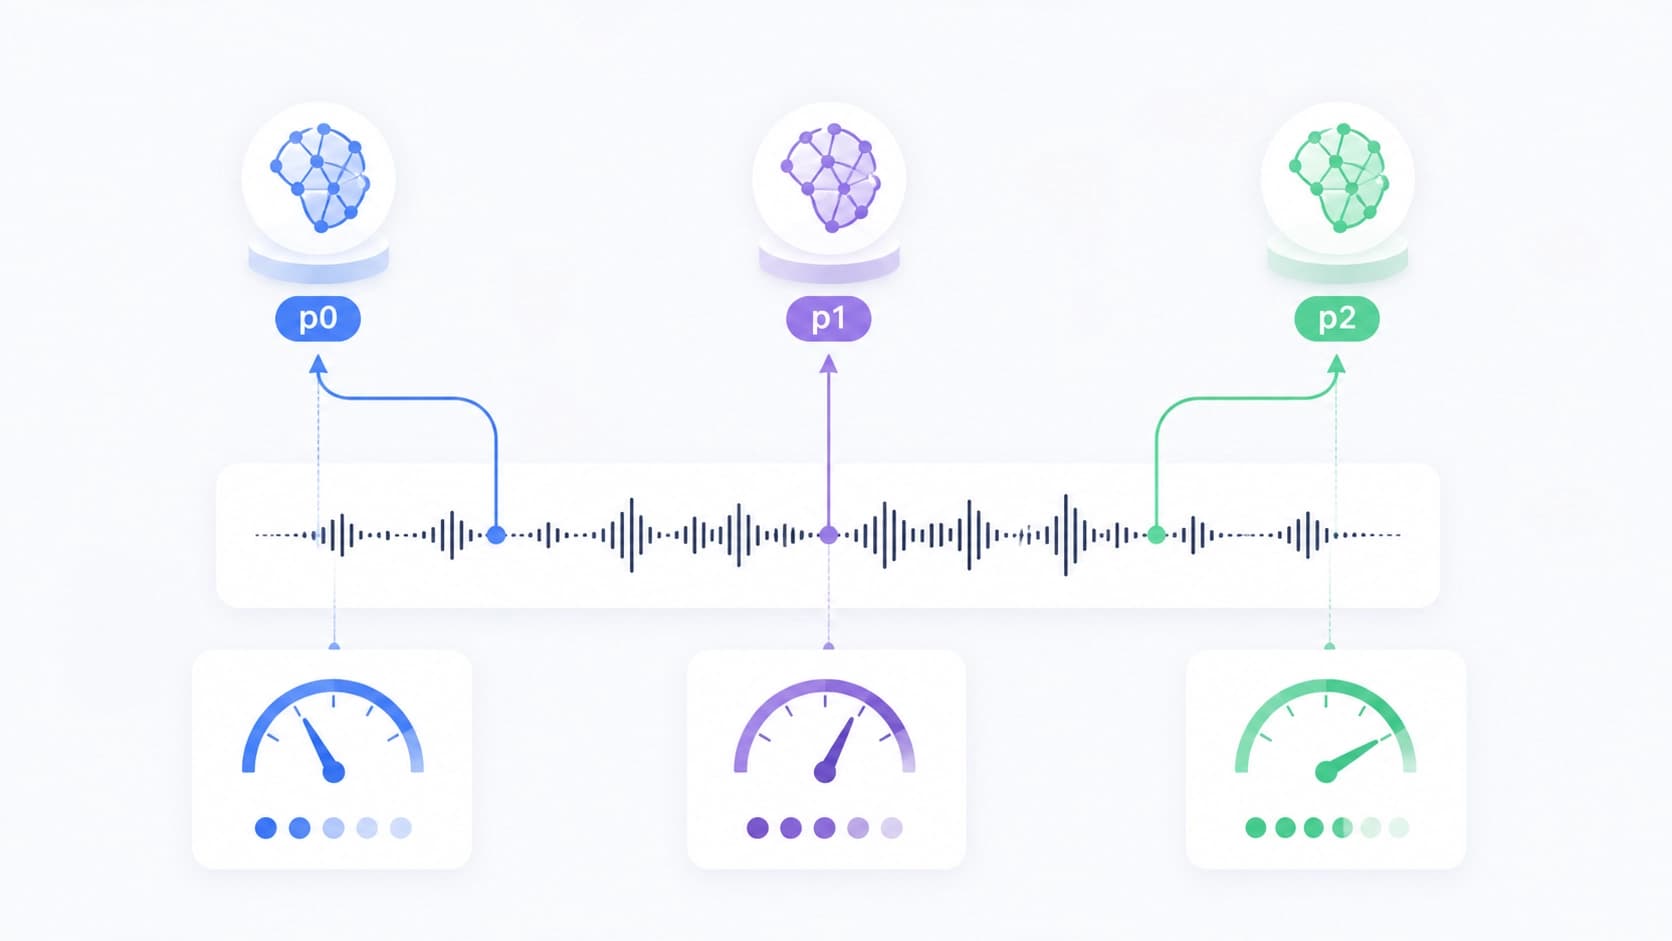
Les mêmes dialogues ont été passés à travers trois schémas d'évaluation — p0, p1 et p2. Le sens de l'exercice est simple : si le verdict change selon la façon dont la grille est rédigée, alors le juge ne mesure pas la qualité de la conversation, mais la forme de la consigne. Toute métrique qui « flotte » entre les configurations ne convient pas à l'automatisation — du moins sans réserves.
Ce qui a été comparé précisément
L'accord agrégé — le pourcentage de correspondances entre l'humain et le modèle — n'est que la couche superficielle. Les auteurs creusent plus loin : ils examinent les corrélations pour chaque métrique séparément, vérifient la stabilité des évaluations au sein d'un groupe d'humains et analysent les divergences systématiques entre l'humain et le LLM. Une telle approche permet de comprendre quels attributs de la conversation se prêtent à une évaluation automatique et lesquels se heurtent au contexte et à l'interprétation.
Où le juge LLM se trompe
La conclusion clé ressemble davantage à une mise en garde qu'à une publicité pour la méthode : la fiabilité de l'évaluation automatique n'est pas uniforme — elle dépend de la métrique concernée et de la configuration. Les mêmes modèles-juges donnent des résultats solides sur certaines échelles et décrochent nettement sur d'autres.
Recovery Turn Count
Cette métrique compte combien de tours ont été nécessaires à l'agent pour sortir la conversation d'une défaillance. L'évaluation automatique est ici peu fiable : le juge ne distingue pas toujours une récupération sensée d'une formulation heureuse par hasard. Un dialogue qu'un humain qualifierait de sauvé, le modèle l'enregistre facilement comme un échec — et inversement.
Les métriques de sécurité en rappel
Safety-recall — le deuxième point problématique. La logique de l'erreur est prévisible : le juge voit un dialogue où l'agent n'a rien dit de dangereux et attribue une note élevée, sans se demander s'il y avait même une occasion d'enfreindre la politique. Une violation manquée est le type d'erreur le plus coûteux, et c'est précisément là que l'automatisation est la plus faible.
Le domaine modifie la calibration
La fiabilité des juges diffère entre les télécoms et le commerce de détail. Conclusion pratique : les seuils et les grilles ne peuvent pas être transférés mécaniquement d'un secteur à l'autre — ce qui est calibré sur un domaine dérivera sur un autre.
La calibration compte plus que le pourcentage d'accord
Un chiffre d'accord unique endort la vigilance. Un modèle peut s'accorder avec les humains en moyenne sur de grands nombres, tout en étant systématiquement plus indulgent sur les cas limites — et ce biais reste invisible derrière le pourcentage global. C'est pourquoi l'analyse corrélationnelle de la calibration et l'examen des divergences par classe de cas sont plus utiles qu'une seule métrique synthétique : elle ne montre pas « à quel point nous sommes proches », mais « dans quelle direction et sur quoi nous nous trompons ».
Comment intégrer cela dans un pipeline réel
Les auteurs ne proposent pas de renoncer à l'automatisation — ils proposent un schéma hybride. Le juge LLM prend en charge l'évaluation de masse, les humains restent là où le contexte et une haute confiance dans le verdict sont nécessaires. Les règles pratiques sont les suivantes :
- faites tourner la grille dans au moins deux ou trois configurations et comparez les résultats, pas seulement le score final ;
- calculez l'accord pour chaque métrique séparément, et non en un seul chiffre pour tout le jeu de données ;
- gardez un humain sur le safety-recall et sur les métriques de récupération après défaillance ;
- vérifiez la calibration sur votre propre domaine avant de fixer des seuils automatiques ;
- conservez les cas de divergence humain/modèle — c'est une matière prête à l'emploi pour affiner la grille.
Ce qu'il faut retenir
Le juge LLM est un outil opérationnel pour l'évaluation à grande échelle des agents vocaux, mais il ne remplace pas l'évaluateur. Sa fiabilité est répartie de manière inégale : certaines métriques peuvent être confiées sans crainte à l'automatisation, d'autres exigent un regard humain. L'intérêt de l'étude réside dans le fait qu'elle fournit un cadre empirique pour cette répartition des tâches — et rappelle que la question « faut-il confier l'évaluation au modèle » est incorrecte tant que l'on n'a pas précisé selon quelle métrique et dans quel domaine.