Deux chiffres seulement figurent habituellement dans un rapport sur la qualité de l'évaluation automatique : dans quelle mesure les verdicts du modèle correspondent à ceux des humains, et dans quelle mesure ils résistent à de légères modifications comme la permutation des options ou la reformulation du prompt. Un nouveau travail affirme que cela ne suffit pas — et propose de regarder le juge autrement.
L'accord ne répond pas à la bonne question
L'accord et la robustesse aux perturbations superficielles relèvent de la fiabilité. Un instrument de mesure fiable produit un résultat stable, mais la stabilité en soi ne dit rien sur la question de savoir s'il mesure la bonne grandeur. Un thermomètre qui affiche toujours 20 degrés est exceptionnellement fiable et parfaitement inutile.
Les auteurs de l'article « A Judge Should Know What Changed: Construct Validity for LLM-as-a-Judge Evaluation » (Jianlin Chen, Wenhui Chen, Ziyao Lin, Chi Man Vong ; arXiv:2608.24419, cs.AI, soumis le 25 août 2026 ; 39 pages, 10 figures, 11 tableaux) déplacent le débat sur le terrain de la validité de construit : l'évaluation correspond-elle au concept qu'elle est censée mesurer. Pour un juge LLM, cela signifie une chose simple — le juge doit réagir au sens, pas à la forme.
Un profil à deux dimensions
Au lieu d'une seule métrique, un profil à deux probabilités est proposé.
S — l'invariance. À quelle fréquence le verdict reste inchangé si la modification préserve le sens : on a permuté les paragraphes, changé le style, retiré le superflu. Un bon juge ne doit pas broncher ici.
R — la sensibilité au construit. À quelle fréquence le verdict change si la modification est minime mais touche le sens : on a ajouté une réserve, affaibli une affirmation, restreint le champ d'application. Un bon juge doit réagir ici.
L'affirmation clé de l'article : S et R sont indépendants, et aucune synthèse scalaire ne préserve toutes les comparaisons pertinentes. Autrement dit, on ne peut pas faire la moyenne de deux chiffres et obtenir un seul chiffre honnête — un juge à S élevé et R faible et un juge à S faible et R élevé peuvent donner la même « note moyenne » tout en restant des instruments fondamentalement différents.
Comment cela a été vérifié
Le dispositif expérimental est nettement plus rigoureux que d'ordinaire pour ce type de travaux.
- 7 juges et 4 domaines — autrement dit, on n'a pas testé un seul modèle ni un seul type de tâches.
- 7 types d'interventions modifiant le construit contre 5 contrôles, qui ne touchent que le registre et ne changent pas le sens.
- Le sens de la modification — modifie-t-elle le construit ou non — a été déterminé par des annotateurs humains, et non par une annotation par défaut.
- La génération, la vérification et le jugement ont été confiés à des familles de modèles disjointes. C'est un détail important : le juge n'évalue pas un texte qu'il a lui-même produit et ne vérifie pas des modifications qu'il a lui-même imaginées.
Le dernier point mérite une attention particulière. Lorsque le générateur, le vérificateur et le juge sont un seul et même modèle, un accord élevé peut être un artefact de biais communs plutôt qu'un signe de qualité.
L'invariance est presque parfaite, la sensibilité ne l'est pas
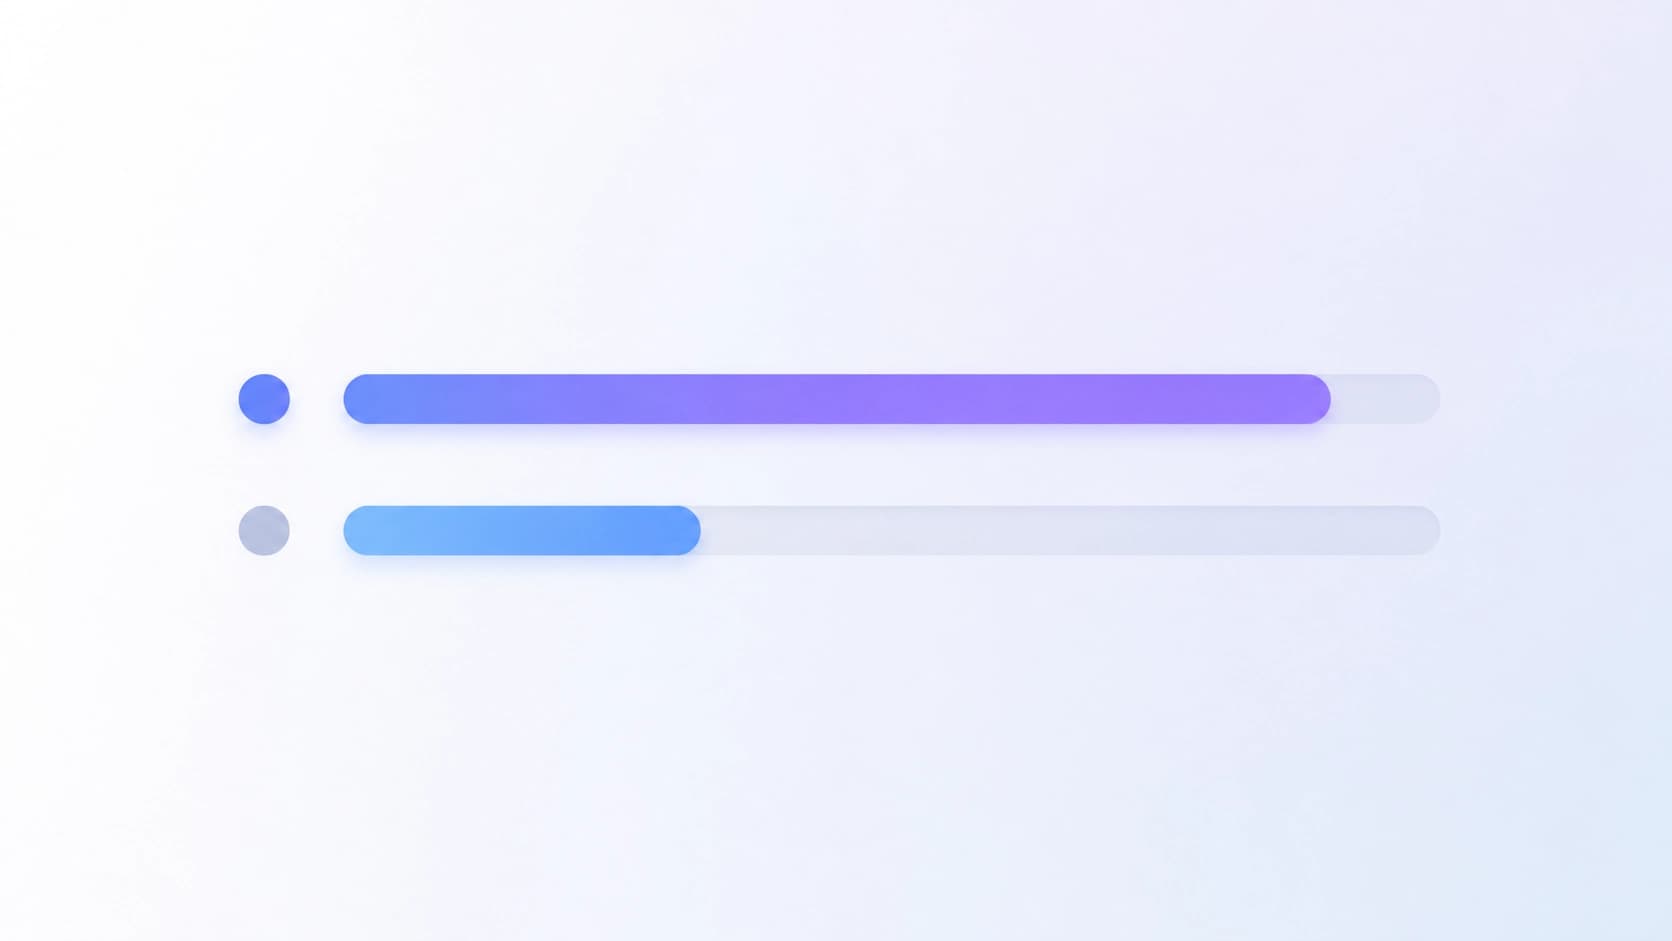
C'est ici que commence le plus intéressant. Avec un seuil d'invariance convenue S ≥ 0,90, les juges ont affiché en moyenne S = 0,945. Le chiffre auquel on vise habituellement dans les rapports.
La sensibilité, elle, est de R = 0,319. Interprétation grossière : dans environ deux cas sur trois, le juge n'a pas remarqué une modification qui change le sens. Un résultat formellement irréprochable en matière d'invariance coexiste avec une réponse très faible au contenu.
L'ampleur et la force ne sont pas la même chose
La faible sensibilité est répartie de manière inégale. Lorsque la modification change l'ampleur de l'affirmation, la réponse est plus élevée : R_scope = 0,383. Lorsqu'elle change la force — plus faible : R_strength = 0,262. L'écart est de +0,121, et son signe est identique pour les sept juges.
Il ne s'agit donc pas d'une dispersion aléatoire entre modèles, mais d'une particularité systématique. Les juges perçoivent mieux l'élargissement et la restriction du champ d'application que le déplacement sur l'échelle de certitude — « probablement » contre « certainement », « peut aider » contre « aide ». Pour la pratique, c'est une mauvaise nouvelle : ce sont précisément ces gradations qu'il faut le plus souvent distinguer.
Les annotations humaines méritent aussi d'être vérifiées
Un autre volet : cinq ensembles publics d'annotations utilisés comme référence. Les prédicteurs reposant exclusivement sur des indices superficiels du texte reproduisent, en mode apparié, 55–67 % des annotations. Dans le cas de MT-Bench, une heuristique superficielle a coïncidé avec 67,4 % des votes humains.
La conclusion qui s'impose est inconfortable. Si une règle simple, qui ne comprend rien au contenu, reproduit deux tiers des décisions humaines, alors ces annotations séparent mal le sens de la forme — et il faut valider non seulement le juge, mais aussi l'ensemble sur lequel on le teste.
Que faire de tout cela
Les auteurs ne proposent pas de remplacer les juges LLM par autre chose — ils proposent de modifier la restitution et la procédure de vérification.
Restitution conjointe. S et R sont publiés côte à côte, et non repliés en un seul chiffre. Le lecteur du rapport voit immédiatement où le juge échoue.
Audit de l'ensemble de validation. Avant de faire confiance à l'accord avec les annotations humaines, il vaut la peine de vérifier dans quelle mesure ces annotations sont prévisibles sans compréhension du texte. Si elles le sont bien — la confiance qu'on leur accorde est exagérée.
Séparation des rôles. Confier la génération, la vérification et le jugement à des familles de modèles différentes réduit le risque qu'une invariance élevée soit la conséquence de angles morts communs.
L'idée principale
Un accord élevé relève de la stabilité, pas de la justesse. Un juge qui rend son verdict avec la même assurance avant et après une modification sémantique n'est pas « robuste », il est inattentif. Tant qu'un rapport ne contient qu'un seul chiffre, il est impossible de distinguer ces deux cas — et c'est précisément pourquoi un profil à deux dimensions apparaît non pas comme une complication, mais comme une honnêteté minimale nécessaire.