
Apprentissage tabulaire en contexte avec des experts clairsemés : le modèle compact OrionMoE-Small-v1.0
Un modèle de base compact pour les tâches tabulaires est présenté : il prédit de nouvelles observations à partir d’un tableau de référence annoté, sans ajustement supplémentaire des paramètres. La sélection adaptative d’experts en fonction du jeu de données et des représentations des caractéristiques offre des résultats compétitifs, en particulier avec un contexte limité et une grande dimensionnalité.
L’apprentissage en contexte tabulaire : les principes du mode
Le modèle prédit des observations inédites à partir d’un tableau de support annoté. Il ne met pas à jour ses paramètres pour une tâche spécifique. L’article décrit OrionMoE-Small-v1.0, un modèle de base compact pour les données tabulaires, conçu pour l’apprentissage en contexte.
Éléments clés du mode :
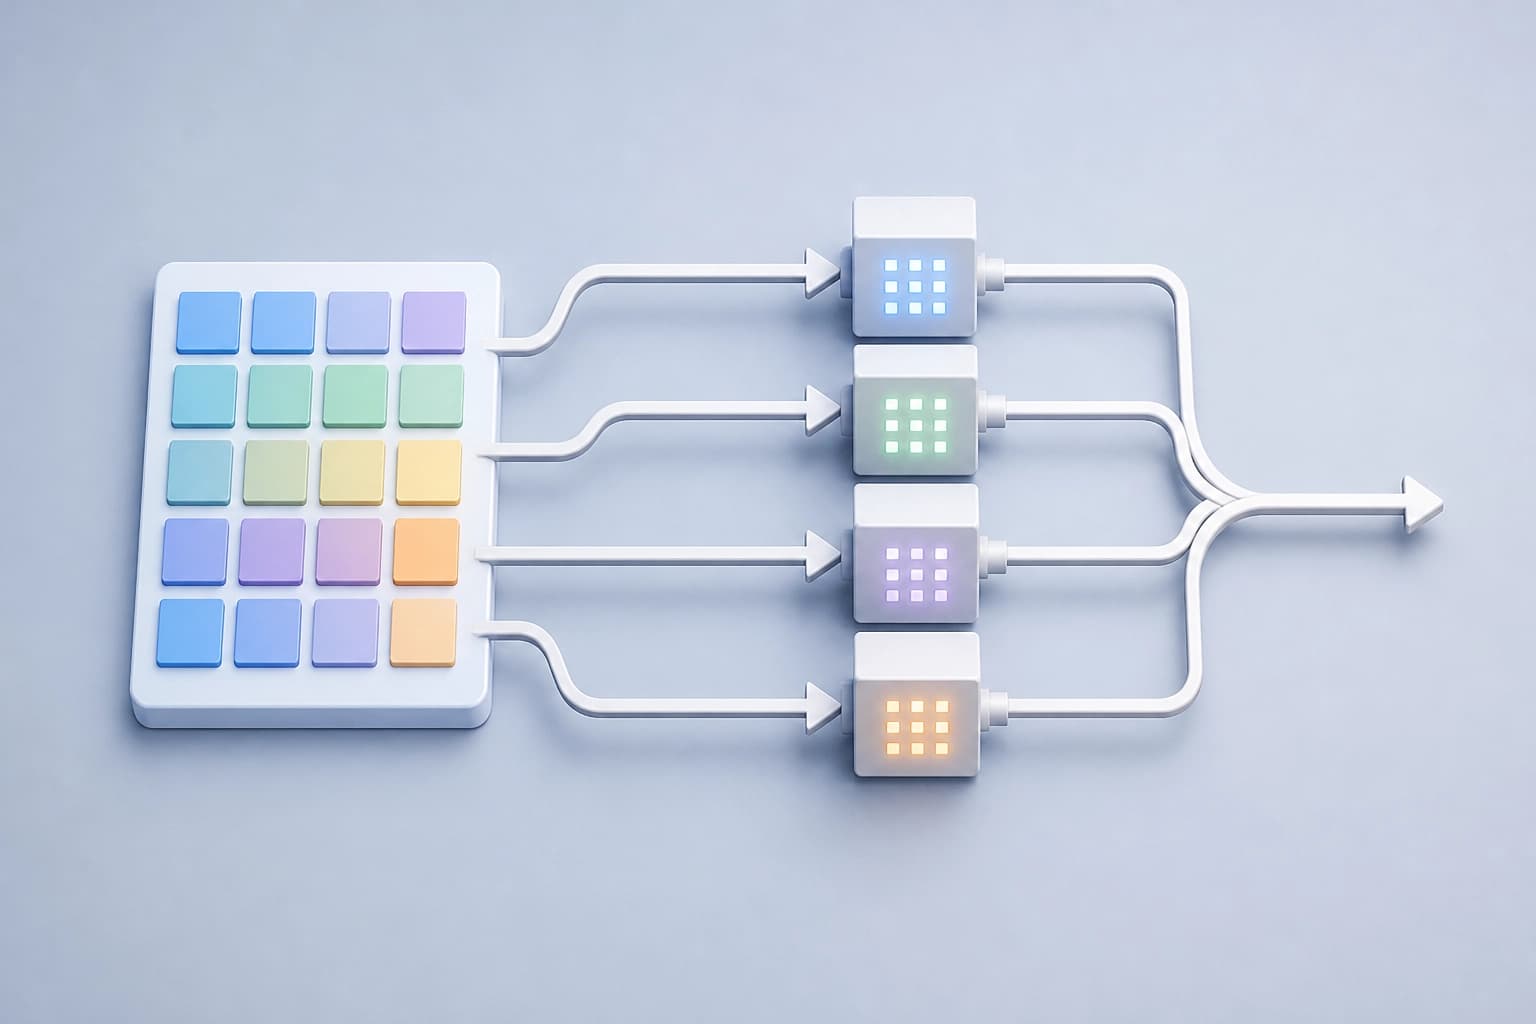
- entrée — un tableau de support annoté ;
- objectif — prédire des observations inédites ;
- adaptation — sans mise à jour des paramètres pour une tâche spécifique ;
- mode — apprentissage en contexte.
Critère pratique : la tâche doit permettre de faire des prédictions à partir d’un tableau de support annoté. Aucune adaptation par gradient à la tâche n’est nécessaire.
Architecture : transformeur à double axe et experts clairsemés
OrionMoE-Small-v1.0 repose sur une architecture de transformeur à double axe. Le modèle combine des représentations tenant compte de la distribution des données et des calculs clairsemés par mélange d’experts. Ces calculs sont conditionnés par l’ensemble de données. La sélection des experts activés tient compte des représentations des cellules individuelles et du contexte de l’ensemble.
Fonctionnement du modèle :
- architecture — transformeur à double axe ;
- représentations — tenant compte de la distribution des données ;
- calculs — mélange clairsemé d’experts conditionné par l’ensemble de données ;
- sélection des experts — selon les représentations des cellules et le contexte de l’ensemble ;
- répartition des calculs — adaptative entre des tâches tabulaires hétérogènes ;
- chemin de calcul — commun à différentes tâches.
Critère pratique : les tâches tabulaires hétérogènes nécessitent une répartition adaptative des calculs. Le modèle conserve un chemin de calcul commun à différentes tâches.
Entraînement : tâches de classification synthétiques
Le modèle a été préentraîné exclusivement sur des tâches de classification synthétiques. Ces tâches reposent sur un a priori causal structuré. Pour les tâches ultérieures, le modèle effectue des prédictions sans adaptation par gradient. L’annotation donne le nom OrionMoE-Small-v1.0.
Les auteurs de l’article sont Mohamed Bouadi, Nassim Bouarour, Aditya Tanna et Vinay Kumar Sankarapu. Ils ont soumis l’article le 14 octobre 2026. La dernière révision date du 18 octobre 2026. La version de l’article est v2.
Ce que l’on sait de l’entraînement :
- données — exclusivement des tâches de classification synthétiques ;
- fondement — un a priori causal structuré ;
- tâches ultérieures — sans adaptation par gradient.
Critère pratique : la source décrit un préentraînement uniquement sur des tâches de classification synthétiques. Elle ne fournit pas de données sur d’autres types de tâches.
Résultats et critères d’utilisation
OrionMoE-Small-v1.0 a obtenu des résultats compétitifs sur plusieurs benchmarks tabulaires, en comparaison avec des modèles de base considérablement plus grands. L’analyse a relevé des résultats particulièrement solides sur les ensembles de données à faible contexte et à forte dimensionnalité. Une analyse complémentaire a montré des résultats relatifs favorables en présence d’un déséquilibre des classes.
| Scénario | Ce que l’analyse a montré |
|---|---|
| Comparaison avec des modèles de base considérablement plus grands | résultats compétitifs |
| Faible contexte et forte dimensionnalité | résultats particulièrement solides |
| Déséquilibre des classes | résultats relatifs favorables |
| Composition des caractéristiques | l’analyse a souligné son importance |
Critère pratique : un faible contexte et une forte dimensionnalité sont des conditions dans lesquelles les résultats sont particulièrement solides. Le déséquilibre des classes et la composition des caractéristiques sont des points d’analyse distincts.
Foire aux questions
Matériaux connexes
Tous matériaux
Recherche locale des décalages de covariables pour les profils avec des prévisions peu fiables
L’article décrit un pipeline diagnostique qui identifie d’abord des groupes de patients interprétables pour lesquels le modèle affiche un faible niveau de confiance, puis vérifie la présence d’un décalage de covariables nuisible au sein de ces groupes. Lors d’expériences menées sur MIMIC-IV, avec trois tâches cliniques et trois décalages artificiels entre sous-groupes, cette approche a permis de localiser un décalage lié à l’âge, peu visible dans l’évaluation agrégée.
15 novembre 2026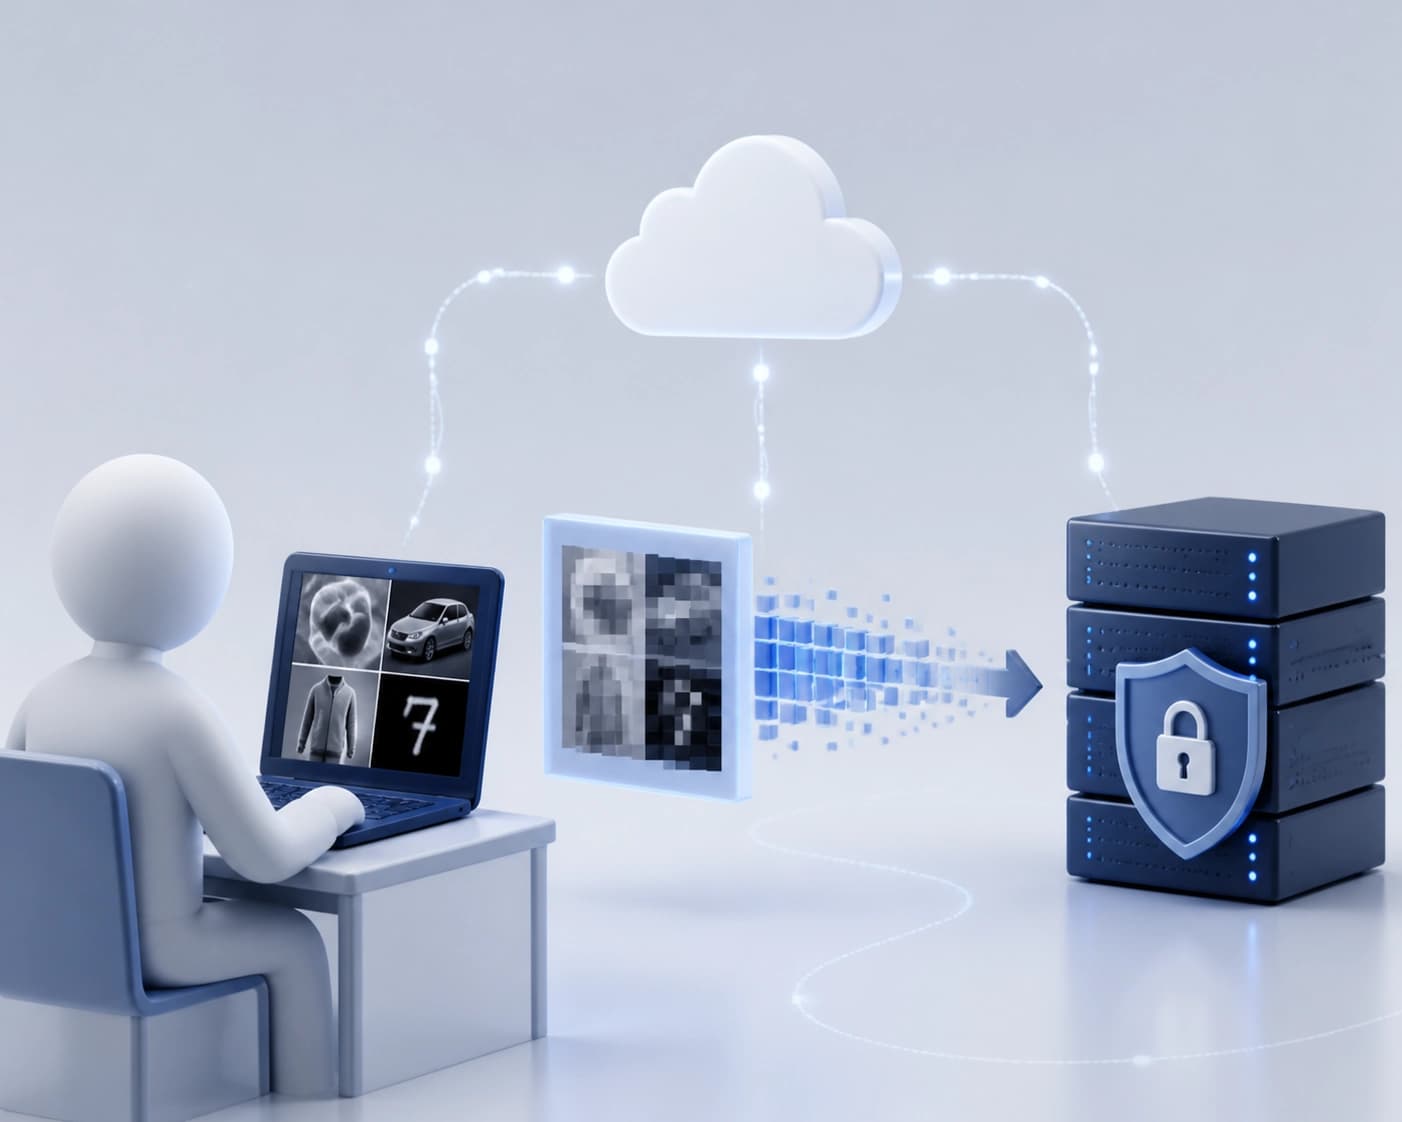
FedPix : transfert d’images compressées depuis le client pour réduire les fuites dans l’apprentissage fédéré
L’article examine quelles informations le client devrait être autorisé à envoyer au serveur et propose d’apprendre à transmettre des images compactes et vérifiables visuellement plutôt que des poids de modèle ou des représentations intermédiaires. Sur BloodMNIST, CIFAR-10, FashionMNIST et MNIST, cette approche affiche un faible PSNR lors de la reconstruction et réduit le temps côté client jusqu’à 96,0 %, avec une précision de 65,63 à 99,18 %.
15 novembre 2026
MaRK : modulation contextuelle des paramètres récurrents dans les SSM préentraînés
Une approche est proposée pour adapter au contexte l’opérateur récurrent d’un modèle d’espace d’états gelé au moyen de modifications de paramètres de faible rang, en agissant sur le noyau « entrée-sortie » à chaque étape de génération. La comparaison de trois géométries d’adaptateurs montre que les polynômes de Tchebychev offrent une meilleure erreur de validation, tandis que la paramétrisation contrainte permet une vérification analytique de la stabilité.
14 novembre 2026