Une longue tâche d'agent de codage, ce n'est pas une seule requête, mais des dizaines : appels au modèle, sollicitations d'outils, modifications de fichiers, exécutions répétées des tests. Et à presque chaque exécution surgit l'idée : et si on changeait de modèle tout de suite ?
Pourquoi le changement en cours de route semble avantageux
L'économie est simple ici. Un modèle puissant coûte plus cher par token, mais raisonne mieux. Un modèle faible coûte moins cher, mais cale sur le complexe. D'où deux manœuvres naturelles :
- L'escalade — quand le modèle bon marché est bloqué, on branche le cher et puissant.
- La rétrogradation — quand la partie difficile est derrière, on revient au bon marché pour ne pas surpayer la routine.
Sur le papier, la route hybride semble idéale : le modèle cher n'est payé que là où il est réellement nécessaire. Mais l'agent ne transmet pas seulement à la modèle suivante les fichiers et l'état du dépôt. Il transmet l'historique : la chaîne de raisonnement, les sorties d'outils, les tentatives sans issue, les décisions intermédiaires. La partie réceptrice poursuit la trajectoire construite par un autre modèle — avec un autre style, un autre degré de détail, d'autres habitudes. C'est précisément ce point qu'analysent les auteurs du préprint « The Handoff Tax: Continuing Non-Native Trajectories in LLM Agents » (arXiv:2608.24358, 25 août 2026).
Comment l'expérience est structurée
Le travail s'appuie sur des paires de modèles : les bon marché et moins capables (dans le texte de l'article — LC, low cost) contre les chers et plus forts (HC, high cost). Les paires sont issues de deux familles — Claude et GPT, c'est-à-dire que la vérification ne portait pas sur un seul fournisseur, mais sur deux à la fois, ce qui augmente sensiblement la valeur des conclusions.
Trois choses ont été modifiées :
- La direction de la transmission — vers le haut, vers un modèle plus fort, et vers le bas, vers un plus faible.
- Le moment du basculement au sein d'une longue tâche.
- Le format de transmission du contexte — ce que les auteurs appellent l'interface.
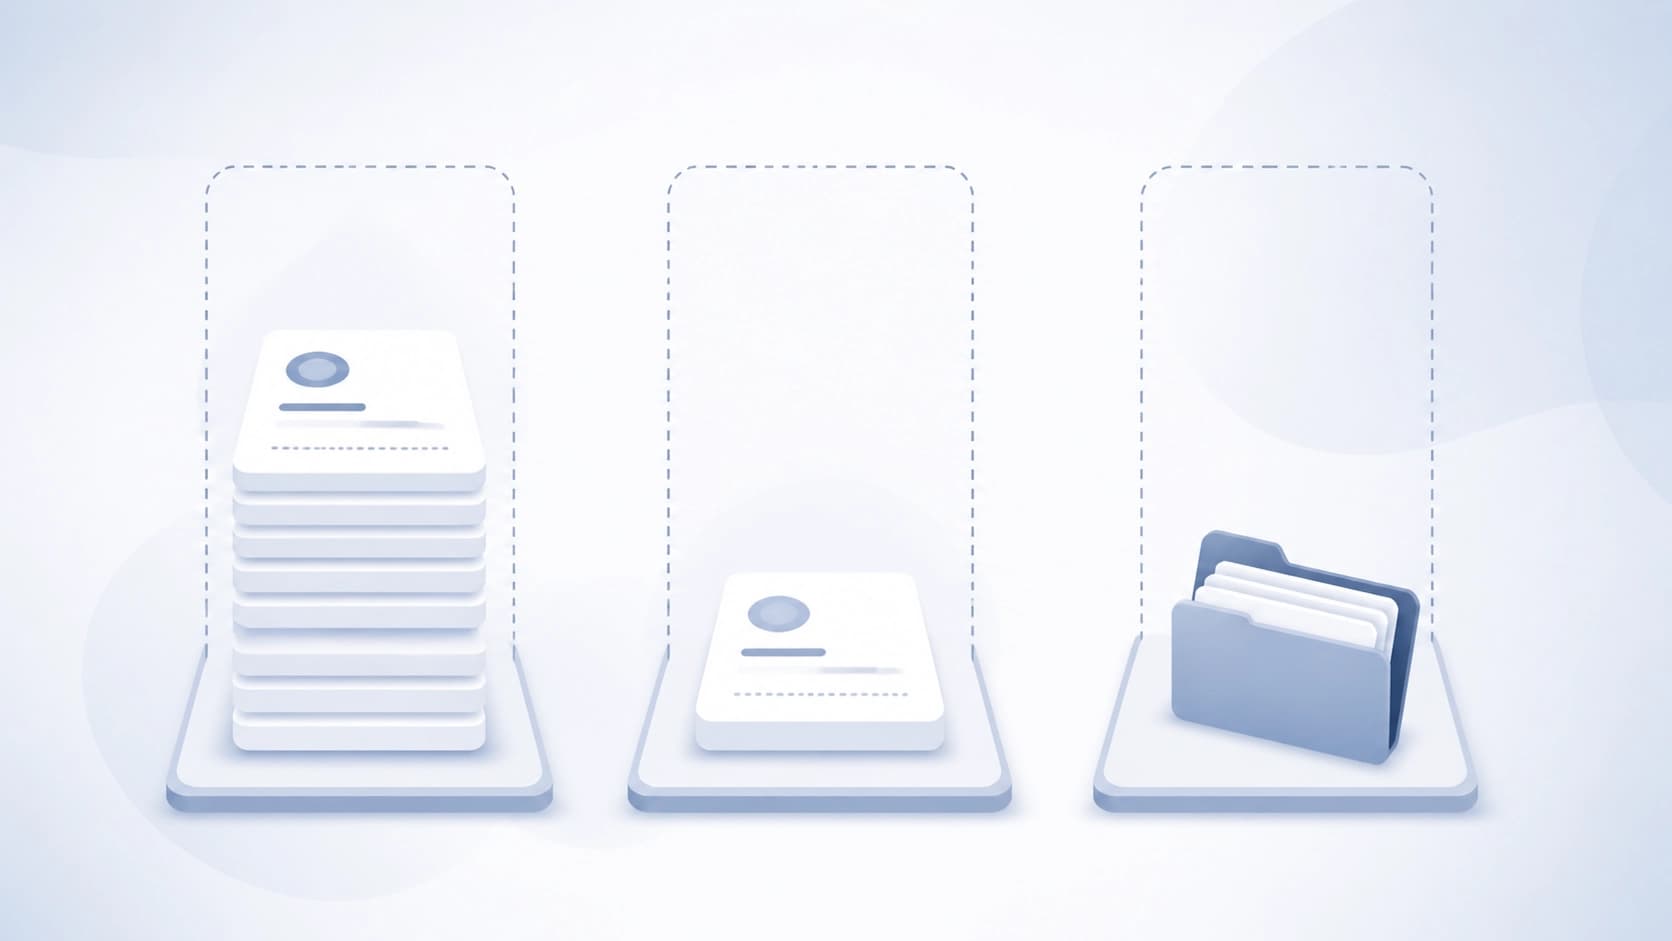
Le dernier point est le plus intéressant. Trois variantes ont été comparées : la transmission complète de toute la trajectoire, la compaction (un condensé de l'historique) et la suppression de la trajectoire en ne conservant que l'état du dépôt. Autrement dit, la question posée était : combien de « pensée » d'autrui vaut-il la peine de montrer au nouveau modèle ?
Résultat principal : la taxe sur la transmission
La conclusion s'est révélée dégrisante. Lors de l'escalade, la transmission complète de l'historique comble moins de la moitié de l'écart de qualité entre le modèle faible et le modèle fort — et s'accompagne d'un surcoût sensible. Autrement dit, vous payez au tarif du modèle cher, mais vous n'obtenez qu'une partie de son avantage. C'est cette différence que les auteurs ont appelée handoff tax — la taxe sur la transmission du contrôle.
Et ce n'est pas un artefact d'un seul fournisseur : le tableau s'est répété dans les deux familles. L'explication logique — le modèle fort dépense du contexte à démêler le labyrinthe d'autrui, reprend partiellement les hypothèses erronées de son prédécesseur et démarre non pas sur une page blanche, mais avec un fardeau. Une partie de ses capacités part à « lire le journal intime d'autrui » au lieu de résoudre la tâche.
Asymétrie : vers le bas — oui, vers le haut — avec des réserves
L'observation la plus utile est que la taxe n'est pas symétrique. La rétrogradation, au contraire, a donné un point avantageux en termes de rapport prix-qualité : le basculement vers un modèle bon marché après l'achèvement d'un raisonnement complexe fonctionne.
Plus intéressant encore, le format préférable de transmission du contexte s'inverse selon la direction :
- Lors de l'escalade, la réduction des informations sur la trajectoire du modèle faible aide davantage. Moins de déchets — un départ plus propre.
- Lors de la rétrogradation, la suppression de la trajectoire du modèle fort fait baisser la qualité. Ici, l'historique sert d'appui, et il vaut la peine de le conserver.
L'explication s'impose d'elle-même : le modèle faible traîne derrière lui une trace d'impasses, et celle-ci ne fait que gêner le modèle fort. Tandis que derrière le modèle fort — un plan éprouvé et des décisions correctes, sur lesquels le faible peut avancer comme sur des rails. C'est déjà mon interprétation, et non la conclusion littérale de l'article, mais elle s'accorde bien avec les chiffres.
Que faire en pratique
Les conclusions pratiques sont les suivantes :
- Basculez moins souvent que vous ne le souhaitez. Chaque basculement n'est pas une opération gratuite, mais une transaction à prix inconnu.
- Escaladez à la frontière, pas « quand vous êtes bloqué ». Un bon point, c'est un cycle achevé avec un échec clair (par exemple, des tests qui échouent systématiquement), et non le milieu d'une réflexion.
- Vers le haut — compressez, vers le bas — conservez. Avant de transmettre au modèle fort, rassemblez un condensé compact : ce qui a déjà été fait, ce qui n'a pas fonctionné, quelles sont les contraintes. Cela ne vaut pas la peine de laisser la transcription complète des tentatives.
- Vers le bas, on peut donner généreusement. Il est utile pour le modèle faible de voir le plan et les modifications laissés par le fort.
- Calculez votre propre taxe. La différence entre « historique complet » et « compaction » lors de l'escalade — c'est un A/B test tout prêt, qui vaut la peine d'être lancé sur vos propres tâches : il est bon marché et montre rapidement si vous payez la taxe ou non.
Une réflexion à part : parfois, il est moins cher de ne pas changer de modèle du tout en cours de route. Si le modèle fort n'est nécessaire que pour la planification, il est plus logique de répartir les rôles à l'avance — le plan par le fort, l'exécution par le faible — plutôt que d'organiser une transmission du contrôle au sein d'une même trajectoire.
Bilan
Changer de modèle au milieu d'une tâche n'est pas un levier gratuit d'optimisation du budget, mais une opération ayant son propre coût. La transmission de la trajectoire d'autrui consomme une partie de l'avantage pour lequel vous payez. L'escalade, en ce sens, est plus risquée qu'elle n'en a l'air ; la rétrogradation, au contraire, fonctionne de manière prévisible. Et le principal procédé pratique ne réside pas dans le choix du modèle, mais dans le choix de ce que précisément vous montrez à ce modèle. Les résultats ont été obtenus sur des agents de codage et des paires de modèles précises, il ne faut donc pas les transposer tels quels à tous les scénarios — mais comme hypothèse de travail pour vos propres mesures, ils conviennent tout à fait.