Trois modèles, une seule licence et aucune restriction
Granite 4.2 n'est plus un assistant taillé pour le suivi d'instructions, comme l'étaient les versions précédentes de la gamme. IBM a restructuré la famille autour d'un raisonnement explicite : chacun des modèles énonce d'abord une chaîne d'étapes, puis formule sa réponse. La version comprend trois tailles — 3B, 8B et 30B de paramètres.
La vraie nouvelle pour les entreprises ne réside pas dans les benchmarks, mais dans la licence. Les trois modèles sont distribués sous Apache 2.0 : le téléchargement, le fine-tuning et le déploiement en production n'exigent ni autorisations supplémentaires, ni restrictions d'usage commercial. Pour les entreprises des secteurs réglementés, la possibilité de conserver les poids en on-prem l'emporte souvent sur n'importe quelle ligne des tableaux de métriques.
Deux modèles vocaux Granite Speech 5.0 Turbo CTC de 470 millions de paramètres chacun sont sortis en parallèle — ils sont traités séparément plus bas.
Le mode de fonctionnement se bascule directement dans le chat-template. Il y a le thinking, le non-thinking, et entre les deux le low-effort : un budget de raisonnement court pour les questions simples, afin de ne pas gaspiller de tokens là où la tâche ne le justifie pas. En substance, un même modèle couvre à la fois le « réfléchis sérieusement » et le « réponds vite ».
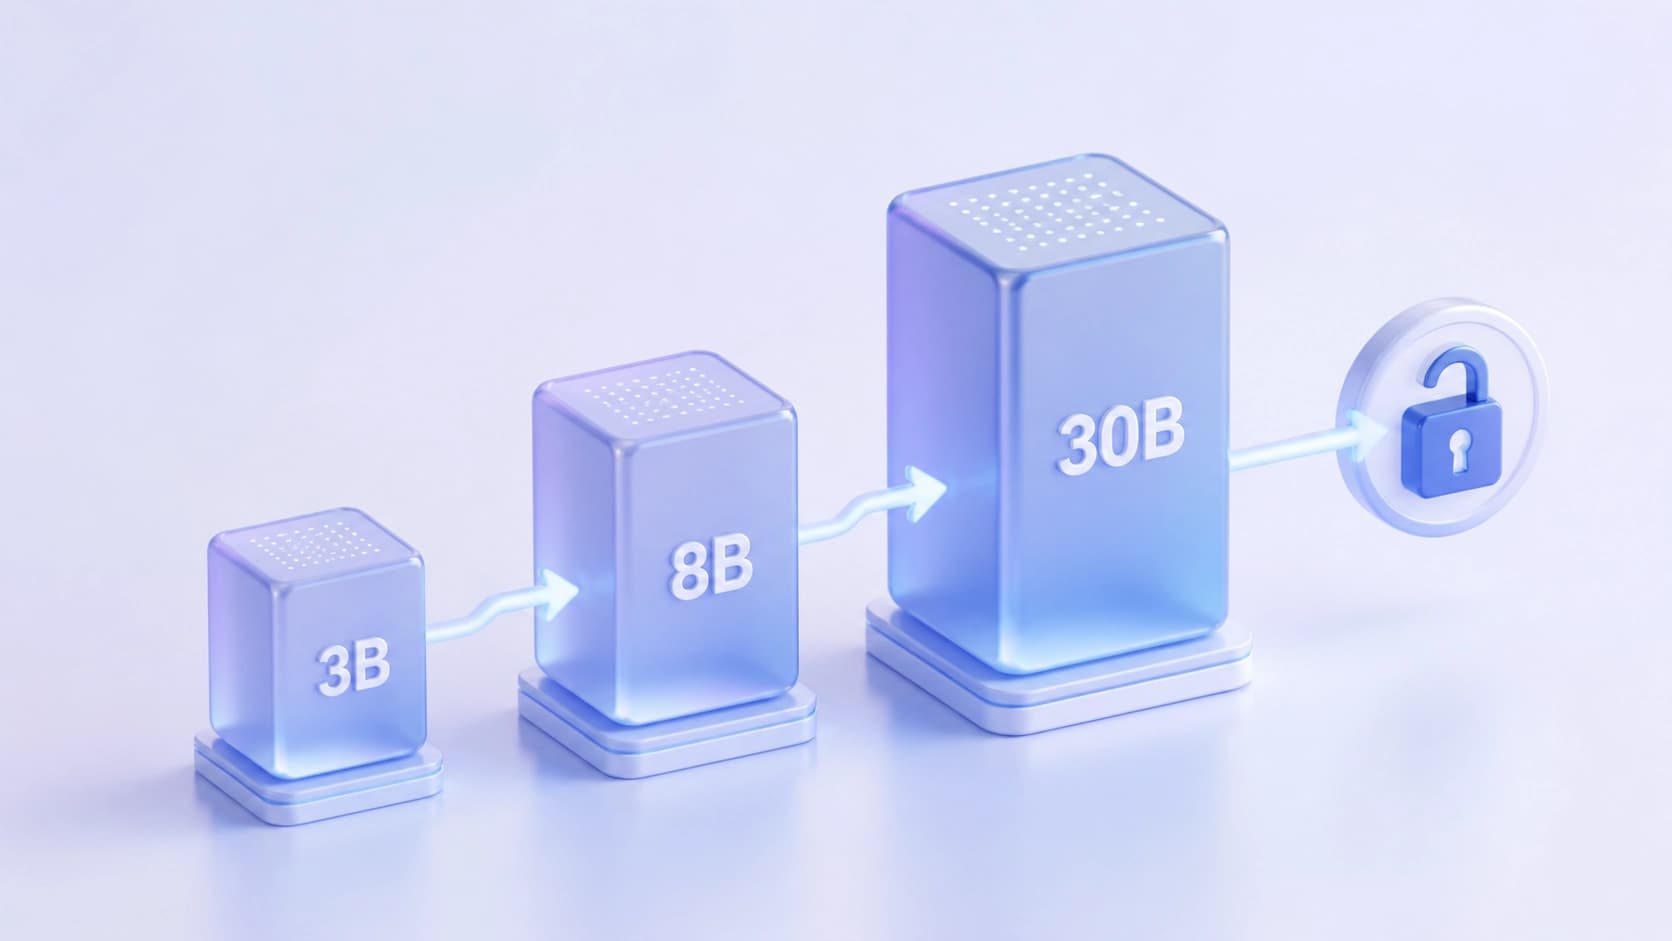
Quelle taille pour qui
3B — l'ordinateur portable d'un développeur individuel
Le petit modèle s'adresse aux développeurs indépendants et aux petites startups. Il peut tourner en local via Ollama ou LM Studio, y compris sur les quantifications GGUF publiées jusqu'à Q4_K_M. C'est le scénario « installé sur un portable et on expérimente sans facture d'API ».
8B — un GPU moderne pour toute une équipe
La taille intermédiaire vise les équipes du mid-market : un seul GPU récent suffit pour maintenir le modèle en environnement de travail.
30B — le périmètre d'entreprise
La version supérieure exige une puissance de niveau A100 ou H100, ainsi qu'une exploitation en FP8 ou NVFP4 sur vLLM. En revanche, c'est le cas où le modèle peut être installé à l'intérieur du périmètre et où les données ne sortent pas.
Les secteurs qu'IBM cible explicitement : le développement logiciel et les outils pour développeurs, les services financiers, la santé, les télécoms, le secteur public et les centres de contact — ces derniers précisément pour les nouveaux modèles vocaux. Les scénarios typiques : agents d'écriture de code, automatisation du terminal et du DevOps, recherche approfondie et recherche d'information, RAG sur de longs documents, appel structuré d'outils et transcription de masse.
Architecture : un transformer dense sans artifices
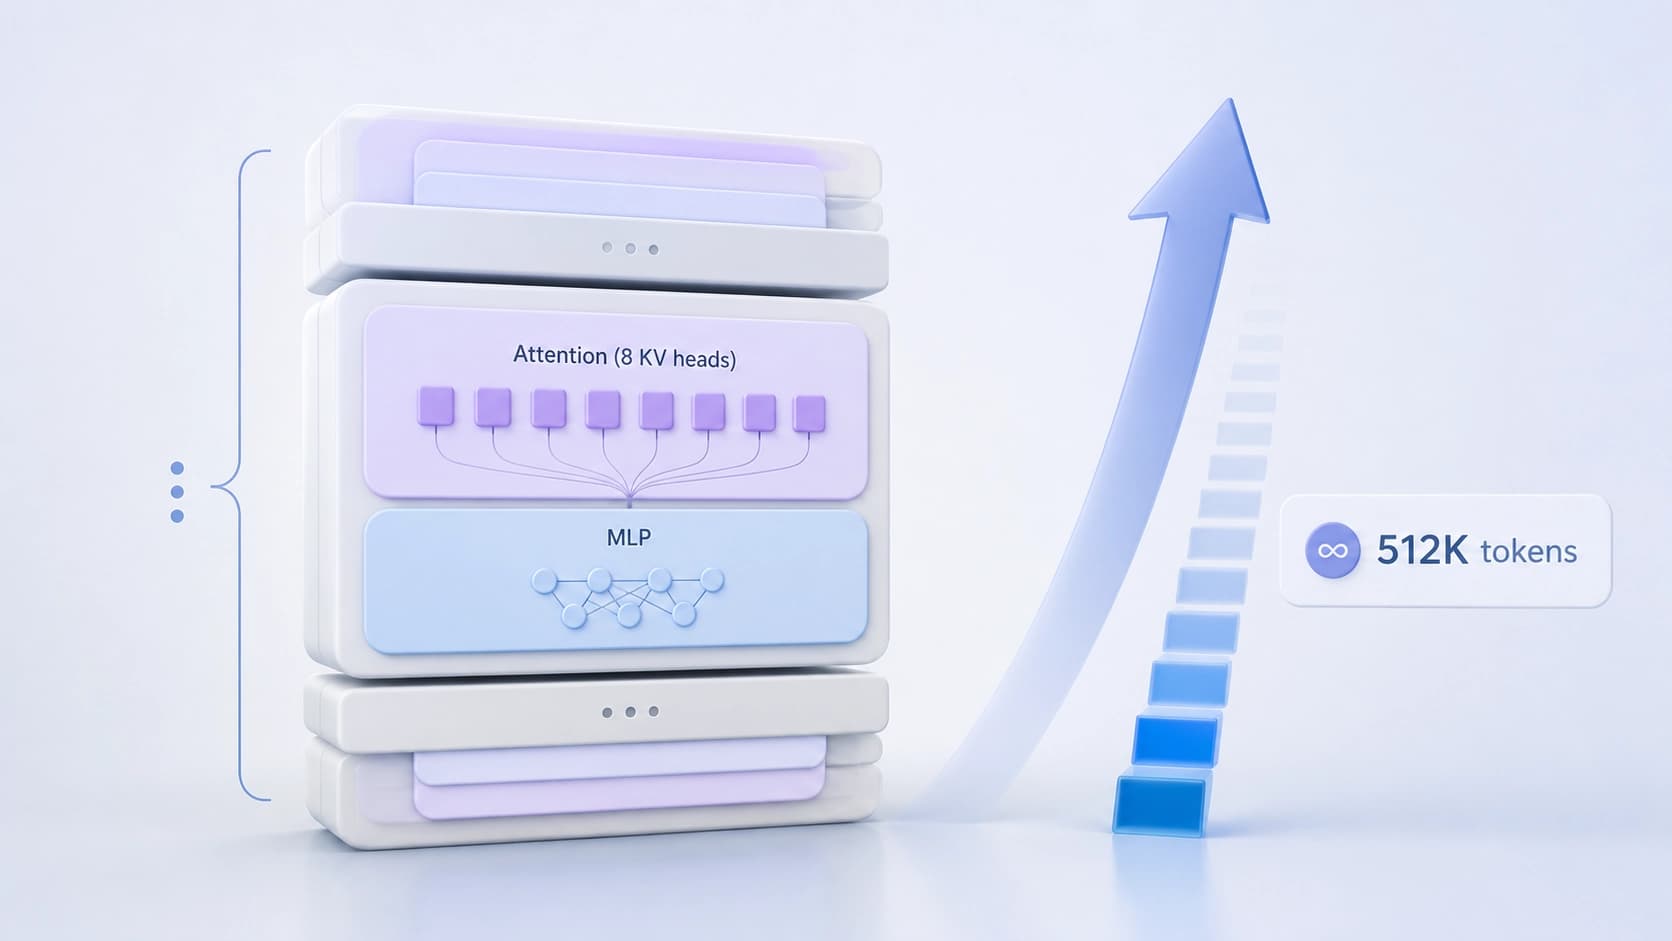
Granite 4.2 est un transformer dense decoder-only. Aucune hybridation, aucun mixture-of-experts : le pari est mis sur la prévisibilité du comportement et la simplicité du déploiement, ce qui est logique pour un périmètre d'entreprise.
Parmi les détails techniques :
- Grouped Query Attention avec 8 têtes KV ;
- RoPE avec θ = 10 000 000 ;
- SwiGLU dans le MLP ;
- RMSNorm avec ε = 1e-5 ;
- embeddings d'entrée et de sortie non liés ;
- précision bfloat16.
Les tailles diffèrent ainsi : le 3B compte 40 couches et des embeddings de 2560, le 8B a les mêmes 40 couches mais des embeddings de 4096, le 30B compte 64 couches et une dimension cachée de MLP de 32 768.
Le tableau d'architecture publié indique une longueur de séquence de 131 072 tokens, soit 128K. Le pré-entraînement s'est déroulé en cinq phases et comprenait une étape de contexte long allant jusqu'à 512K tokens. L'entraînement depuis zéro a porté sur environ 15 000 milliards de tokens.
Entraînement : SFT, puis un RL multi-étapes
L'étape de supervised fine-tuning s'est appuyée sur environ 7,2 millions d'échantillons — près de 100 milliards de tokens, dont environ 65 milliards entraînables. Le mélange de données se répartit ainsi : 31,6 % d'exemples agentiques contre 68,4 % de non-agentiques, l'ingénierie logicielle représentant 69 % de la partie agentique.
Les trajectoires ont été collectées dans des harnais — parmi eux OpenHands, SWE-agent, Terminus-2, MiniSWE, Codex et Goose. La qualité a été filtrée de deux manières : GPT-OSS-120B et Gemma 4 ont joué le rôle de juges, et une déduplication par SHA-256 sur les champs tools et messages a été appliquée.
Le post-entraînement n'est pas une passe unique, mais une chaîne de RL sur plusieurs environnements. Chaque étape constitue une exécution asynchrone distincte de GRPO, warm-startée depuis le checkpoint précédent ; au lieu d'un value-network, on utilise une baseline leave-one-out, et un échantillonnage d'importance tronqué limite la dérive en off-policy. L'ordre est le suivant : d'abord RLVR, puis les skill boosters, ensuite SWE, Terminal et Search, et enfin RLHF.
C'est là que se trouve la limitation la plus importante de cette version : le bloc de RL agentique n'a été appliqué qu'aux 8B et 30B. Le petit 3B ne passe qu'un RL de base et un alignement — et c'est en grande partie ce qui explique l'écart de capacités entre les tailles. L'entraînement s'est déroulé sur NeMo-RL et NeMo-Gym sur un cluster NVIDIA GB200 NVL72 hébergé chez CoreWeave. Le pipeline intègre en outre 1 000 milliards de tokens de code synthétique issus de CodeAlchemy et une couche de décodage spéculatif pour accélérer le service.
Ce que montrent les métriques d'IBM
Les chiffres sont annoncés par IBM elle-même, il faut donc les lire comme un repère et non comme une vérification indépendante. L'ordre des valeurs est 3B / 8B / 30B :
- SWE-Bench Verified : pas d'évaluation pour le 3B, 47.6 pour le 8B, 57.00 pour le 30B ;
- Terminal-Bench 2.1 : 20.56 et 29.24 respectivement ;
- τ³-bench : 50.99 / 66.34 / 68.05 ;
- BFCL v4 : 52.41 / 50.29 / 61.39 ;
- AIME25 : 78.33 / 86.67 / 89.17 ;
- GPQA : 54.80 / 64.14 / 66.41 ;
- MMLU-Pro : 67.84 / 74.04 / 77.60 ;
- RULER 128K : 55.30 / 71.41 / 81.38.
Détail curieux — dans le test d'appel de fonctions, le 8B est légèrement en retrait par rapport au 3B (50.29 contre 52.41). C'est un rappel que la taille ne garantit pas à elle seule un avantage sur chaque compétence prise isolément, et que choisir un modèle adapté à la tâche importe plus que courir après le checkpoint le plus haut.
Voix : 470 millions de paramètres sans backbone LLM
Les Granite Speech 5.0 Turbo CTC vocaux sont conçus de manière fondamentalement différente des systèmes ASR habituels basés sur des modèles de langage : ici, aucun backbone LLM n'est utilisé, et la conversion audio-texte s'effectue via connectionist temporal classification. D'où la compacité — 470 millions de paramètres.
IBM annonce un RTFx d'environ 12 600 sur un seul H200, alors que les actuels leaders de vitesse du Open ASR leaderboard affichent environ 6 000. Pour les centres de contact traitant de gros volumes d'enregistrements, l'écart de débit se traduit directement en argent. On peut essayer le modèle dans une démonstration sur WebGPU.
En résumé
IBM a assemblé un produit prévisible pour le marché de l'entreprise : des modèles denses sans exotisme architectural, une licence ouverte, un déploiement sur son propre matériel et des modes de raisonnement adaptés à différents types de tâches. Les capacités agentiques sont concentrées dans les 8B et 30B, il est donc logique de percevoir le 3B comme un point d'entrée peu coûteux et un modèle pour des scénarios simples, plutôt que comme un « petit frère » sans compromis. Les détails sont à vérifier dans le blog d'IBM Research, la description technique et le dépôt GitHub, dont les liens sont fournis avec la version.