
Recherche locale des décalages de covariables pour les profils avec des prévisions peu fiables
L’article décrit un pipeline diagnostique qui identifie d’abord des groupes de patients interprétables pour lesquels le modèle affiche un faible niveau de confiance, puis vérifie la présence d’un décalage de covariables nuisible au sein de ces groupes. Lors d’expériences menées sur MIMIC-IV, avec trois tâches cliniques et trois décalages artificiels entre sous-groupes, cette approche a permis de localiser un décalage lié à l’âge, peu visible dans l’évaluation agrégée.
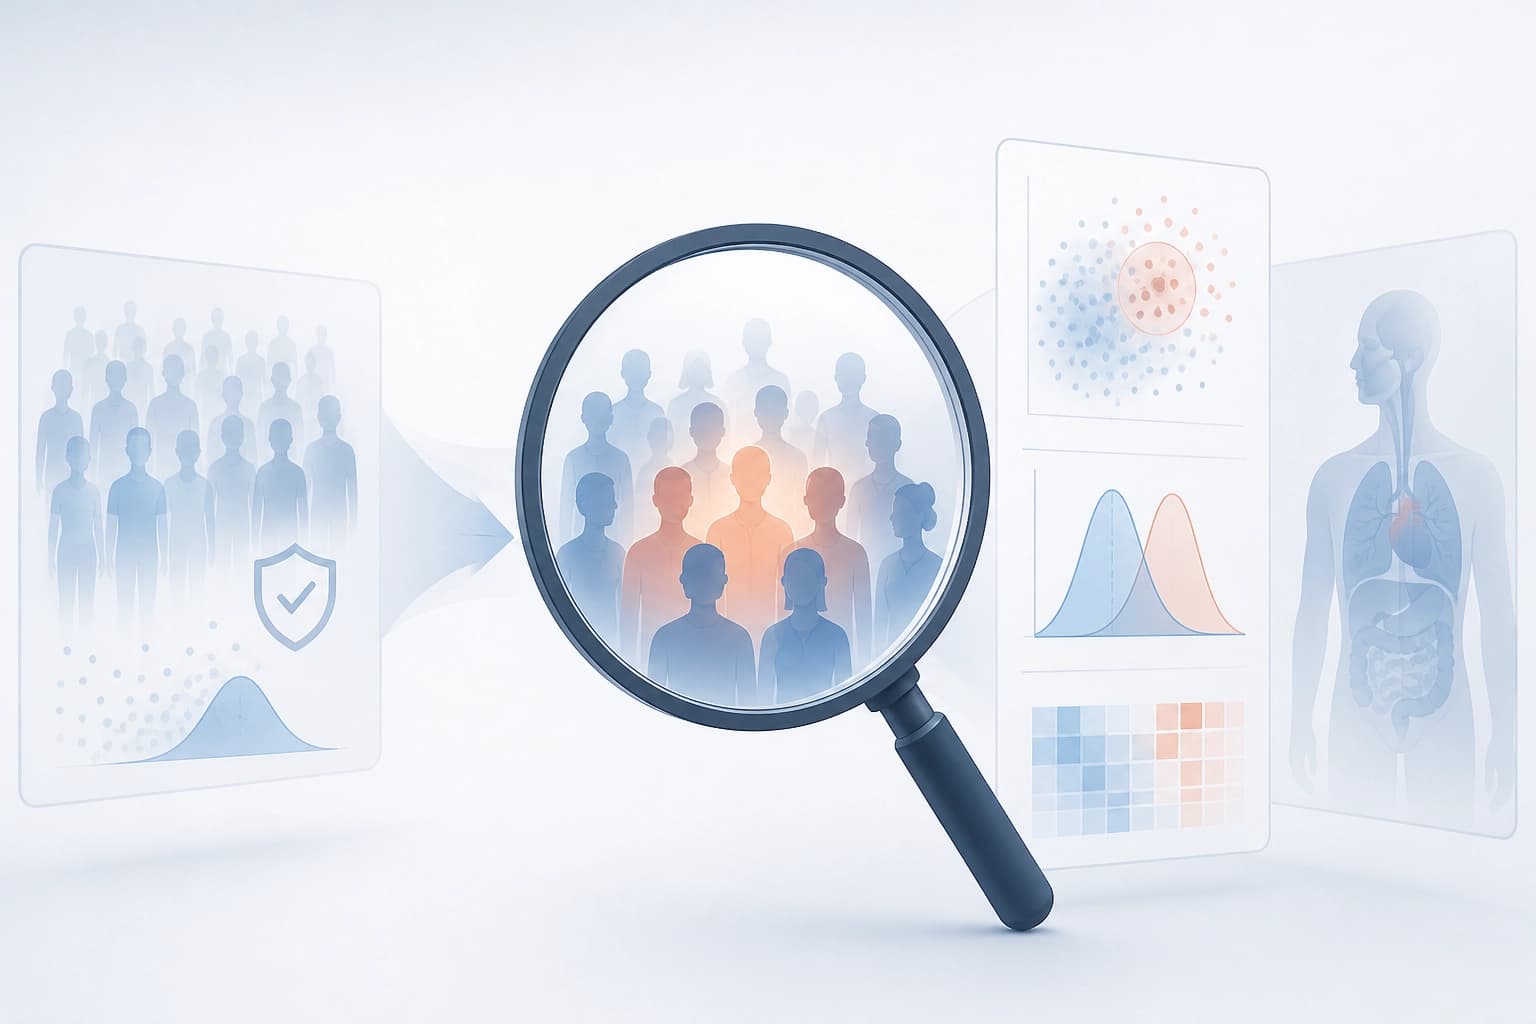
Pourquoi l’efficacité moyenne ne montre pas qui est touché
Avant de déployer des modèles cliniques de prédiction, leur fiabilité est évaluée. Cette évaluation est nécessaire pour une utilisation sûre. Les erreurs peuvent être dues à un décalage de distribution entre l’entraînement et le déploiement. Une autre cause est l’hétérogénéité de l’efficacité. Le modèle fonctionne systématiquement moins bien pour certains sous-groupes de patients.
La plupart des méthodes de diagnostic a posteriori évaluent la fiabilité à l’échelle de la population entière. Elles vérifient la similitude entre les données de déploiement et les données d’entraînement. Elles examinent aussi l’efficacité moyenne du modèle. L’hétérogénéité n’est pas prise en compte. Certains patients peuvent donc être touchés de manière disproportionnée.
| Critère | Diagnostic à l’échelle de la population | Recherche locale par profils |
|---|---|---|
| Ce qui est évalué | La similitude entre les données de déploiement et les données d’entraînement, ainsi que l’efficacité moyenne | Les profils à faible confiance et le décalage des covariables au sein du profil |
| Ce qui est mis en évidence | Un signal global de décalage ou de baisse | Les profils précis où l’efficacité s’est dégradée |
| Limite | Ne tient pas compte de l’hétérogénéité | Les décalages à grande échelle aident peu à localiser les personnes touchées |
| Rôle pratique | Surveillance générale | Vérification ciblée des prédictions peu fiables |
Critère : pour repérer les patients dont les résultats se dégradent de manière disproportionnée, le diagnostic à l’échelle de la population ne suffit pas. Une analyse par profils est nécessaire.
Comment fonctionne la recherche en deux étapes : profils et décalage local
Le pipeline divise le diagnostic en deux étapes. La première étape est MED3pa. Cette méthode identifie des profils de patients interprétables caractérisés par une faible confiance.
La deuxième étape est Detectron. Elle est appliquée à chaque profil. Elle vérifie si la baisse d’efficacité est associée à un décalage des covariables potentiellement néfaste. Cette vérification est effectuée au sein du profil, et non à l’échelle de la population entière.
Le processus se déroule par étapes :
- Construire des profils interprétables de patients caractérisés par une faible confiance.
- Pour chaque profil, vérifier si la baisse d’efficacité est liée à un décalage des covariables.
- Distinguer les profils où la baisse est liée à un décalage potentiellement néfaste et détectable.
- Comparer le résultat au diagnostic à l’échelle de la population.
Critère : choisir une approche qui identifie d’abord les profils, puis vérifie le décalage au sein de chacun d’eux. Une vérification unique à l’échelle de la population ne permet pas cette localisation.
Ce que les décalages liés à l’âge, au sexe et à la race ont révélé
L’étude porte sur trois tâches cliniques de prédiction. Trois décalages artificiels touchant des sous-groupes ont été introduits dans MIMIC-IV. Les résultats varient selon le type de décalage :
- Décalage lié à l’âge : il n’était pas visible à l’échelle de la population entière. Le pipeline MED3pa et Detectron l’a localisé dans des profils précis de patients dont l’efficacité s’était dégradée.
- Décalages liés au sexe et à la race : ils étaient largement détectables. Ils aidaient peu à déterminer quels patients étaient les plus touchés.
Critère : la recherche locale est particulièrement utile pour les décalages invisibles à l’échelle de la population entière. Un signal global n’indique pas à lui seul qui est le plus touché.
Quand la recherche locale convient aux profils peu fiables
Le pipeline s’appuie sur des profils à faible confiance et sur la vérification des décalages de covariables au sein de ces profils. Critères d’application :
- La tâche nécessite de repérer des profils précis où l’efficacité s’est dégradée.
- Le diagnostic à l’échelle de la population ne permet pas de localiser cette dégradation.
- Un décalage des covariables au sein du profil peut être détecté.
- Le résultat est interprété comme local, et non comme une évaluation de l’ensemble de la population.
- La conclusion est vérifiée sur plusieurs tâches et avec plusieurs décalages.
L’étude se limite à trois tâches cliniques et à trois décalages dans MIMIC-IV. L’article a été accepté à SMASH 2026. Il est impossible de transposer le résultat à d’autres données sans vérification.
Critère de choix : pour les profils dont les prédictions sont peu fiables, utiliser un diagnostic en deux étapes. Conserver l’évaluation à l’échelle de la population comme repère général. Prendre la décision en fonction de la vérification locale au sein du profil.
Foire aux questions
Matériaux connexes
Tous matériaux
Agents d’IA et logiciels d’entreprise : repenser les périmètres d’accès et la supervision en 2026
Cet article examine comment les agents d’IA autonomes s’intègrent aux processus informatiques et de cybersécurité des entreprises, et pourquoi cela nécessite de revoir les droits d’accès, la vérification des identités et les politiques de contrôle. Le lecteur découvrira un aperçu nuancé des outils et des pratiques qui façonnent la gestion des risques liés à ces systèmes en 2026.
15 novembre 2026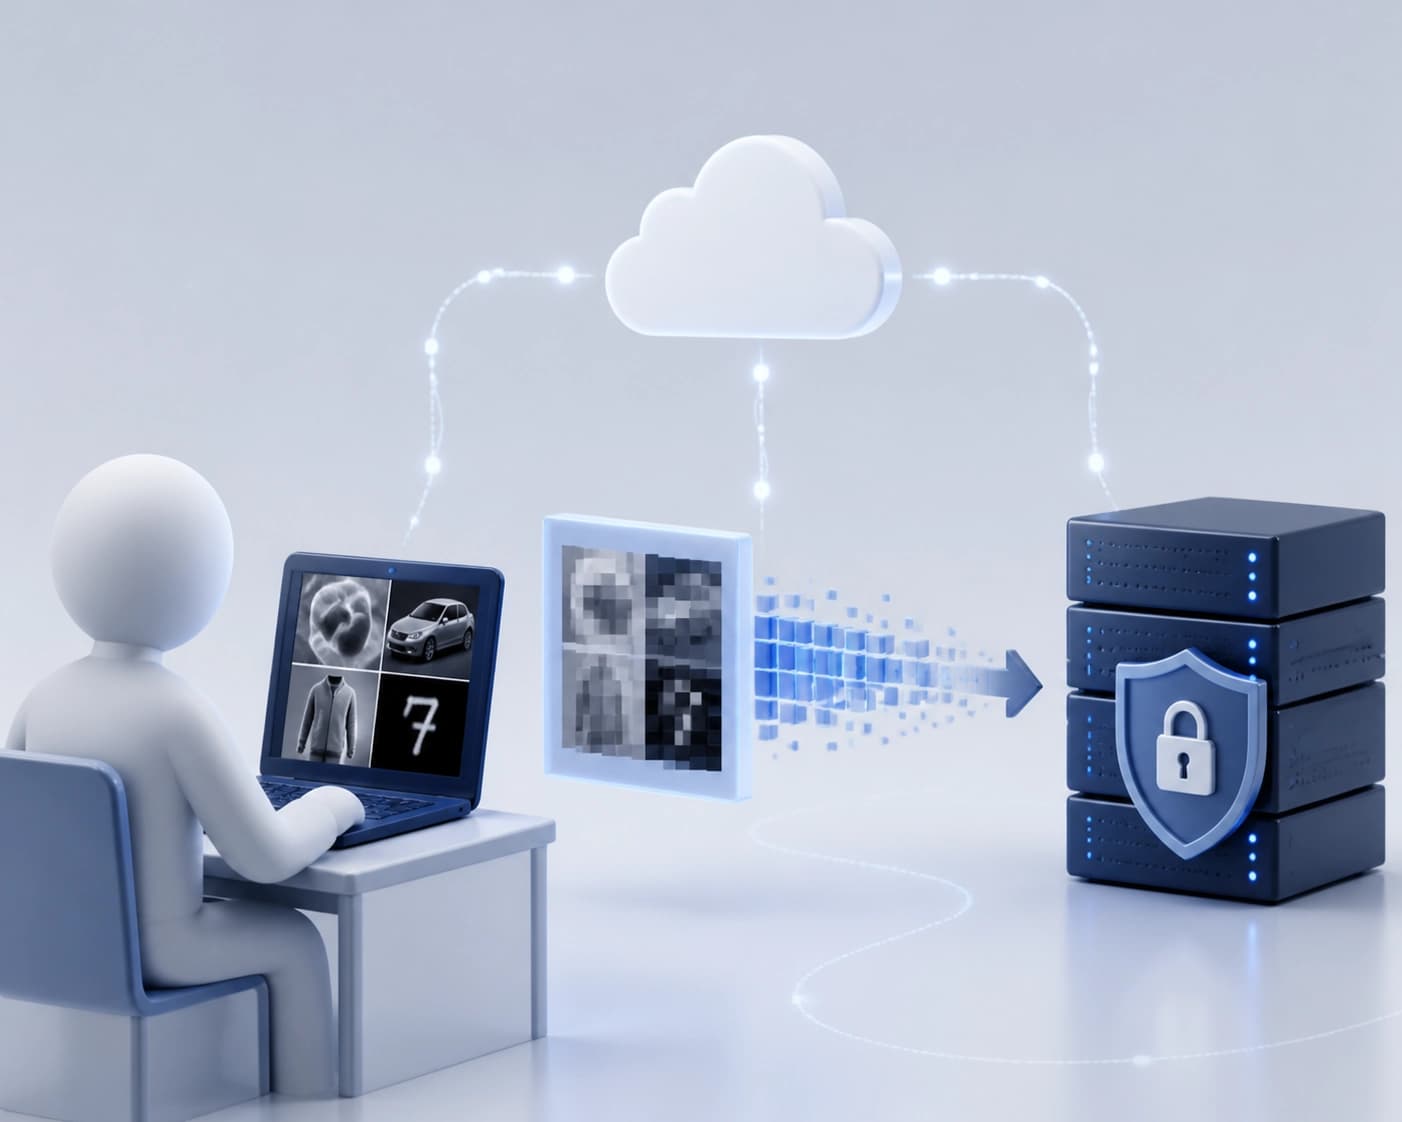
FedPix : transfert d’images compressées depuis le client pour réduire les fuites dans l’apprentissage fédéré
L’article examine quelles informations le client devrait être autorisé à envoyer au serveur et propose d’apprendre à transmettre des images compactes et vérifiables visuellement plutôt que des poids de modèle ou des représentations intermédiaires. Sur BloodMNIST, CIFAR-10, FashionMNIST et MNIST, cette approche affiche un faible PSNR lors de la reconstruction et réduit le temps côté client jusqu’à 96,0 %, avec une précision de 65,63 à 99,18 %.
15 novembre 2026
MaRK : modulation contextuelle des paramètres récurrents dans les SSM préentraînés
Une approche est proposée pour adapter au contexte l’opérateur récurrent d’un modèle d’espace d’états gelé au moyen de modifications de paramètres de faible rang, en agissant sur le noyau « entrée-sortie » à chaque étape de génération. La comparaison de trois géométries d’adaptateurs montre que les polynômes de Tchebychev offrent une meilleure erreur de validation, tandis que la paramétrisation contrainte permet une vérification analytique de la stabilité.
14 novembre 2026