
Système d’IA composite multi-agents avec boucle de validation fondée sur les preuves pour la planification en protonthérapie des tumeurs de la tête et du cou
Ce travail décrit une approche combinant une politique PPO entraînée, qui propose plusieurs options de plan, et des agents LLM menant un dialogue de clarification avec vérification des métriques cliniques et des contraintes ; sur un échantillon de 21 patients, Qwen3-14B, après affinage, a mieux suivi les instructions et contribué à orienter le compromis vers les objectifs prioritaires. La conclusion pratique est que la planification DRL automatisée peut être complétée par un dialogue guidé, tout en conservant le contrôle sur les contraintes concurrentes.
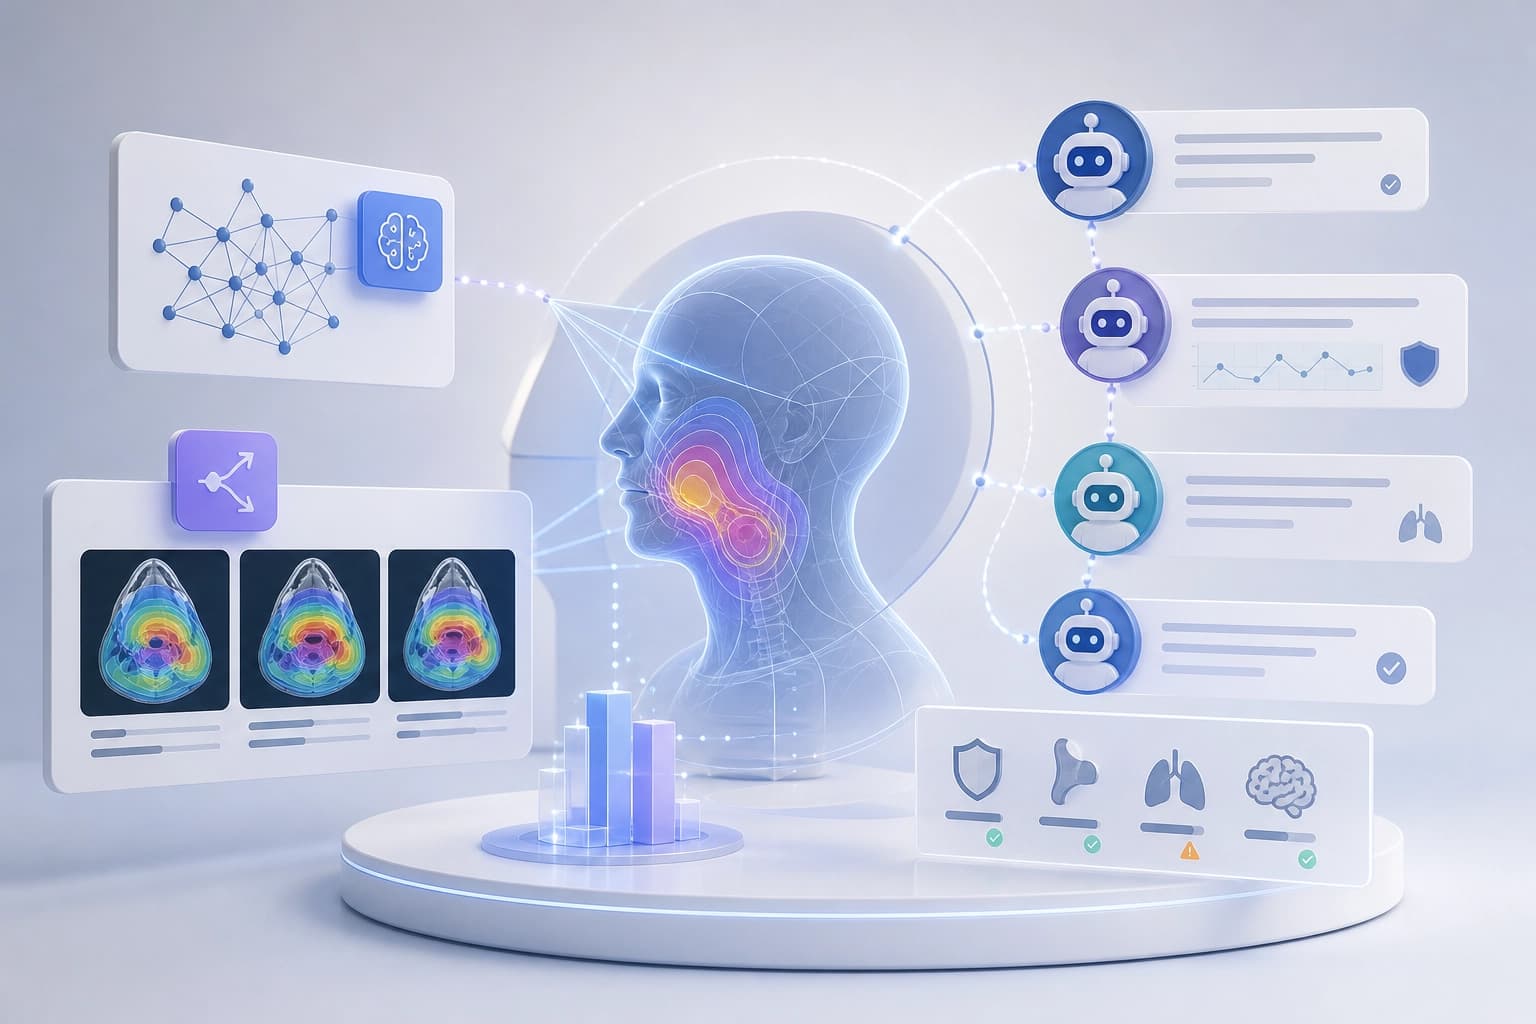
Architecture composite : génération et affinement
Qingqing Wang, Liqiang Xiao et Chang Chang ont publié un article sur arXiv le 21 oct. 2026 (arXiv:2610.29010). Ils y décrivent un système de protonthérapie PBS pour le cancer de la tête et du cou. Le système associe une planification automatique fondée sur le DRL à l’affinement des plans par dialogue à l’aide d’un LLM.
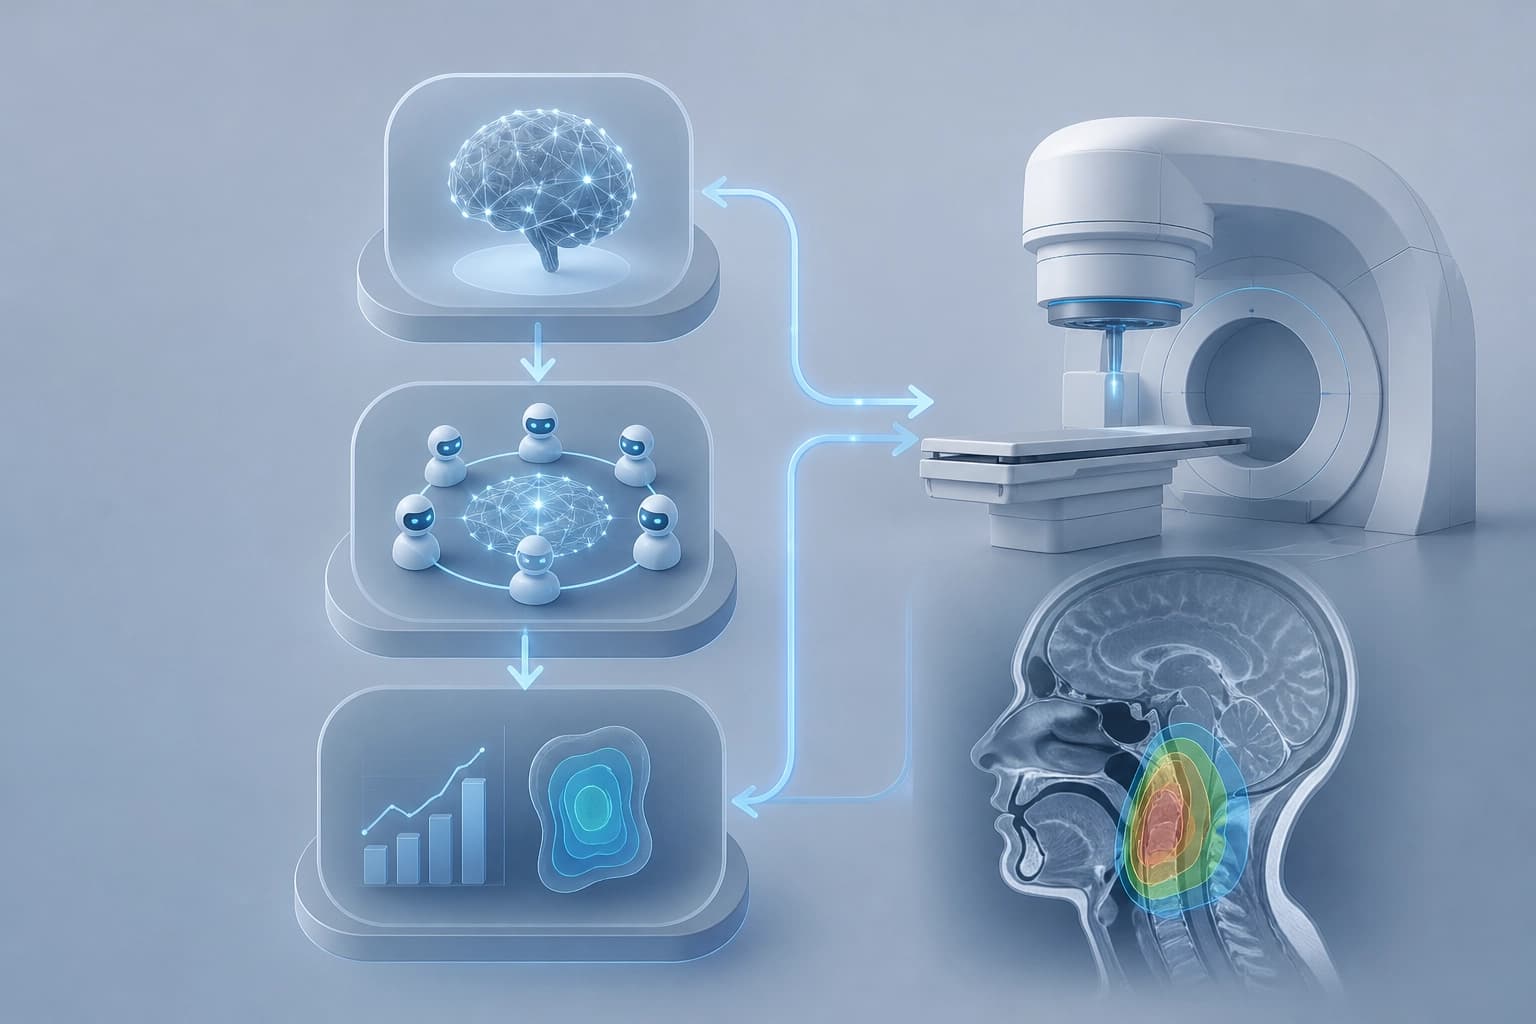
L’étape automatique fondée sur le DRL crée un ensemble de plans. Le système en sélectionne un comme plan cible et utilise les autres comme références lors de l’affinement. Pour les cas complexes, le système prévoit une architecture LLM multi-agent qui affine le plan au moyen d’un dialogue en langage naturel. Conclusion : le schéma dissocie la génération automatique de l’affinement dialogué fondé sur des données.
Génération automatique de plans avec PPO
L’étape automatique repose sur un réseau de politique PPO. Les auteurs ont entraîné le réseau sans intervention humaine ; il génère d’abord plusieurs plans. L’entraînement et l’évaluation ont été réalisés à partir des données de 21 patients atteints d’un cancer de la tête et du cou. Pour chaque patient, les auteurs ont généré 5 plans PPO.
Un ensemble de plusieurs plans fournit une base pour choisir le plan cible et constitue une référence pour l’affinement. Critère : la génération automatique doit produire un ensemble de plans, et non un seul. Le processus d’affinement pourra ainsi s’appuyer sur cette base.
Boucle d’affinement multi-agent
Pour les cas complexes, le système utilise une architecture LLM multi-agent. Elle affine le plan par interaction en langage naturel. La boucle comprend un agent de planification, un chatbot et un agent d’évaluation.
L’agent de planification propose des ajustements fondés sur les données. Le chatbot sert d’interface unique pour le dialogue. L’agent d’évaluation constitue un dispositif de vérification fondé sur des preuves : il extrait des métriques cliniques et détecte les violations des contraintes.
Cette boucle permet de vérifier l’affinement au moyen de métriques cliniques et de contraintes. Critère : l’affinement doit s’appuyer sur des indicateurs cliniques mesurables, et pas uniquement sur le texte du dialogue.
Entraînement de l’agent de planification
L’agent de planification repose sur Qwen3-14B. Il justifie ses recommandations à partir des données des plans créés précédemment. Pour l’entraînement complémentaire sur les tâches, les auteurs ont utilisé SFT et GRPO.
Par rapport au LLM de base, Qwen3-14B affiné a montré des capacités améliorées. Il suit mieux les instructions, extrait mieux les informations et raisonne mieux dans le domaine concerné.
| Critère | LLM de base | Qwen3-14B affiné |
|---|---|---|
| Suivi des instructions | Capacité de base | Capacité améliorée |
| Extraction d’informations | Capacité de base | Capacité améliorée |
| Raisonnement dans le domaine concerné | Capacité de base | Capacité améliorée |
Critère pratique : pour un agent de planification, la génération ne suffit pas ; le suivi des instructions, l’extraction des données et le raisonnement dans le domaine sont également importants. L’entraînement avec SFT et GRPO renforce ces qualités.
Évaluation et compromis cliniques
Les auteurs ont sélectionné 50 plans à affiner à l’aide d’instructions. Les ajustements amélioraient plus efficacement les objectifs prioritaires pour l’utilisateur. Dans le même temps, la dégradation des objectifs concurrents restait limitée. Les auteurs indiquent que les ajustements ont permis d’obtenir des compromis plus adaptés sur le plan clinique lors de l’affinement des plans en fonction du patient concerné.
Critère pratique : évaluer l’affinement en fonction de l’amélioration des objectifs prioritaires et de la dégradation limitée des objectifs concurrents.
Foire aux questions
Matériaux connexes
Tous matériaux
Sélection computationnelle plutôt que tâtonnements empiriques : nouvelles approches des matériaux pour batteries
L’article montre comment les bases de données de calcul, l’apprentissage automatique et les modèles génératifs réduisent le champ des compositions prometteuses, tandis que les laboratoires automatisés accélèrent leur validation ; le résultat dépend toutefois de la synthèse et des essais, car les prédictions peuvent différer de la conductivité réelle.
20 novembre 2026
Évolution des benchmarks d’agents à mesure que le pool de tâches s’agrandit : rôle de la sélection des preuves et des courses séquentielles
Ce travail explique pourquoi l’augmentation du nombre de tâches peut nuire à l’évolution des bancs d’essai d’agents : le problème vient du mauvais choix des éléments de preuve, et non du volume de données en soi. La méthode Successive Scale Racing sélectionne successivement des combinaisons de tâches variées et compare les candidats à faible coût ; sur trois benchmarks, elle a augmenté le taux d’exécutions réussies lorsque le pool est passé de 40 à 200 tâches, tandis que les méthodes de référence ont régressé, et a réduit d’environ 60 % le nombre d’exécutions de validation.
19 novembre 2026
Persuasion mutuelle entre modèles : les positions déclarées ne correspondent pas à leur comportement en dialogue
Dans des débats contrôlés sur les causes du changement climatique, quatre duos GPT-6 Luna et Gemini 2.5 Flash Lite présentent des dynamiques différentes de convergence ou de divergence des positions. La consigne directe de convaincre n’a pas d’effet durable, et la position déclarée ne correspond pas à la manière habituelle de débattre.
19 novembre 2026