
Gestion centralisée de la mémoire dans l’IA multi-agents : personnalisation à moindre coût
Les auteurs proposent une couche système de mémoire partagée : les agents enregistrent des informations structurées, tandis que le système contrôle leur sélection, la protection des données et leur transmission aux modèles. Lors des tests sur AIOS, cette approche a amélioré la personnalisation par rapport au stockage externe et au RAG, et a réduit la latence de 15 à 61 % par rapport à la transmission du contexte complet, avec des résultats comparables pour deux des trois modèles.
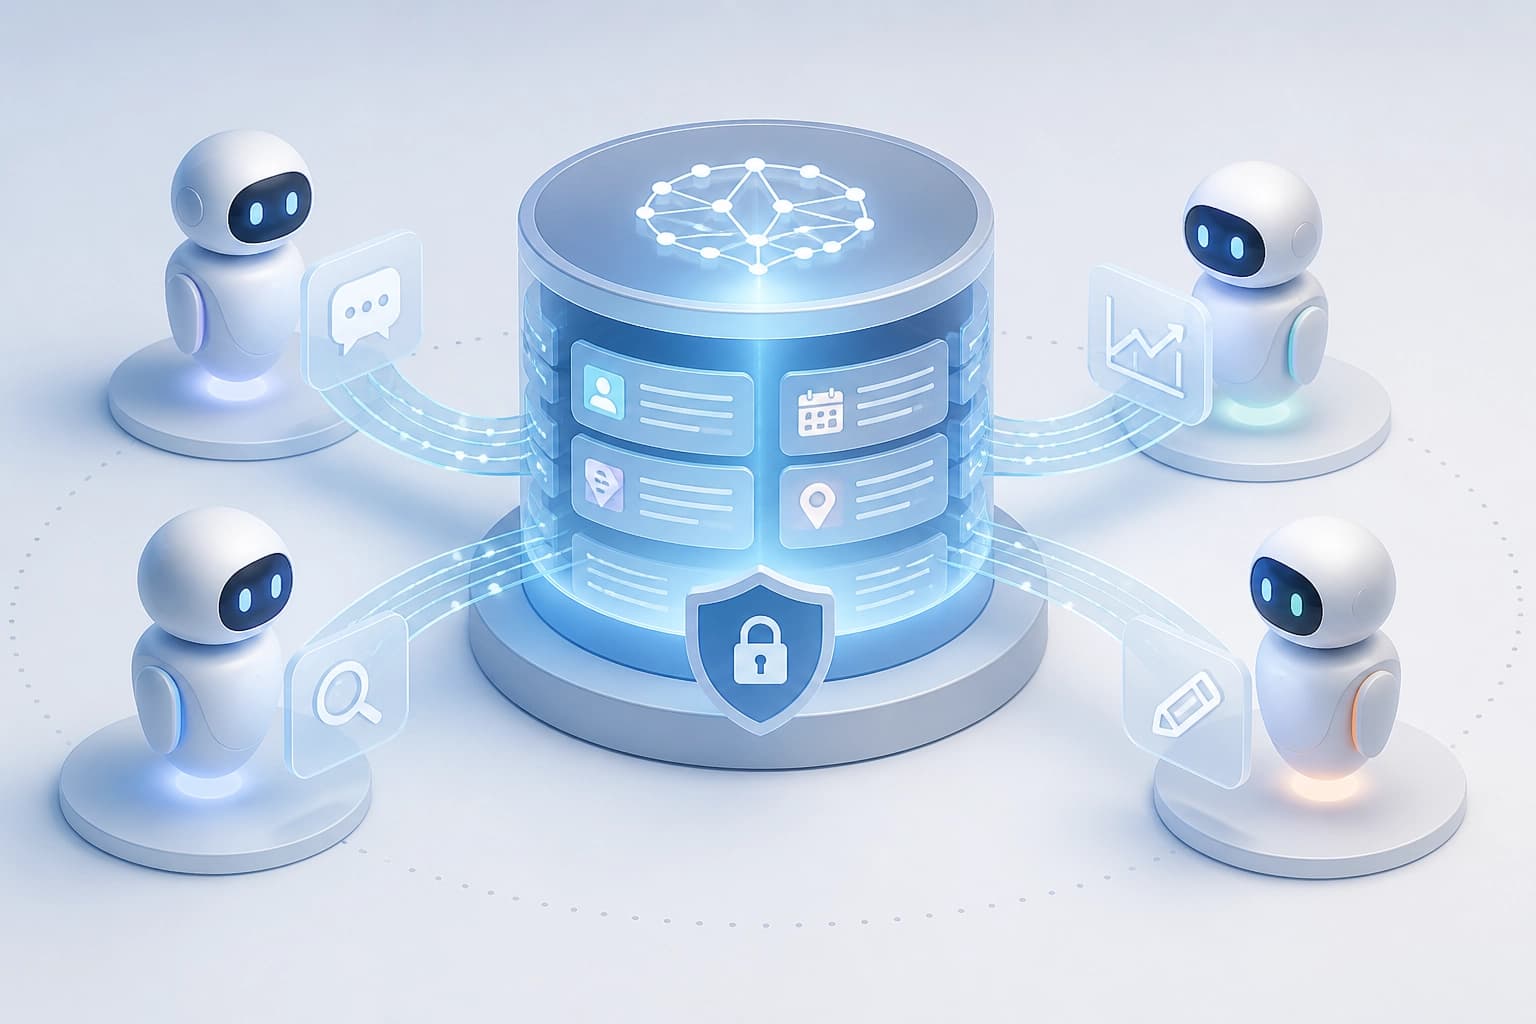
Comment fonctionne la mémoire centralisée
Les agents spécialisés enregistrent des souvenirs structurés et étiquetés. Le noyau du système multi-agent gère leur récupération, leur confidentialité et leur ajout au prompt.
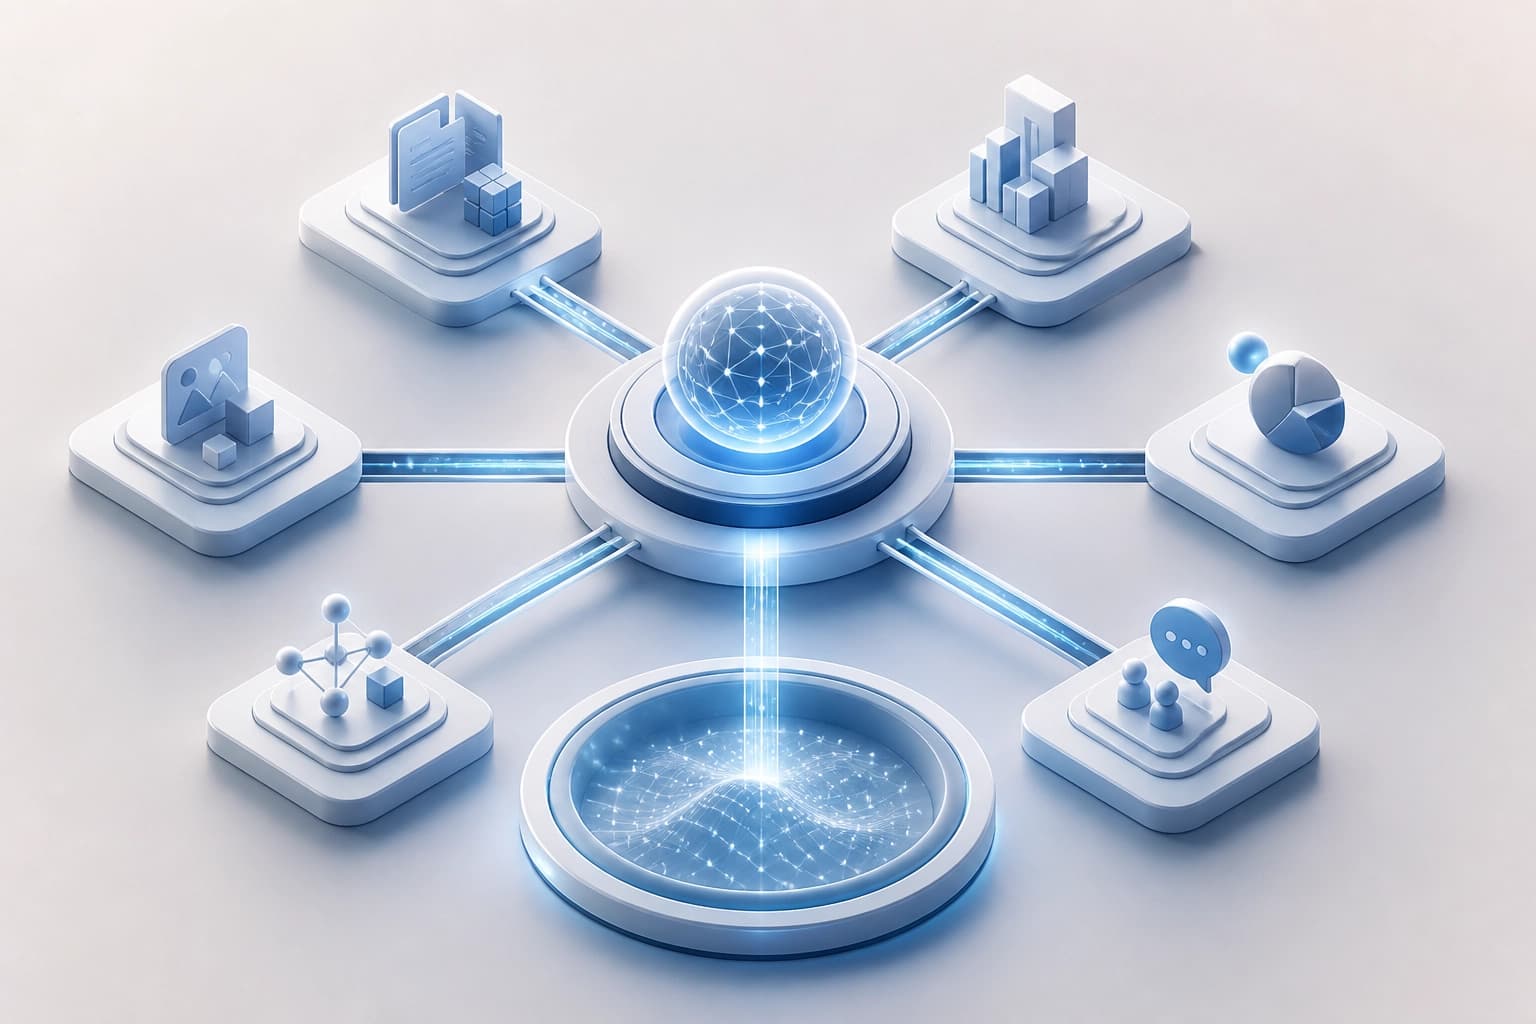
Dans cette architecture, les agents créent des souvenirs, tandis que le noyau détermine la façon dont le système les utilise :
- Enregistrement : les agents enregistrent des souvenirs structurés et étiquetés.
- Récupération : elle est gérée par le noyau, et non par des agents individuels.
- Protection et intégration : le noyau est responsable de la confidentialité et de l’ajout des souvenirs au prompt.
La centralisation sépare la création des souvenirs du contrôle de leur utilisation. C’est important lorsque les règles de récupération et d’intégration doivent s’appliquer à l’ensemble du système multi-agent.
Comment l’approche a été évaluée
La conception a été mise en œuvre et évaluée sur AIOS. Les auteurs l’ont comparée à trois solutions de remplacement avec trois modèles assistants.
- GPT-4o
- Llama-3.1:8B
- Qwen-2.5:7B
L’étude comprenait au total 1 800 essais. Cette partie du travail décrit l’ampleur de l’évaluation, et non les conditions individuelles de comparaison.
Résultats des comparaisons
Les résultats dépendent de la méthode de gestion de la mémoire. Le tableau présente les conclusions des auteurs pour les trois solutions de remplacement.
| Solution de remplacement | Résultat de la gestion centralisée |
|---|---|
| Mem0 avec le même stockage sous-jacent | Les scores de personnalisation ont augmenté de 2,4 à 4,0 points sur une échelle de cinq points. Chaque comparaison est statistiquement significative : p < 10^-18. |
| Intégration standard via la génération augmentée par récupération | Les gains ont été importants et constants sur les trois modèles. |
| Concaténation complète et non filtrée du contexte | Les résultats sont statistiquement comparables sur deux modèles ; sur le troisième, la variante centralisée a légèrement obtenu de moins bons résultats. Les prompts ont été raccourcis et la latence de bout en bout a diminué de 15 à 61 % sur tous les modèles. Le nombre de jetons par appel et le coût d’inférence ont également diminué. |
Pour GPT-4o, le score illustrant l’utilisation du profil est passé de 1,05 à 4,69. Cet indicateur illustre le résultat de la comparaison avec Mem0.
Quand envisager la centralisation
La gestion centralisée de la mémoire mérite d’être envisagée si le système a besoin de règles communes pour la récupération, la protection et l’intégration des souvenirs. Cette approche transfère ces décisions des agents individuels vers le noyau du système.
Un critère pratique consiste à mettre en balance le niveau de personnalisation requis avec le volume de contexte et les coûts acceptables. Les auteurs concluent que la centralisation offre la plupart des avantages de la personnalisation avec un contexte illimité, à un coût nettement inférieur.
L’article s’appuie sur Mémoire partagée gérée par le noyau pour une personnalisation à l’échelle du système de Ryan Lum et Yongfeng Zhang, soumis le 9 septembre 2026.
Foire aux questions
Matériaux connexes
Tous matériaux
Évaluation des agents de programmation pour le développement XR interactif : résultats de GenXR-Bench
GenXR-Bench est publié : un ensemble de 112 tâches expertes pour évaluer de bout en bout les agents de programmation dans le développement XR interactif, de l’amélioration de fonctionnalités et de la correction de défauts à la création d’applications dont le comportement est testé sur du matériel grand public. Parmi les dix modèles testés, le meilleur résultat a été de 50,9 % en Pass@1 ; les défaillances récurrentes concernent notamment la gestion des événements asynchrones des capteurs, l’ancrage des objets dans l’espace réel et la compréhension des interactions dans un contexte physique.
5 novembre 2026
De la récompense scalaire au front de Pareto : synthèse RTL par LLM avec apprentissage par renforcement multicritère
Une méthode est proposée pour entraîner un modèle de langage à générer non pas un seul schéma, mais un ensemble de candidats RTL offrant différents compromis entre surface, latence et consommation d’énergie ; la récompense est calculée en fonction de la contribution de chaque variante à l’hypervolume du front de Pareto. Sur RTLLM v2, l’hypervolume relatif a augmenté de 13,3 points de pourcentage par rapport à la version de base sans optimisation PPA et de 14,4 points de pourcentage par rapport à l’apprentissage par renforcement mono-objectif.
5 novembre 2026
Les LLM médicales sont informés des révisions des recommandations, mais répondent souvent selon les anciennes règles
L’étude de ChronoEvo portant sur 1 709 changements dans les recommandations cliniques montre que, dans le modèle principal, 90,8 % des réponses repéraient la nouveauté, mais que seules 58,5 % l’appliquaient intégralement, avec un écart de 32,3 points de pourcentage observé dans 14 modèles. Même en renforçant la visibilité des mises à jour, le transfert intégral des nouvelles règles dans les recommandations cliniques n’a pas connu de hausse significative.
4 novembre 2026