
CEG-Agent : analyse causale des échecs dans les traces d’agents LLM à l’aide de graphes d’erreurs
Ce travail présente CEG-Agent, un framework instrumenté pour le diagnostic causal des traces d’agents. Une classification formelle distingue les anomalies, les erreurs et les défaillances, tandis que les graphes typés CEG relient les événements d’exécution aux nœuds de diagnostic et aux échecs finaux ; le benchmark CEG-Bench confirme la supériorité de cette approche en matière de précision sémantique et structurelle.
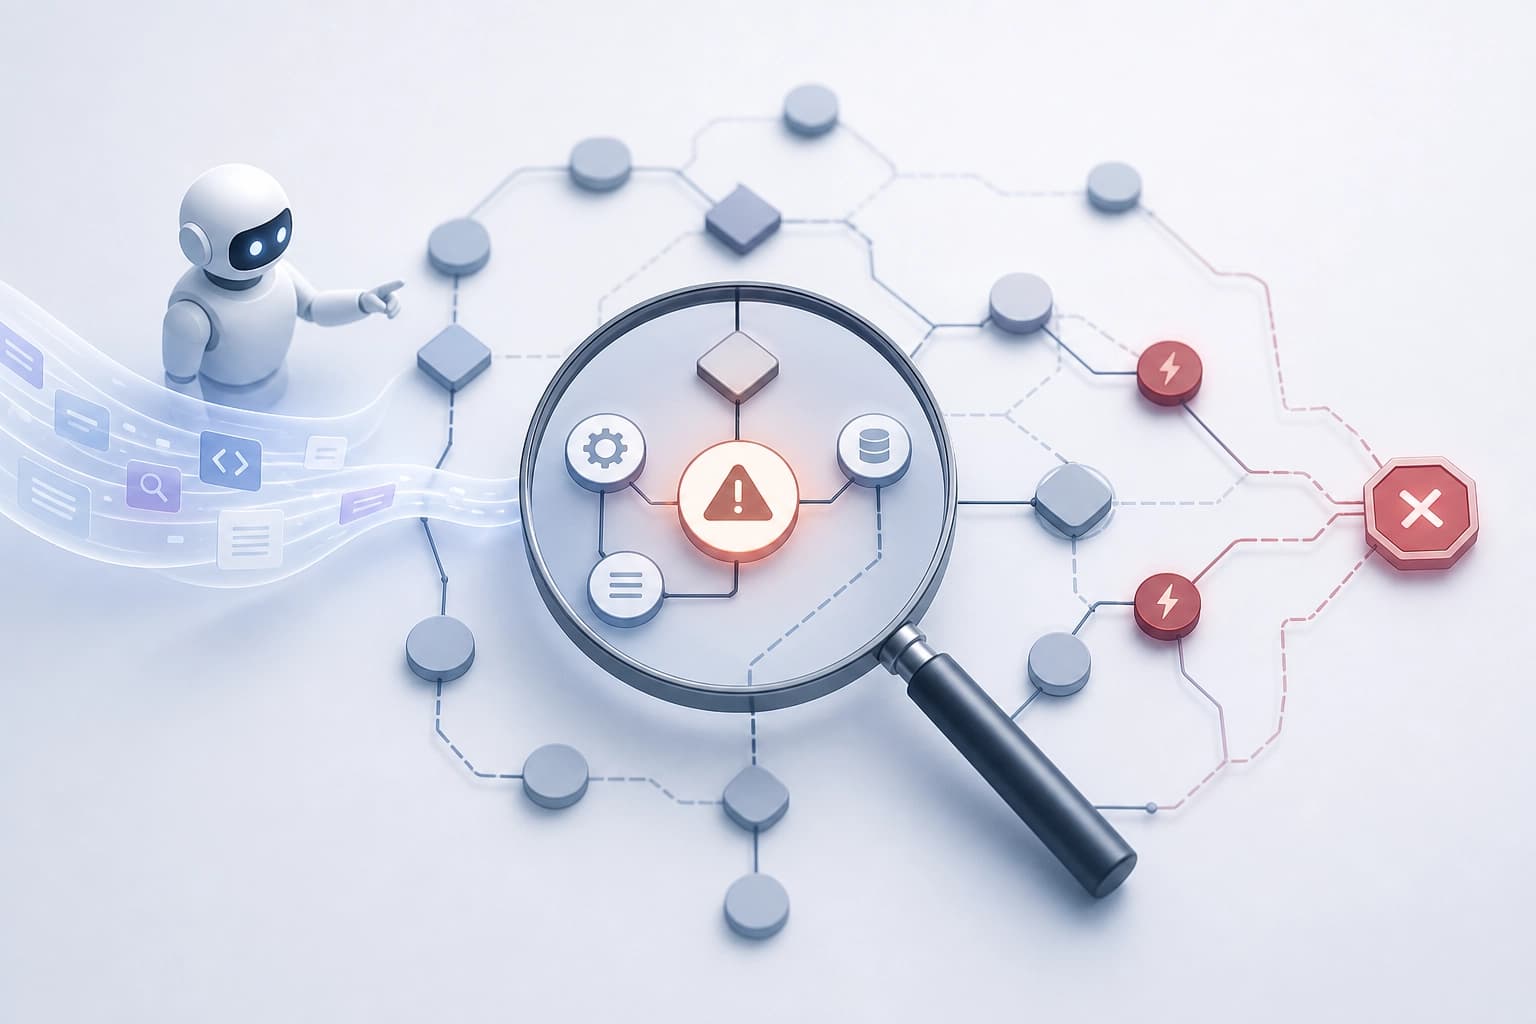
Où le diagnostic des traces d’agents échoue
Les applications complexes utilisent des agents basés sur des LLM. Les traces de ces agents sont longues, ce qui complique le diagnostic des défaillances.
Les méthodes de diagnostic existantes confondent anomalies, erreurs et défaillances. Les objectifs du diagnostic deviennent alors ambigus.
Ces méthodes ne modélisent pas de manière structurée la propagation et l’amplification des erreurs ayant une importance causale. Les défaillances finales des tâches ne peuvent donc pas être attribuées de manière fiable.
Critère pratique : une méthode de diagnostic doit distinguer les types d’écarts et retracer les liens de causalité entre eux.
Qu’est-ce que CEG-Agent ?
CEG-Agent est un framework agentique utilisant des outils. Il effectue le diagnostic causal des traces d’agents.
Le framework introduit une taxonomie explicite des anomalies, des erreurs et des défaillances. Sur cette base, il construit des Causal Error Graphs (CEG).
| Approche | Distinction entre anomalies, erreurs et défaillances | Modèle de propagation des erreurs |
|---|---|---|
| Méthodes de diagnostic existantes | Confondent ces notions | Ne modélisent pas la propagation de manière structurée |
| CEG-Agent | Introduit une taxonomie explicite | Construit des CEG avec des relations causales |
Critère de sélection : un framework doit définir des objectifs de diagnostic sans ambiguïté et s’appuyer sur un modèle typé des causes.
Causal Error Graphs : une représentation typée des causes
Les CEG constituent une représentation typée unifiée. Ils relient les éléments d’une trace par des relations causales.
Le graphe comprend trois types d’éléments :
- des événements d’exécution ;
- des nœuds de diagnostic ;
- des résultats sous forme de défaillances.
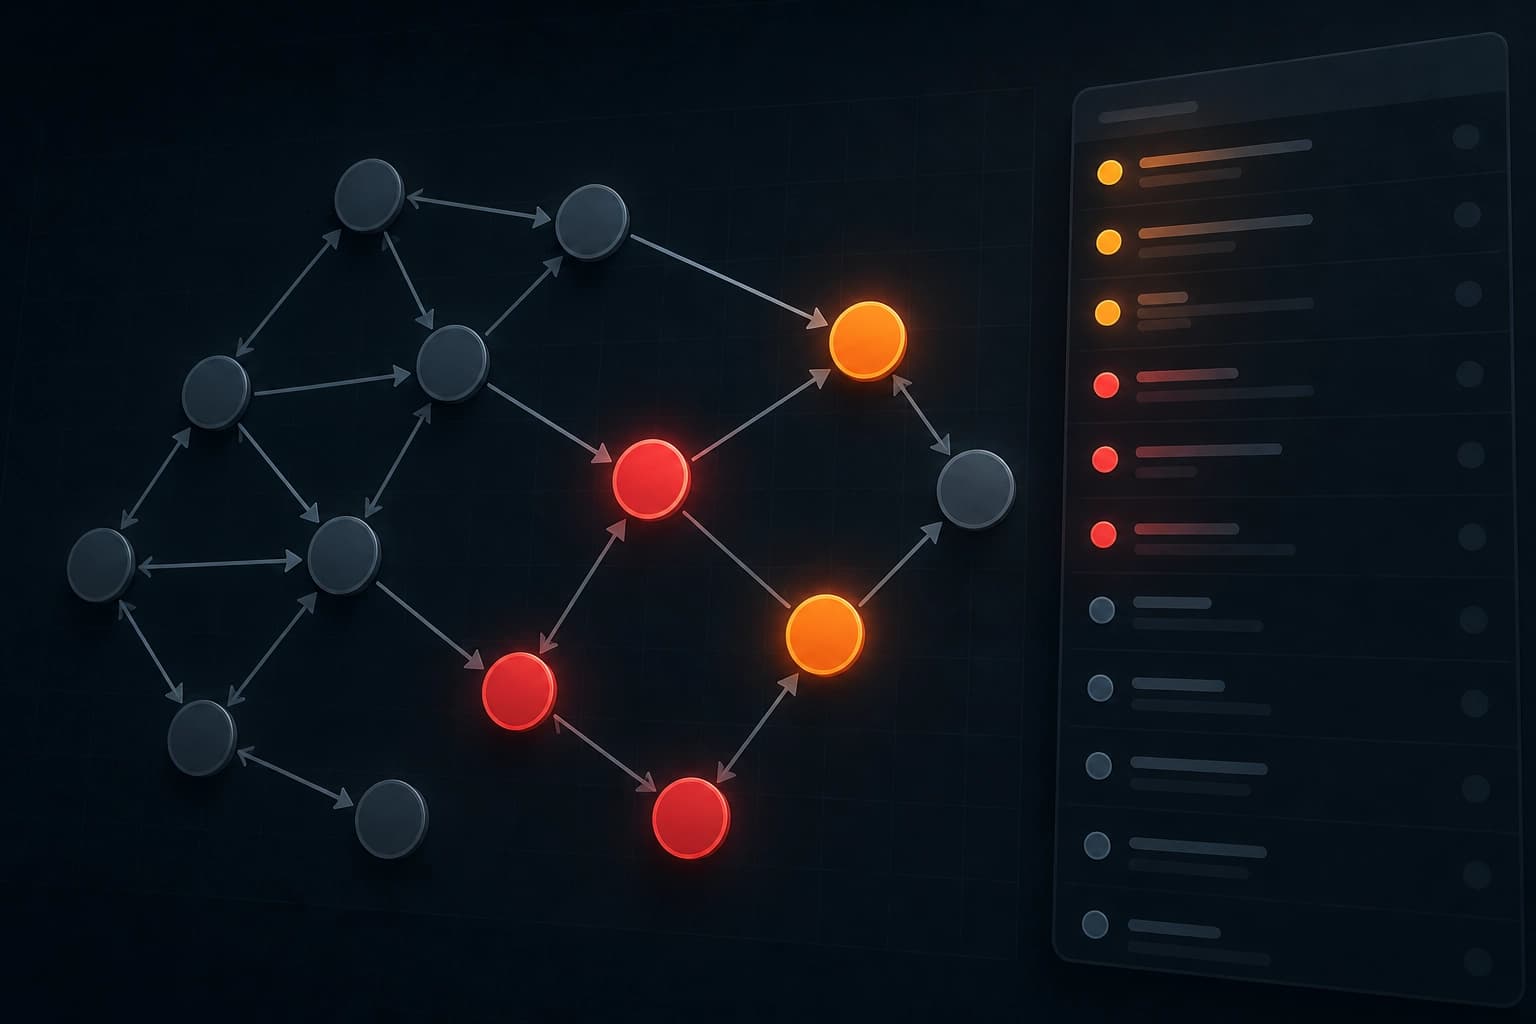
Tous les éléments sont reliés par des relations causales dans un format unifié. C’est ce qui distingue le graphe d’un ensemble de signaux disparates.
Critère : la représentation doit relier le déroulement de l’exécution à la défaillance finale par des liens de causalité explicites.
CEG-Bench et l’annotation avec AAAP
CEG-Bench a été créé pour évaluer le diagnostic causal des traces. Il s’agit d’un benchmark entièrement annoté par des agents.
Les annotations CEG du benchmark ont été obtenues à l’aide de l’Adversarial Agentic Adjudication Protocol (AAAP). Elles sont très fiables et cohérentes.
Les annotations ont été vérifiées par rapport à un jeu de référence élaboré par des experts humains. Les annotations automatiques se sont révélées très proches de celles des experts.
Critère : un benchmark dont les annotations sont vérifiées par rapport à un jeu de référence humain convient à la comparaison des méthodes de diagnostic causal.
Résultats et critères de sélection
Lors des expériences sur CEG-Bench, CEG-Agent obtient des résultats de pointe. L’évaluation s’est appuyée sur deux critères.
Le premier critère est une évaluation sémantique avec tolérance. Le second est une évaluation structurelle stricte. Le framework obtient des résultats de pointe selon les deux critères.
Critère de sélection : si la tâche exige une analyse correcte à la fois sur le plan sémantique et structurel, une méthode affichant ce niveau de résultats constitue une référence.
Foire aux questions
Matériaux connexes
Tous matériaux
Les LLM médicales sont informés des révisions des recommandations, mais répondent souvent selon les anciennes règles
L’étude de ChronoEvo portant sur 1 709 changements dans les recommandations cliniques montre que, dans le modèle principal, 90,8 % des réponses repéraient la nouveauté, mais que seules 58,5 % l’appliquaient intégralement, avec un écart de 32,3 points de pourcentage observé dans 14 modèles. Même en renforçant la visibilité des mises à jour, le transfert intégral des nouvelles règles dans les recommandations cliniques n’a pas connu de hausse significative.
4 novembre 2026
Modèle du monde pour les agents basés sur des LLM fermés : correction aux points de risque
PAWM est proposé comme un prédicteur externe qui ne reproduit pas l’observation étape par étape, mais s’active en cas d’échec probable et détourne l’agent d’une action erronée. Après un SFT sur des scénarios synthétiques et un co-entraînement GRPO, la méthode a enregistré des gains de 24,3 % sur ScienceWorld et de 7,7 % sur WebArena-Lite pour Claude Sonnet 4.5.
4 novembre 2026
Une couche de classification au-dessus de SpeechLLM : là où elle surpasse la génération d’étiquettes pour la reconnaissance des émotions
À partir des corpus IEMOCAP et MELD, l’étude compare la génération d’étiquettes émotionnelles à un classificateur linéaire appliqué aux représentations latentes d’une SpeechLLM compacte. Le gain de performance apporté par le classificateur n’est pas universel : il dépend du corpus et de l’utilisation de transcriptions de référence ou de résultats ASR.
4 novembre 2026