
CARAT : vérifier si les LLM en science des matériaux produisent des structures ou reformulent l’invite
Ce travail propose un protocole qui fixe la question et la référence selon huit modes de présentation de la structure et annote séparément les relations dans GraphSpace. Les expériences de réglage fin par paires, de masquage des champs cibles et d’ajout de preuves montrent que le modèle peut apprendre à la fois à appliquer une relation et à suivre un lien, mais que la suppression du lien fait chuter la précision en dessous de celle des parcours heuristiques.
Pourquoi la précision ne prouve pas le raisonnement
Un modèle de langage destiné aux sciences des matériaux peut donner la bonne réponse pour deux raisons différentes. Soit il la déduit des données structurelles, soit il reproduit une valeur déjà présente dans l’entrée. Une métrique de précision classique ne permet pas de distinguer ces deux cas. La description structurelle peut contenir le champ utilisé pour évaluer la réponse, auquel cas le score reflète la lecture d’un indice.
Le benchmark CARAT est conçu autour de cette distinction. Il vérifie si les LLM spécialisés en science des matériaux raisonnent à partir de données structurelles ou s’ils se contentent de répéter l’indice. Les auteurs de l’article sont Jiajun Wu, Jian Yang, Zixiang Ni, Zhenzhu Li et Bin Chong ; leurs travaux ont été soumis le 29 septembre 2026.
Critère pratique : une grande précision sur des données structurelles ne prouve rien à elle seule. Il faut examiner les conditions dans lesquelles la réponse a été obtenue.
Comment fonctionne la comparaison contrôlée
La question et la réponse de référence restent inchangées pour huit représentations comparées. Les relations structurelles sont indiquées séparément, dans GraphSpace.
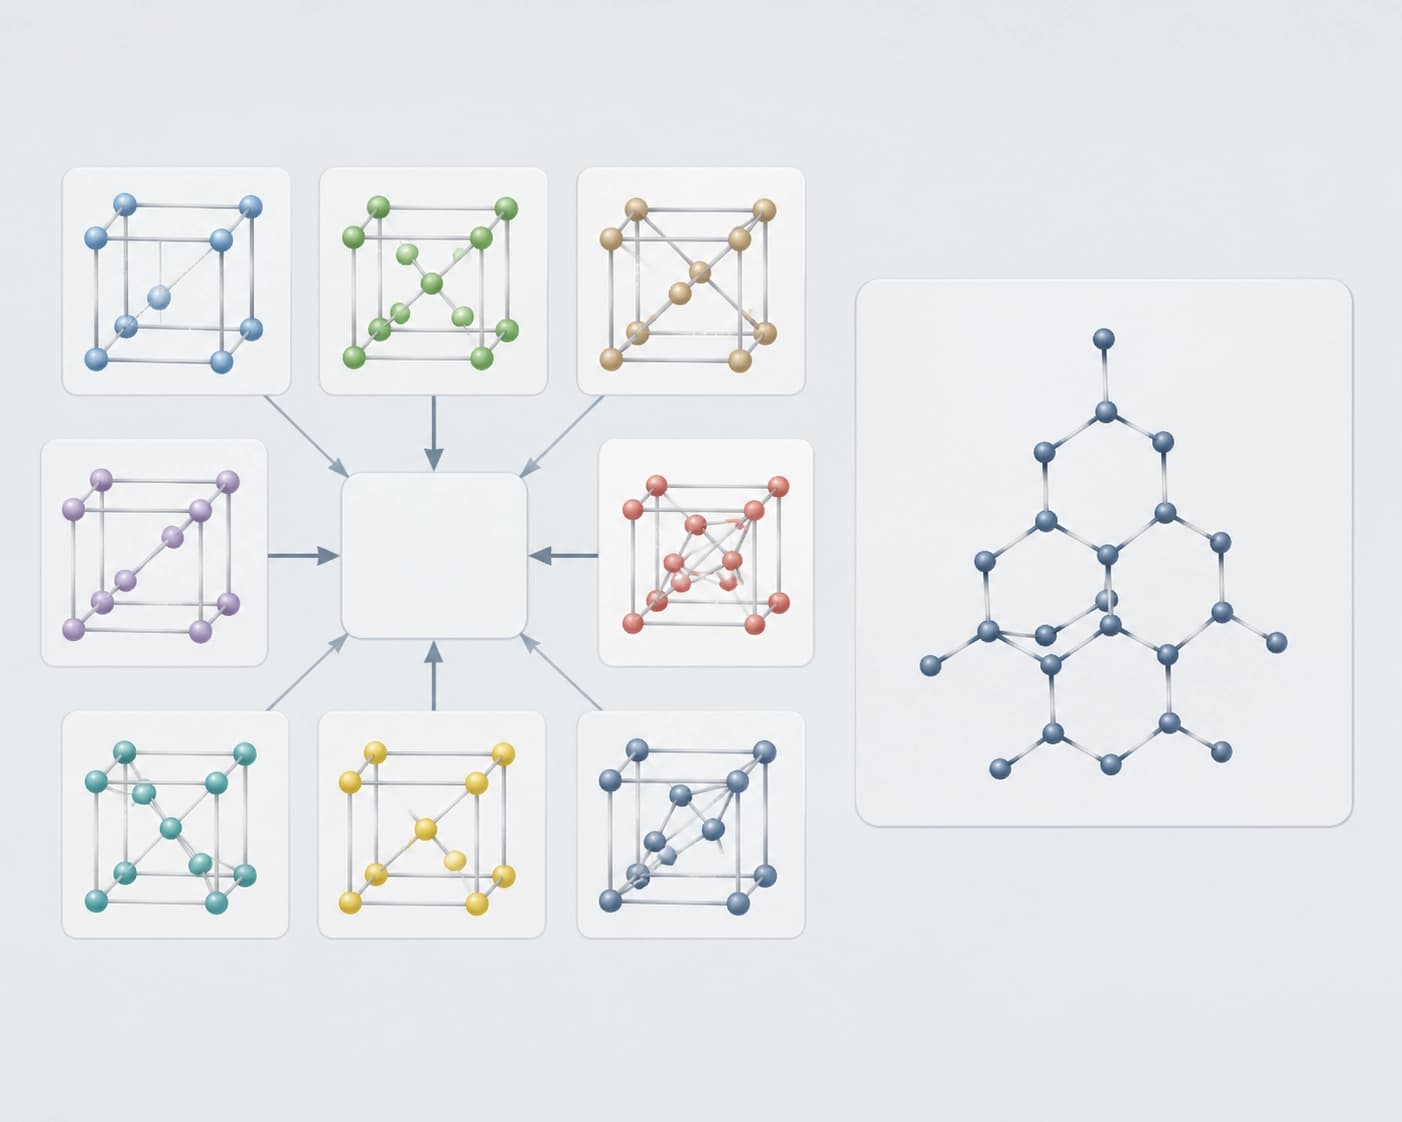
À cela s’ajoutent un fine-tuning contrôlé, le masquage des réponses, l’ajout de preuves, l’inférence par paires et une règle autorisant le modèle à s’abstenir de répondre.
| Ce qui est comparé | Différence |
|---|---|
| Représentation fondée sur la structure contre entrée limitée à la formule, sur les familles de tâches les plus difficiles | 17.3 points |
La question fixe écarte l’explication par la formulation de la tâche. Le masquage des réponses empêche le modèle de fournir une valeur toute faite.
Conclusion : comparer des représentations n’a de sens que si la question et la réponse de référence restent inchangées. Sinon, la différence reflétera la qualité du texte de la tâche, et non le traitement de la structure.
Quel est l’écart entre GraphSpace et un graphe simple
GraphSpace dépasse un graphe périodique simple de 19.3 points. Cet écart résulte de deux effets distincts.
| Condition | Différence |
|---|---|
| La représentation simple contient toutes les informations nécessaires pour répondre | 1.96 points |
| Ces champs sont entièrement absents de la représentation simple | 46.7 points |
Lorsque la représentation de base suffit pour répondre, l’avantage est presque nul. Quand les champs nécessaires en sont absents, l’écart devient important. Les auteurs soulignent que le résultat principal de la comparaison reflète le manque de données dans la représentation de base, et non la manière dont les preuves sont représentées.
Critère pratique : avant de conclure à la supériorité d’une représentation, vérifiez quels champs elle contient. Sinon, c’est l’exhaustivité des données qui est mesurée, et non la méthode.
Stratégies de contournement et révision du benchmark
L’évaluation a révélé un point faible du jeu de tâches. Une règle qui ignore le lien et lit directement la liste répond à quatre des sept familles de tâches renforcées. Le modèle peut donc éviter d’analyser la relation et simplement la contourner.
Le benchmark a été révisé. Onze stratégies de contournement de ce type donnent désormais des résultats proches du hasard.
Conclusion : un jeu de tâches ne convient à l’évaluation du raisonnement qu’après avoir été testé contre les stratégies de contournement. Si une règle simple résout certaines familles, ce n’est pas le raisonnement qui est mesuré.
Citer un lien et s’appuyer sur une relation
Le modèle gelé cite un lien, mais donne la même réponse dans 95.6 % des cas appariés lorsque ce lien est redirigé. Le modèle répète la relation sans l’utiliser.
| Condition | Part des cas appariés avec la même réponse |
|---|---|
| Modèle gelé, lien redirigé | 95.6% |
| Après un entraînement contrôlé, lien redirigé | 99.8% |
| Lien supprimé | 23.4% |
| Meilleure stratégie de contournement | 27.0% |
Après l’entraînement contrôlé, le résultat atteint 99.8%. La suppression du lien le ramène à 23.4%, un taux inférieur aux 27.0% obtenus par la meilleure stratégie de contournement. Les auteurs concluent que les deux étapes d’apprentissage — l’utilisation de la relation et le recours au lien — peuvent être acquises.
Critère : citer un lien ne signifie pas l’utiliser. Il faut examiner le comportement du modèle lorsque le lien est redirigé ou supprimé.
Ce que cela implique pour l’évaluation des outils
- Vérifiez si l’entrée contient déjà la réponse à la question posée.
- Examinez les résultats lorsque le lien est redirigé ou supprimé, et pas seulement sa citation.
- Exigez une description des contrôles : question et réponse de référence inchangées, ainsi que plusieurs représentations.
- Vérifiez si le jeu de tâches a été mis à jour après les tests de contournement.
- Évaluez l’écart annoncé au regard de la composition des données, et pas comme un chiffre isolé.
Critère de choix : un résultat est digne de confiance si sa valeur ne peut s’expliquer ni par la présence du champ nécessaire dans l’indice, ni par l’action d’une simple règle de contournement.
Foire aux questions
Matériaux connexes
Tous matériaux
Évaluation des agents de programmation pour le développement XR interactif : résultats de GenXR-Bench
GenXR-Bench est publié : un ensemble de 112 tâches expertes pour évaluer de bout en bout les agents de programmation dans le développement XR interactif, de l’amélioration de fonctionnalités et de la correction de défauts à la création d’applications dont le comportement est testé sur du matériel grand public. Parmi les dix modèles testés, le meilleur résultat a été de 50,9 % en Pass@1 ; les défaillances récurrentes concernent notamment la gestion des événements asynchrones des capteurs, l’ancrage des objets dans l’espace réel et la compréhension des interactions dans un contexte physique.
5 novembre 2026
De la récompense scalaire au front de Pareto : synthèse RTL par LLM avec apprentissage par renforcement multicritère
Une méthode est proposée pour entraîner un modèle de langage à générer non pas un seul schéma, mais un ensemble de candidats RTL offrant différents compromis entre surface, latence et consommation d’énergie ; la récompense est calculée en fonction de la contribution de chaque variante à l’hypervolume du front de Pareto. Sur RTLLM v2, l’hypervolume relatif a augmenté de 13,3 points de pourcentage par rapport à la version de base sans optimisation PPA et de 14,4 points de pourcentage par rapport à l’apprentissage par renforcement mono-objectif.
5 novembre 2026
Les LLM médicales sont informés des révisions des recommandations, mais répondent souvent selon les anciennes règles
L’étude de ChronoEvo portant sur 1 709 changements dans les recommandations cliniques montre que, dans le modèle principal, 90,8 % des réponses repéraient la nouveauté, mais que seules 58,5 % l’appliquaient intégralement, avec un écart de 32,3 points de pourcentage observé dans 14 modèles. Même en renforçant la visibilité des mises à jour, le transfert intégral des nouvelles règles dans les recommandations cliniques n’a pas connu de hausse significative.
4 novembre 2026