
Le choix d'un encodeur ne se fait pas sur la bonne métrique
On intègre généralement un encodeur gelé à un projet en regardant une seule chose : la facilité avec laquelle une tête légère apprend sur ses représentations — une couche linéaire, un petit MLP, quelque chose dans ce genre. Si une tête simple parvient à extraire le signal voulu, l'encodeur est jugé réussi. Mais cette évaluation répond à la question « est-il commode de lire quelque chose dans ces embeddings », et non à la question « la géométrie de l'espace sépare-t-elle elle-même le signal ». Ce sont deux questions différentes, et les confondre coûte cher : la tête masque la faiblesse de la représentation tant que les tâches sont simples et que les classes sont peu nombreuses.
Le problème de l'équilibre se pose séparément. Tant que les classes sont à peu près équilibrées, la différence entre « l'encodeur en est capable » et « la tête parvient à l'extraire » est presque invisible. Dès qu'une classe devient rare, les métriques fondées sur les plus proches voisins se mettent à mentir systématiquement.
Pourquoi la discordance par plus proches voisins ment
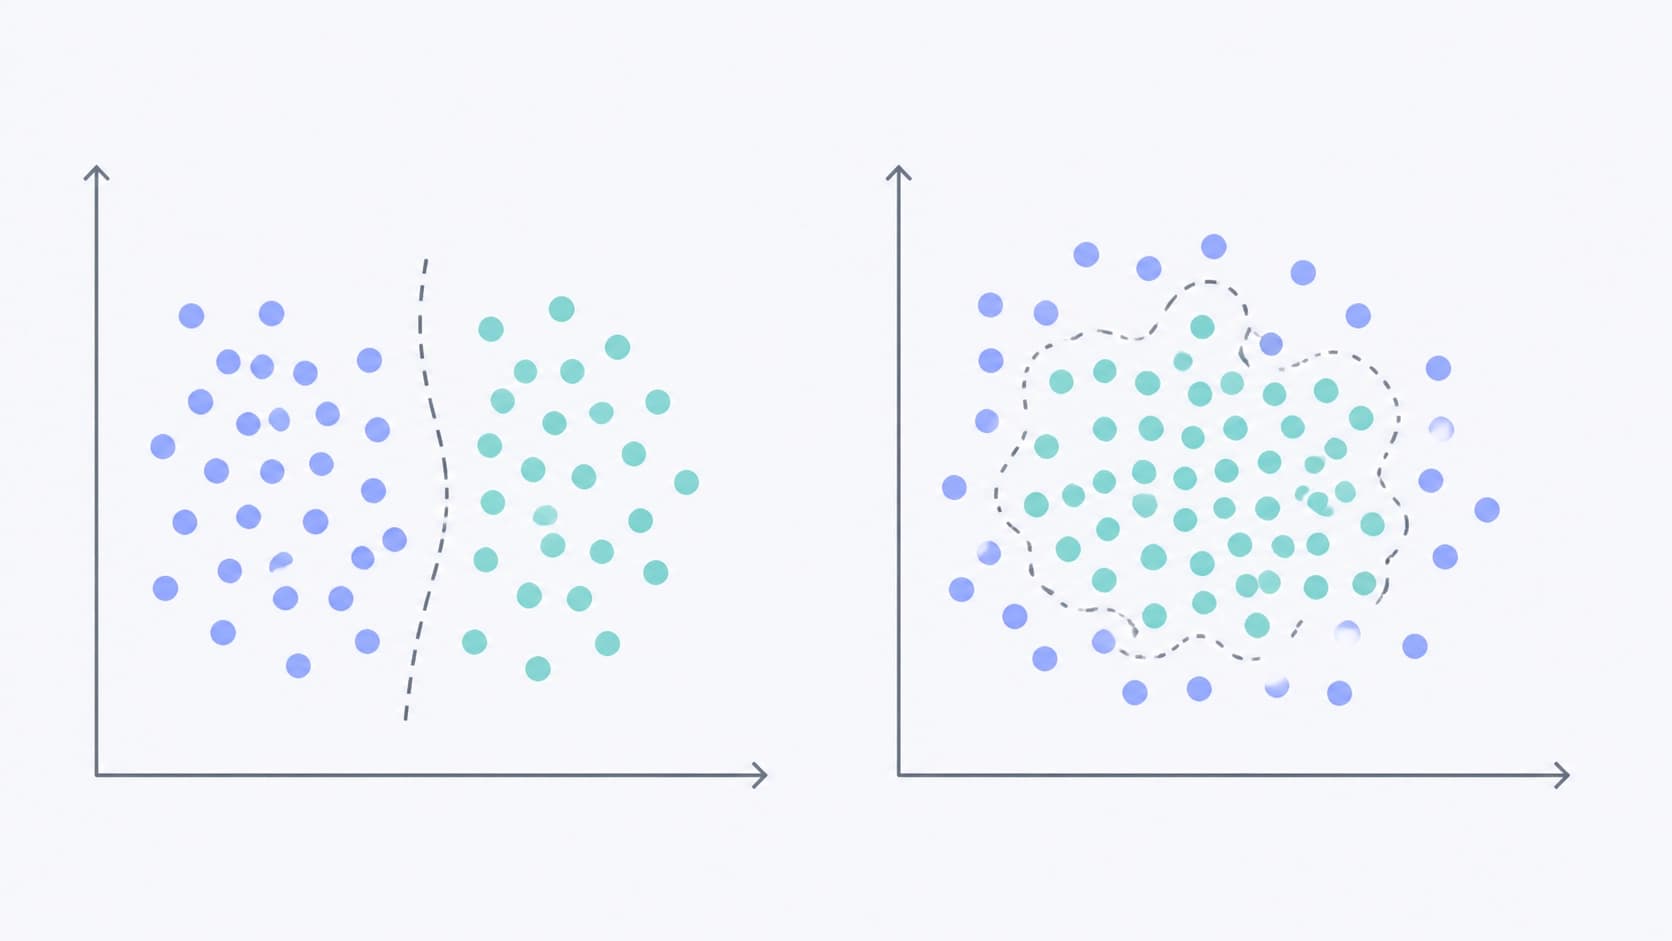
La métrique classique de discordance est simple : pour chaque point, on cherche des voisins dans l'espace des embeddings, et si le plus proche voisin porte la métadonnée opposée, le cas est enregistré comme discordant. À l'intérieur d'une même classe, la géométrie fonctionne parfaitement, aucun reproche à faire aux voisins.
Le problème tient à l'asymétrie de la procédure. Quand on constitue les voisins des exemples positifs et négatifs à partir d'ensembles de tailles différentes, le plus proche voisin portant la métadonnée opposée l'emporte non pas parce que la géométrie est ainsi faite, mais parce que sa classe est simplement plus dense dans le voisinage. Autrement dit, la prévalence de classe (prevalence) s'infiltre dans le résultat — une statistique du jeu de données, et non une propriété de la représentation. L'effet est désagréable : un encodeur totalement non informé se met à paraître aveugle, alors qu'en réalité il est exactement aussi inutile qu'une pièce de monnaie honnête, et pas pire.
Ce que CANDOR change précisément
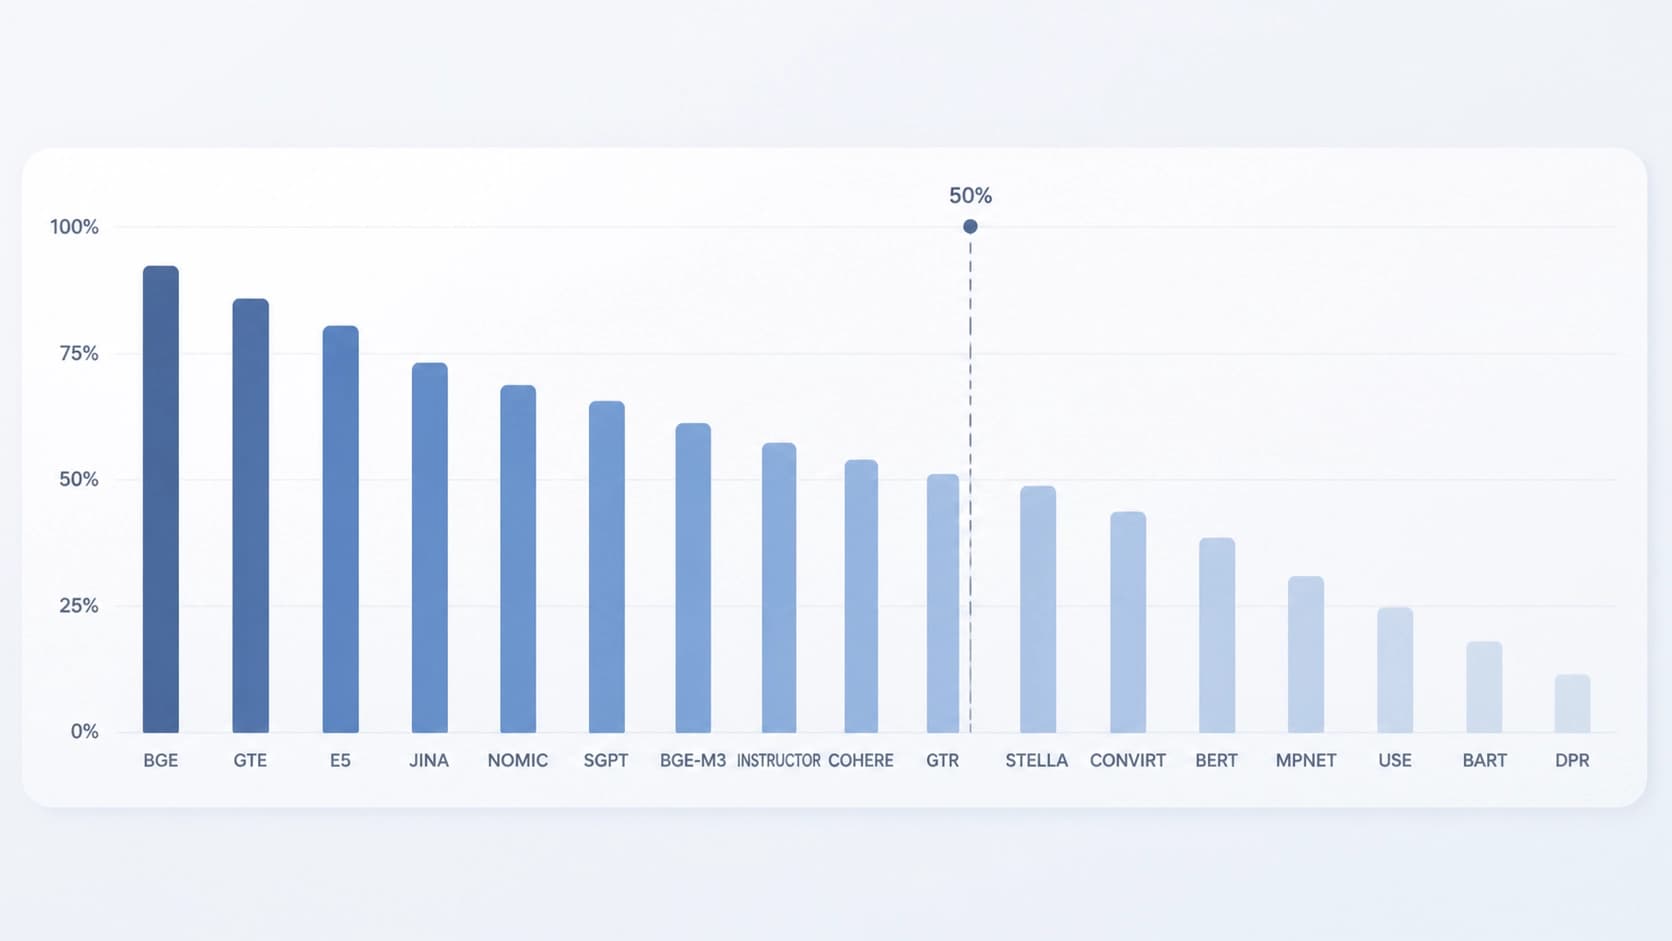
CANDOR — Chance-Calibrated Discordance in Frozen Foundation Encoders — redéfinit la procédure de calcul elle-même. Les banques de voisins y sont constituées de taille égale, et la construction de la métrique est symétrique par rapport à la permutation des métadonnées : échangez les positifs et les négatifs, et la valeur ne change pas. Par conséquent, le niveau du hasard est fixé exactement à une chance sur deux — 50 %. Non pas « environ la moitié, cela dépend du jeu de données », mais un point de référence strict à 1/2.
Ce n'est pas une correction cosmétique. C'est précisément ce point de référence flottant qui empêchait de comparer les encodeurs entre eux et entre jeux de données : là où le déséquilibre était plus fort, le hasard paraissait pire qu'il ne l'est, et le modèle recevait un crédit de confiance immérité. Quand le point de référence est fixé, la comparaison devient honnête.
Et un autre détail, important en pratique : puisque le point de référence est fixé, CANDOR peut être calculé avant l'entraînement de n'importe quelle tête. Aucun fine-tuning, aucune recherche d'hyperparamètres — la métrique décrit les représentations elles-mêmes et indique à l'avance quelles observations un encodeur gelé donné prend mal en charge.
Vérification à grande échelle
Les auteurs ont mené l'évaluation à grande échelle : 22 encodeurs, 20 jeux de données issus de 7 domaines, soit au total 605 443 images. Cette ampleur était justement nécessaire pour séparer l'effet de la métrique des particularités d'une seule tâche.
Le résultat renverse la conclusion à laquelle conduisait l'ancienne procédure. Après correction, le collapse des représentations se situe sous le niveau du hasard presque partout. Cela se lit ainsi : aucun des encodeurs testés n'est aveugle — l'information sur le signal est bien présente dans les représentations — mais tous sont faibles. La formulation « tous faibles, aucun aveugle » sonne plus douce que la précédente, et décrit en même temps la réalité bien plus précisément.
Exemple clinique : une tête forte sur une géométrie faible
L'illustration la plus parlante est l'imagerie médicale. Le meilleur modèle pour le thorax lit le pneumothorax avec un AUROC de 84,5. Le chiffre est solide, et c'est généralement lui que l'on regarde au moment de choisir un modèle. Mais ce même modèle place 18,4 % des cas positifs plus près d'une image portant la métadonnée opposée que de sa propre image présentant la même observation — au sein d'un même hôpital, donc sans décalage de domaine comme explication.
L'écart entre « la tête résout bien la tâche » et « la géométrie confond positifs et négatifs » est précisément cette divergence. La tête compense une représentation faible ; la métrique CANDOR montre que la compensation est importante.
Vient ensuite la comparaison entre domaines. Un même encodeur distingue les espèces d'oiseaux à un niveau de 4,5 (c'est-à-dire presque parfaitement), tandis qu'il laisse les observations thoraciques à 42,8, et le glaucome à 49,8. Ce dernier chiffre se situe au niveau du hasard, et en substance — pire que des poids aléatoires. Un seul encodeur, un seul entraînement, trois qualités de géométrie totalement différentes.
Un déficit de sélection, pas d'information
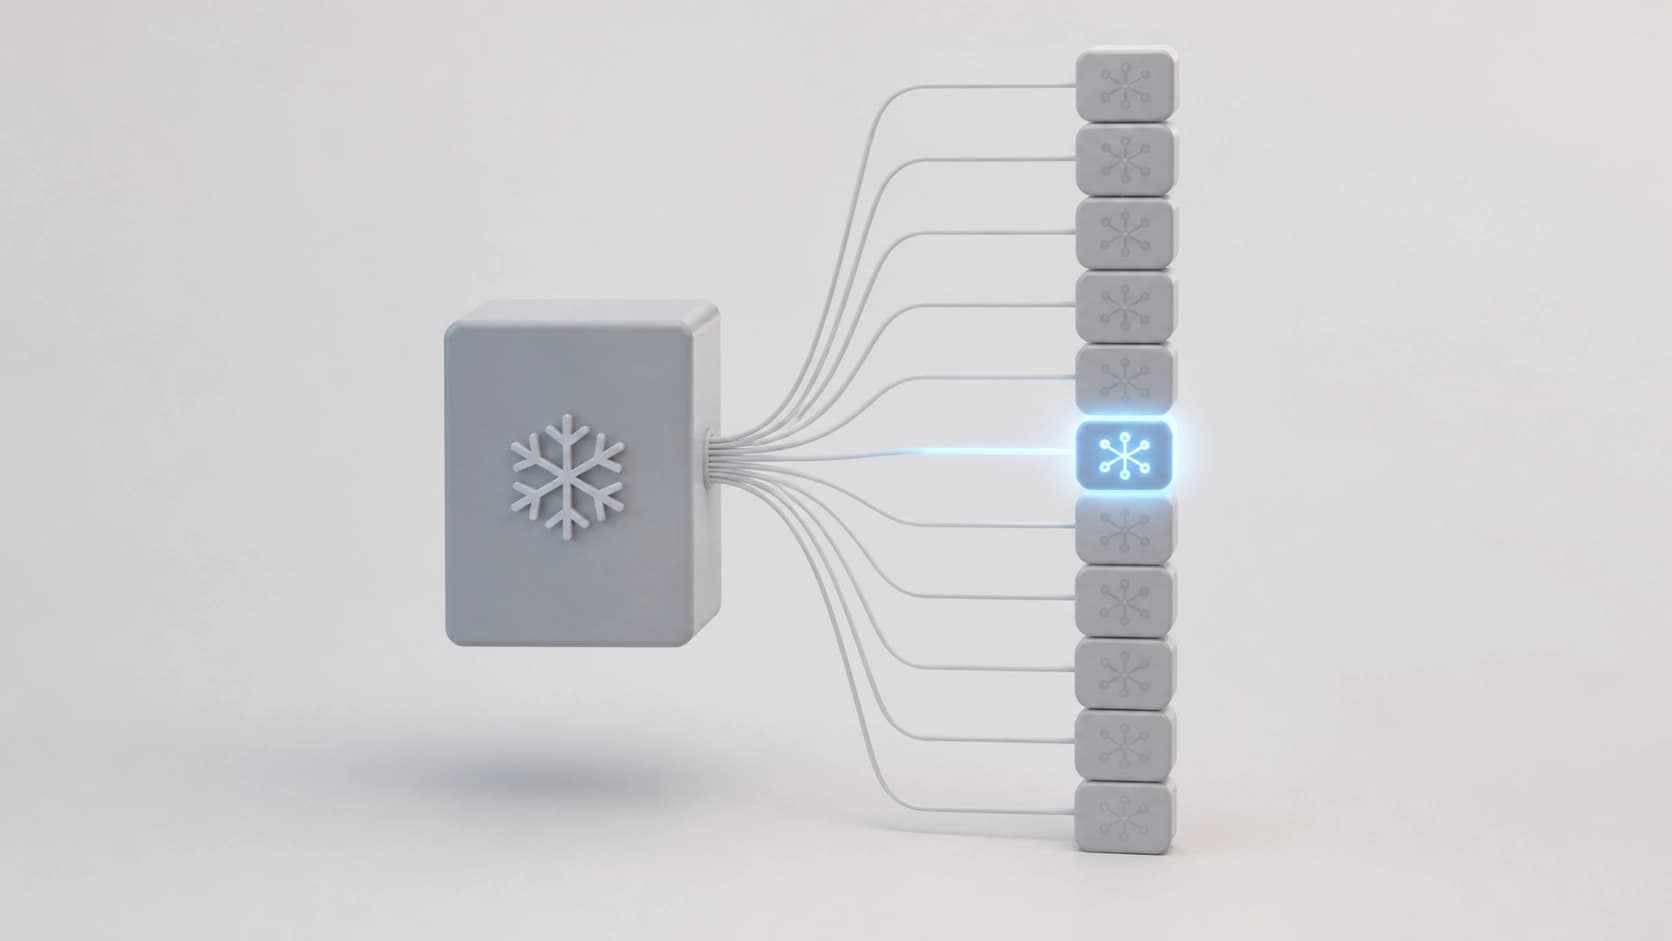
Une question naturelle en découle : les représentations sont-elles donc sans espoir ? Pas tout à fait. Le hasard borne la marge normalisée (normalized margin) de toute tête lipschitzienne — c'est-à-dire une tête dont la sensibilité au décalage de l'entrée est bornée. Cependant, au sein d'un ensemble de onze têtes, il s'en trouve une qui a raison dans tous les cas sauf 2,8 %, alors qu'une tête prise isolément se trompe dans 35,9 % des cas. L'information sur le signal est présente dans la représentation — elle n'est simplement pas également accessible à tous les dispositifs de lecture. Le déficit est donc lié à la sélection (selection), et non à une absence d'information.
Une association intéressante a également été mise au jour ailleurs : la rétention à l'effacement (erasure retention) est liée au collapse. En revanche, aucun lien n'a été trouvé avec l'objectif d'entraînement, la taille du modèle, l'ancienneté de la publication ou la taille de l'observation. Autrement dit, « prendre un modèle plus gros et plus récent » ne résout pas le problème — celui-ci ne tient ni à la taille ni à l'âge.
Ce qu'il en découle en pratique
Trois conclusions pratiques.
- Calculez CANDOR avant d'entraîner la tête. C'est une vérification peu coûteuse qui montre si l'encodeur prend en charge une observation rare donnée, et permet d'écarter un backbone inadapté avant d'avoir consacré du temps au tuning.
- Ne confondez pas l'AUROC de la tête avec la qualité de la représentation. 84,5 avec 18,4 % de positifs discordants — c'est une situation normale, pas rare, et elle mérite d'être mesurée séparément.
- N'attendez pas que l'échelle et la nouveauté corrigent tout. Aucune association n'a été trouvée avec la taille, l'objectif d'entraînement ou l'ancienneté ; la faiblesse des encodeurs gelés apparaît systémique.
La principale valeur de cette histoire n'est même pas dans la métrique elle-même, mais dans la conclusion renversée. Auparavant, on pensait que les encodeurs étaient « aveugles » à certaines classes. Après calibration par le hasard, on voit autre chose : ils voient presque partout, mais partout faiblement. C'est une image bien moins dramatique et bien plus exploitable — avec elle, on comprend quoi réparer et dans quel ordre.


