Récompense basée sur le résultat — et l'angle mort qu'elle contient
Dans la recherche sur les agents GUI, l'accent s'est nettement déplacé : de plus en plus de travaux sont consacrés à la modélisation de la récompense par le résultat (outcome reward modeling). La logique est simple — l'agent reçoit un score selon que sa trajectoire a conduit ou non à l'état sous-entendu par l'instruction de l'utilisateur. Il y a une action, un écran, un résultat, une évaluation.
Mais c'est là que se cache le piège. Si l'agent reçoit une récompense « pour le résultat », quelqu'un doit formuler ce qui est précisément considéré comme le résultat. Dans le schéma typique, cette étape est soit omise, remplacée par une formulation générale, soit laissée à l'appréciation du modèle lui-même : il « raisonne » au fil de la vérification, sans critères explicitement fixés. L'un comme l'autre semble fonctionner — jusqu'au moment où il faut évaluer des dizaines de tâches différentes avec un même vérificateur.
Trois erreurs typiques des rubriques généralisées
Les auteurs du travail arXiv:2608.24174 « Task-Adaptive Rubrics for GUI Reward Modeling » (Tao Xiong et coauteurs) décrivent ce à quoi mène l'appui sur un modèle universel ou sur le raisonnement implicite du modèle. Les problèmes sont prévisibles :
- Transfert des vérifications entre tâches. Un critère élaboré à un moment pour un scénario donné est appliqué mécaniquement à un autre, où il n'a tout simplement pas de sens.
- Perte des contraintes. Les exigences concrètes de l'instruction en cours — valeurs requises, champs précis, étapes déterminées — passent inaperçues, parce que la rubrique générale ne les distingue pas.
- Rigueur excessive. Le vérificateur se met à exiger ce que l'utilisateur n'a pas demandé et rejette une tâche correctement accomplie.
La cause commune à ces trois cas est la même : la rubrique vit séparément de la tâche. Elle n'est pas dérivée de l'instruction, mais plaquée sur elle de l'extérieur.
Comment fonctionne AdaptRubric
Le framework proposé s'appelle précisément ainsi — le cadre de rubriques « du grossier au fin » (Coarse-to-Fine Rubrics Framework). Sa tâche n'est pas de stocker un ensemble de critères prêt à l'emploi, mais de les construire pour chaque instruction spécifique, en allant d'un niveau large vers un niveau étroit. Deux étapes résolvent deux problèmes distincts, et c'est là un détail clé de la construction.
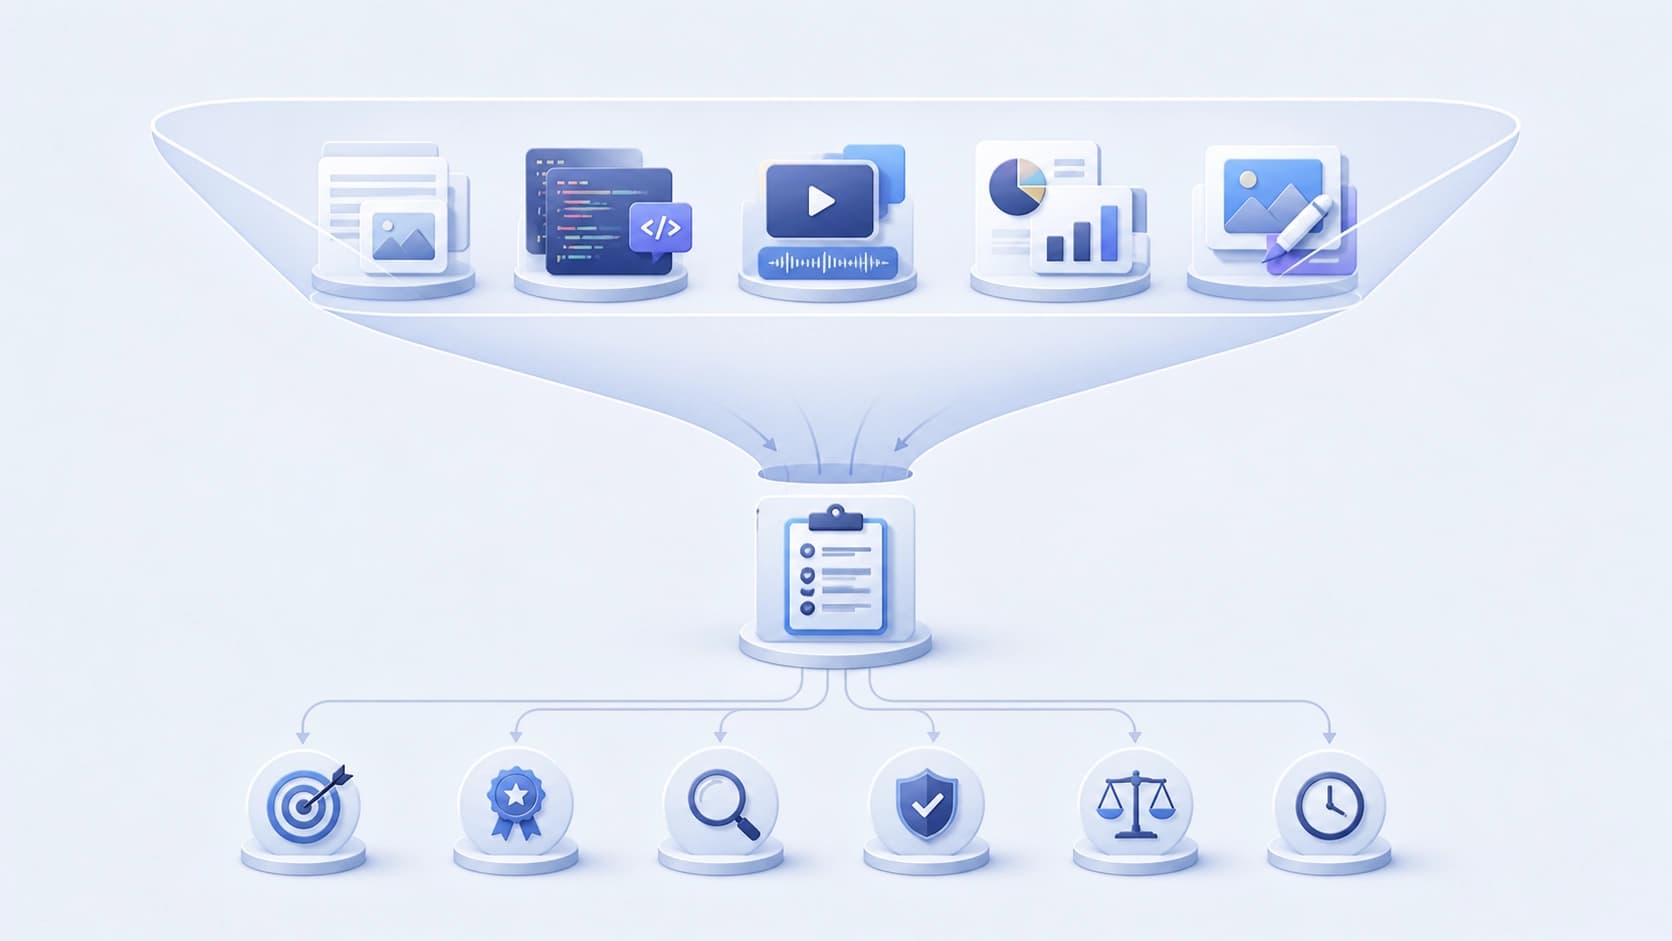
Étape grossière : d'abord comprendre de quelle classe de tâches il s'agit
La première étape est le routage. L'instruction est rattachée à une famille déterminée de tâches GUI, et des critères réutilisables sont tirés de cette famille. L'idée est que des actions similaires présentent des signes de succès stables : ils sont déjà connus et il n'est pas nécessaire de les réinventer pour chaque nouvelle requête. La rubrique grossière fixe un cadre — un cadre, et non un verdict définitif.
Étape fine : extraire les détails de l'instance concrète
La seconde étape travaille déjà sur une instruction individuelle. On en extrait des indices compacts — valeurs concrètes, champs d'application, contraintes qui sont essentielles dans cette tâche. C'est ici que la rubrique cesse d'être générale et devient propre à ce cas précis. Les exigences que l'utilisateur n'a pas posées n'apparaissent pas ; celles qu'il a posées ne se perdent pas.
Cette séparation lève le principal reproche adressé aux schémas universels : la généralisation subsiste, mais elle ne se substitue plus à la spécification.
Résultats : hors ligne et en apprentissage par renforcement
AdaptRubric a été testé dans deux modes. Le premier — l'évaluation hors ligne de la récompense, c'est-à-dire dans quelle mesure le vérificateur distingue les trajectoires réussies des trajectoires échouées. Le second — l'optimisation en ligne avec apprentissage par renforcement, où les rubriques servent déjà de source de signal pour l'entraînement de l'agent.
Les chiffres annoncés : à budget d'images comparable, l'indicateur F1 a progressé de 3,6 points par rapport à la moyenne des solutions de référence, et le gain de réussite d'exécution des tâches s'est élevé à 4,23 points. Les auteurs soulignent que l'avantage se reproduit de manière stable, et ne repose pas sur quelques exécutions particulièrement réussies.
Ce que cela change sur le fond
L'évaluation de l'agent cesse d'être une question de « bon ou mauvais vérificateur ». Elle devient une question de procédure : qui a formulé les critères pour cette tâche précise, et sur quelle base. Tant que les critères étaient dérivés implicitement, il était presque impossible de distinguer une erreur d'évaluation d'une erreur de l'agent lui-même — les deux apparaissaient identiques dans le rapport final.
L'approche par rubriques adaptatives rend la couche intermédiaire explicite, et donc vérifiable, discutable et modifiable indépendamment du modèle. Pour le développement, c'est aussi un avantage pratique : si la rubrique est construite à partir de l'instruction, alors modifier la formulation de la tâche modifie automatiquement sa méthode d'évaluation, sans réécrire le vérificateur.
Des questions ouvertes subsistent — dans quelle mesure le routage gère les tâches à la frontière entre familles, comment se comporte l'étape fine face à des instructions volontairement ambiguës. Mais la formulation elle-même semble déjà plus utile qu'une nouvelle tentative de rendre un modèle universel un peu plus précis.