
MSEB de Google Research: implementación de codificadores de audio conforme al contrato del benchmark y evaluación en cuatro clases de tareas
Análisis práctico del paquete mseb==0.1.0: arquitectura por capas de types, encoder y evaluators, dos codificadores de demostración sobre un corpus sintético y llamada directa a métricas de clasificación, agrupamiento, búsqueda y segmentación. El material muestra cómo adaptar un modelo propio al MultiModalEncoder abstracto, interpretar el formato SoundEmbedding y crear TaskMetadata para enviarlo posteriormente a un benchmark.
Propósito y capas del benchmark
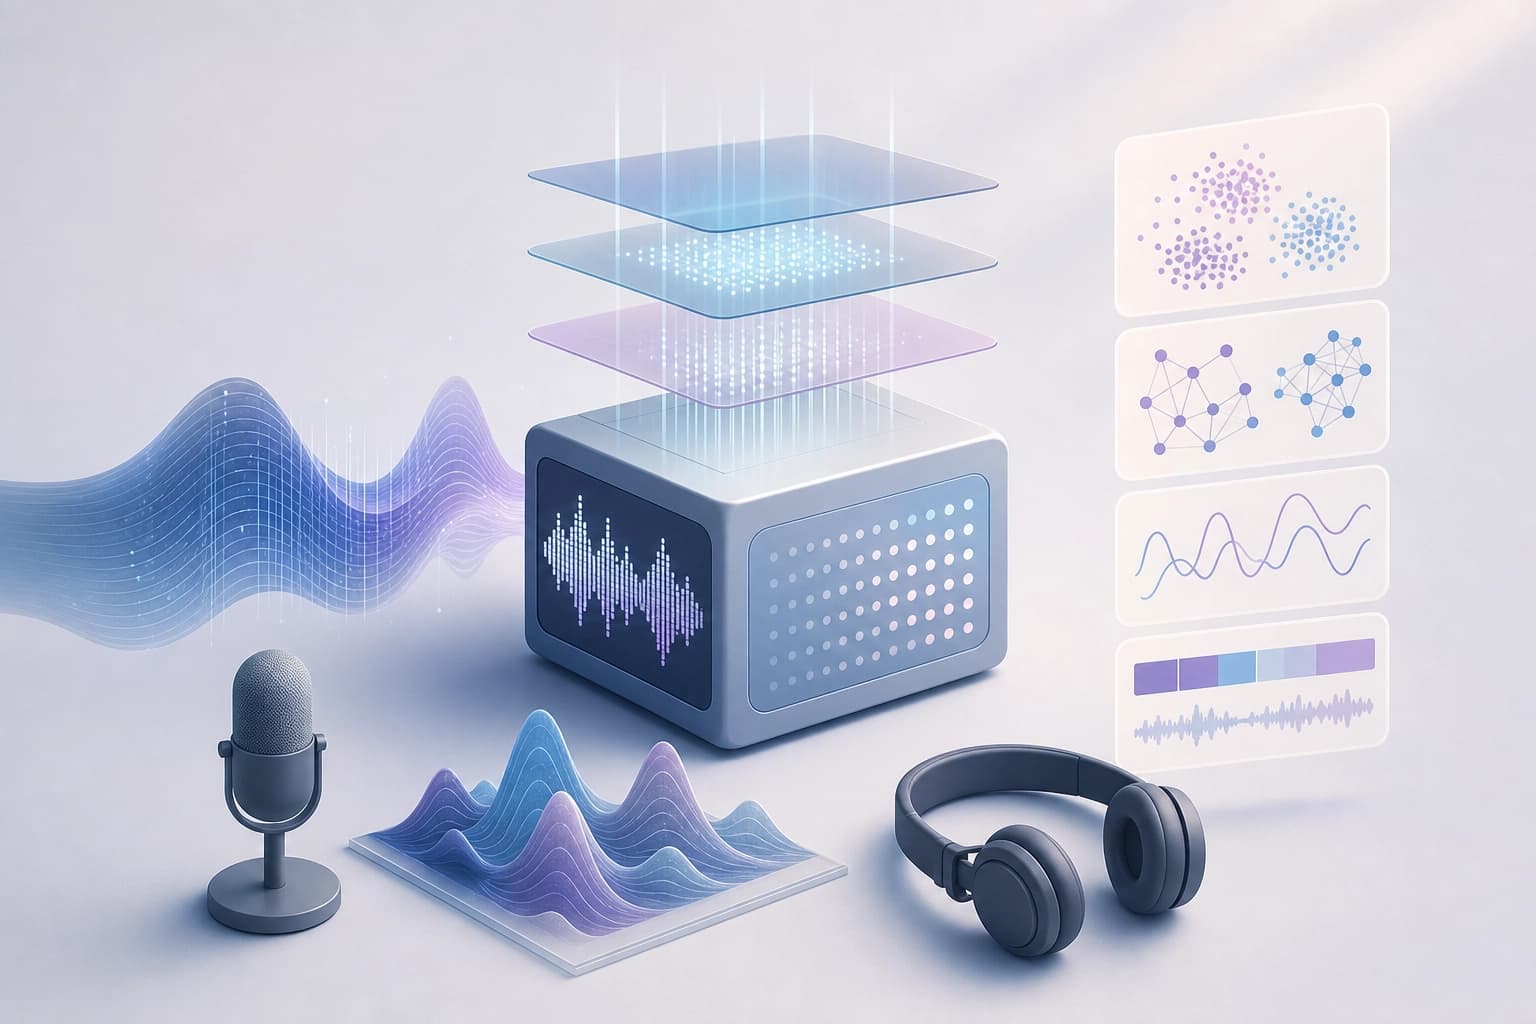
MSEB — Massive Sound Embedding Benchmark de Google Research. El paquete se instala como mseb==0.1.0. El benchmark se divide en tres capas.
typesdefine los tiposSound,SoundEmbedding,ScoreyTaskMetadata.encodercontiene la clase base abstractaMultiModalEncoder: el contrato que implementa el modelo.evaluatorscontiene evaluadores para distintas tareas.
Estas capas separan la descripción de los datos, la interfaz del modelo y la medición de la calidad. Criterio práctico: la capa encoder establece los requisitos del codificador, mientras que evaluators establece los requisitos de la evaluación.
Contrato del codificador y tipos de datos
encoder contiene la clase base abstracta MultiModalEncoder. Esta clase es el contrato que implementa el modelo. types define Sound, SoundEmbedding, Score y TaskMetadata.
SoundEmbedding almacena embeddings con forma (N, D) y marcas de tiempo con forma (M, 2). Las marcas indican el inicio y el final del intervalo en segundos. Si M == N, las marcas corresponden a fotogramas individuales. Si M == 1, el embedding corresponde a toda la emisión. El campo embedding puede contener N cadenas en lugar de vectores. Además, SoundEmbedding incluye el contexto y las estadísticas de codificación, como las dimensiones de entrada y del embedding.
Score describe la métrica, su valor, el rango permitido y una descripción. TaskMetadata se recopila al final de la evaluación y se utiliza en un envío real.
Criterio práctico: el codificador debe devolver un SoundEmbedding con las formas correctas y completar Score para cada tarea.
Dos ejemplos de codificadores: volumen y timbre
En el tutorial se implementan dos codificadores distintos. Uno mide el volumen a lo largo del tiempo y el otro, el timbre. Se aplican a un pequeño corpus sintético de audio. El corpus se crea en el cuaderno, por lo que no es necesario descargar datos.
Según la descripción del tutorial, los dos codificadores muestran resultados distintos según el evaluador. Esto significa que la elección de las características influye en la calidad en distintas tareas. Criterio práctico: hay que probar ambos enfoques para clasificación, agrupamiento, búsqueda y segmentación.
Evaluación en cuatro clases de tareas
Los embeddings se evalúan en tareas de clasificación, agrupamiento, búsqueda y segmentación. Para los ejemplos, se importan ClassificationEvaluator, ClusteringEvaluator, RetrievalEvaluator y SegmentationEvaluator. Las funciones de las métricas se llaman directamente. Al final, se recopila TaskMetadata, que se utiliza en un envío real.
El paquete también incluye evaluadores para reranking y transcripción.
Los evaluadores de clasificación, agrupamiento, búsqueda y segmentación dependen únicamente de NumPy y scikit-learn. Los evaluadores de reranking y transcripción utilizan Whisper.
| Tarea | Evaluador | Dependencias |
|---|---|---|
| Clasificación | ClassificationEvaluator | NumPy, scikit-learn |
| Agrupamiento | ClusteringEvaluator | NumPy, scikit-learn |
| Búsqueda | RetrievalEvaluator | NumPy, scikit-learn |
| Segmentación | SegmentationEvaluator | NumPy, scikit-learn |
| Reranking | evaluador de reranking | Whisper |
| Transcripción | evaluador de transcripción | Whisper |
Criterio práctico: para las cuatro clases de tareas, bastan NumPy, scikit-learn y una CPU. Para reranking y transcripción, se necesita Whisper.
Dependencias y requisitos de ejecución
Los pasos mostrados se ejecutan en una CPU sin descargar un conjunto de datos. Los evaluadores de clasificación, agrupamiento, búsqueda y segmentación dependen únicamente de NumPy y scikit-learn. Los evaluadores de reranking y transcripción utilizan Whisper. El ejecutor de tareas utiliza TensorFlow y apache-beam.
Estas dependencias determinan el entorno de ejecución. Para las cuatro clases de tareas no se necesitan GPU ni datos externos. Para reranking, transcripción y la ejecución del ejecutor de tareas se necesitan componentes adicionales.
Criterio práctico: si el objetivo es probar rápidamente un codificador en tareas de clasificación, agrupamiento, búsqueda y segmentación, bastan una CPU y las bibliotecas indicadas.
Criterios prácticos de selección
La implementación del codificador debe ajustarse a MultiModalEncoder. El SoundEmbedding que se devuelve debe contener embeddings con forma (N, D) y marcas de tiempo con forma (M, 2). El campo embedding puede contener N cadenas en lugar de vectores. Score debe describir la métrica, el valor, el rango permitido y la descripción. TaskMetadata se recopila al final y se utiliza en un envío real.
Para la evaluación en tareas de clasificación, agrupamiento, búsqueda y segmentación, se pueden utilizar ClassificationEvaluator, ClusteringEvaluator, RetrievalEvaluator y SegmentationEvaluator. Dependen de NumPy y scikit-learn. Para reranking y transcripción se necesita Whisper.
Criterio práctico: el codificador se elige según la tarea. Los dos ejemplos de codificadores —volumen y timbre— dan resultados distintos según el evaluador. Se prueban ambos codificadores en el conjunto de tareas necesario.
Preguntas frecuentes
Material similar
Todos los materiales
Evaluación de agentes de programación en el desarrollo interactivo de XR: resultados de GenXR-Bench
Se ha publicado GenXR-Bench, un conjunto de 112 tareas expertas para evaluar de forma integral agentes de programación en el desarrollo interactivo de XR: desde la mejora de funciones y la corrección de defectos hasta la creación de aplicaciones con verificación del comportamiento en dispositivos de consumo. Entre los diez modelos probados, el mejor resultado fue un 50,9 % en Pass@1; los fallos recurrentes incluyeron la gestión de eventos asíncronos de sensores, el anclaje de objetos al espacio real y la comprensión de las interacciones en un contexto físico.
5 noviembre 2026
Anotación híbrida de imágenes: la automatización acelera el entrenamiento de modelos de visión por computadora
El artículo describe cómo el preetiquetado mediante algoritmos reduce el trabajo manual y mejora la calidad de los conjuntos de datos de entrenamiento, así como por qué sigue siendo necesaria la verificación selectiva por parte de una persona. También se analizan las limitaciones del método en condiciones de captura difíciles y con tipos de objetos poco frecuentes.
5 noviembre 2026
De la recompensa escalar al frente de Pareto: síntesis RTL de LLM mediante aprendizaje por refuerzo multiobjetivo
Se propone un método para entrenar un modelo de lenguaje para que genere no un solo diseño, sino un conjunto de candidatos RTL con distintos compromisos entre área, latencia y consumo energético; la recompensa se basa en la contribución de cada variante al hipervolumen del frente de Pareto. En RTLLM v2, el hipervolumen relativo aumentó 13,3 puntos porcentuales frente a la versión base sin optimización PPA y 14,4 puntos porcentuales frente al entrenamiento por refuerzo con un único objetivo.
5 noviembre 2026