
De la recompensa escalar al frente de Pareto: síntesis RTL de LLM mediante aprendizaje por refuerzo multiobjetivo
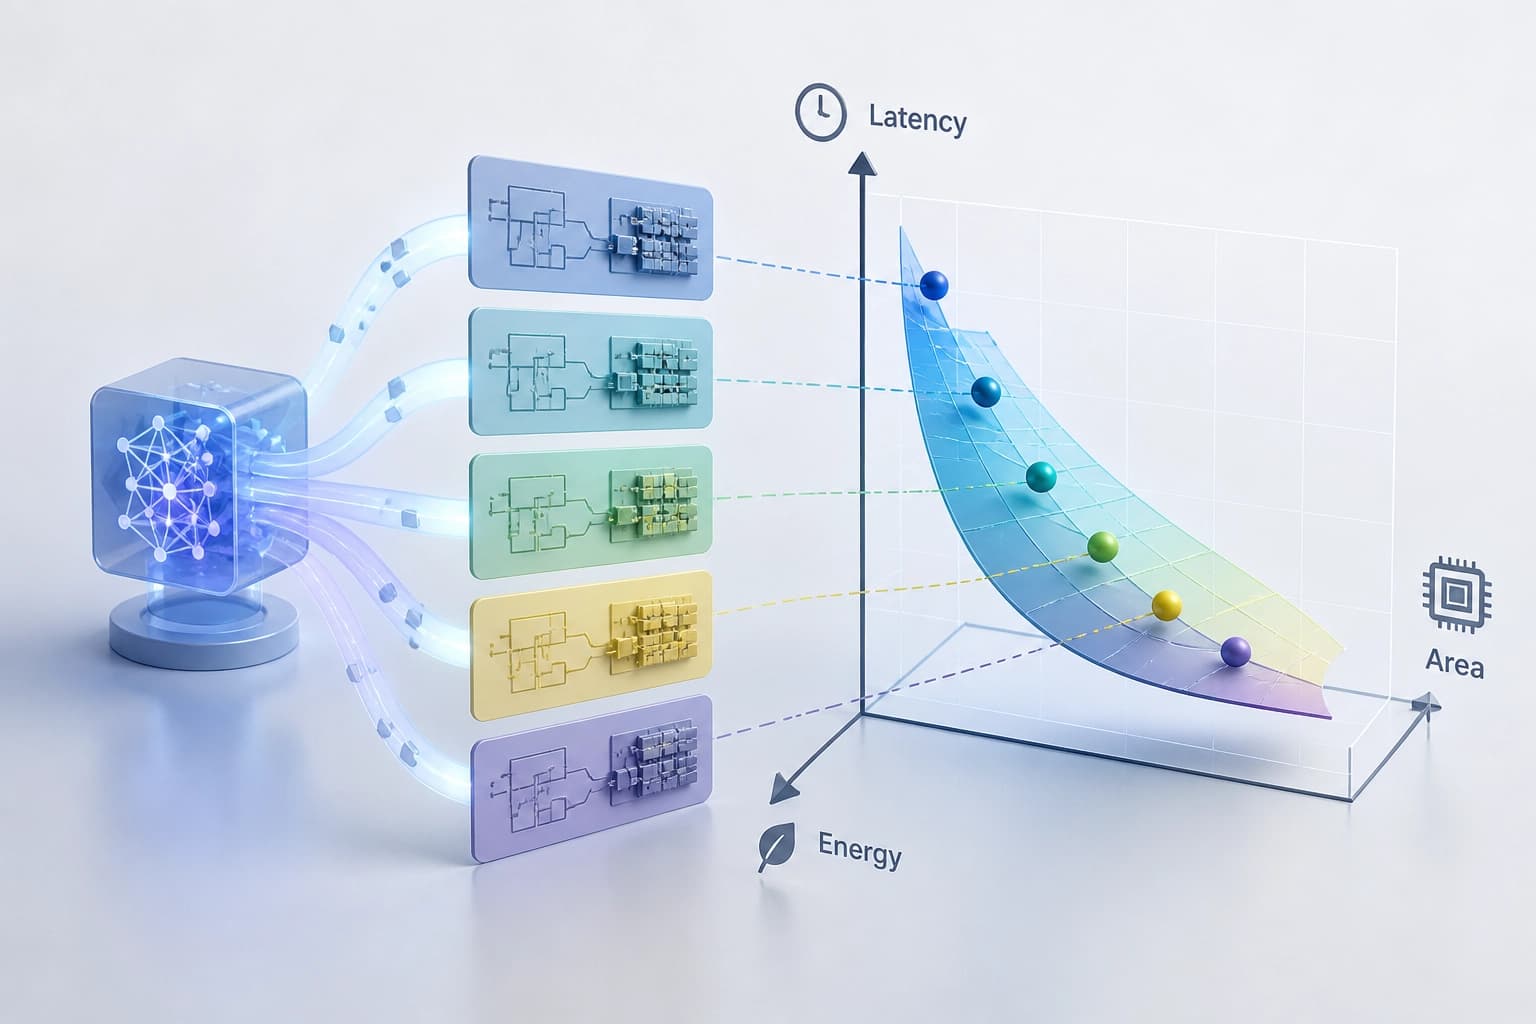
Se propone un método para entrenar un modelo de lenguaje para que genere no un solo diseño, sino un conjunto de candidatos RTL con distintos compromisos entre área, latencia y consumo energético; la recompensa se basa en la contribución de cada variante al hipervolumen del frente de Pareto. En RTLLM v2, el hipervolumen relativo aumentó 13,3 puntos porcentuales frente a la versión base sin optimización PPA y 14,4 puntos porcentuales frente al entrenamiento por refuerzo con un único objetivo.
Trabajo y estado
- Título: Pareto-Optimal RTL Code Generation via Multi-Objective Reinforcement Learning with Large Language Models.
- Autores: Koki Takeshita, Kenji Uebayashi, Hikaru Tomonari, Masaya Tsunokake, Koichiro Yawata, Tatsuya Sasaki, Yusuke Ohtsubo, Kota Dohi, Yasuhiro Sogawa.
- Fecha de envío: 16 de octubre de 2026.
- Estado: los comentarios indican que el trabajo ha sido aceptado en COLM 2026.
El preprint está disponible como arXiv:2610.26904. El trabajo aborda la generación de RTL con modelos de lenguaje grandes. El método entrena al modelo para que produzca un conjunto de candidatos, en lugar de un único diseño. Ese conjunto se evalúa en el espacio PPA.
Conclusión: el trabajo ha sido aceptado en COLM 2026 y propone un enfoque multiobjetivo para la síntesis de RTL con LLM. Al elegir un enfoque, es importante tener en cuenta el cambio de objetivo: pasar de un único diseño a un conjunto.
El problema de la recompensa escalar
Los enfoques existentes combinan varios objetivos en una sola recompensa escalar. Esto dificulta obtener al mismo tiempo soluciones diversas y óptimas de Pareto. Resulta difícil alcanzar distintos compromisos entre un consumo energético bajo, una latencia reducida y un área pequeña. La recompensa escalar fija la importancia de los objetivos antes de la generación.
La importancia relativa de los objetivos depende de los requisitos del producto y de las restricciones del proyecto. Una recompensa definida de antemano no cambia en función de esos requisitos. Por eso se necesita un conjunto de candidatos con distintos compromisos.
| Enfoque | Qué optimiza | Cuándo se elige el compromiso |
|---|---|---|
| Recompensa escalar | Un diseño según la suma de los objetivos | Antes de la generación |
| Enfoque multiobjetivo | Un conjunto de diseños en la frontera de Pareto | Después de la generación |
Conclusión: la recompensa escalar fija el compromiso antes de la generación. La formulación multiobjetivo traslada la elección a la etapa posterior a la generación.
Qué optimiza el método
El método optimiza la calidad y la diversidad del conjunto completo de diseños. El conjunto se obtiene mediante varias generaciones. La evaluación se realiza en el espacio de objetivos PPA: Power, Performance, Area. El método no está orientado a la calidad de un único diseño.
Los objetivos PPA implican compromisos entre sí. Distintos diseños ofrecen diferentes combinaciones de bajo consumo energético, latencia reducida y área pequeña. Por eso, el método entrena al modelo para cubrir distintos puntos de la frontera de Pareto. El diseñador obtiene varios candidatos.
Conclusión: el método busca cubrir la frontera, no encontrar una única respuesta óptima.
Dos componentes del método
Canalización de entrenamiento basada en generaciones
La canalización transforma la mejora de la cobertura de todo el conjunto de soluciones de Pareto en una tarea secuencial de generación de diseños. El entrenamiento se realiza paso a paso. La tarea de generación adquiere una estructura secuencial.
Recompensa basada en la contribución al Hypervolume
La función de recompensa HVC mide la contribución del diseño generado a la frontera de Pareto. La recompensa refleja el aumento de la cobertura, no la calidad absoluta de un diseño individual. HVC vincula el entrenamiento con la cobertura de la frontera.
Conclusión: la canalización establece una secuencia y HVC proporciona una señal de recompensa por contribuir a la cobertura.
Resultados en RTLLM v2
La evaluación en el benchmark RTLLM v2 mostró un aumento del Hypervolume relativo. En comparación con la variante de referencia sin optimización PPA, el aumento fue de +13,3 puntos porcentuales. En comparación con el método de RL de un solo objetivo, fue de +14,4 puntos porcentuales. Los autores también informan de una mayor diversidad de diseños.
| Comparación | Aumento del Hypervolume relativo |
|---|---|
| Variante de referencia sin optimización PPA | +13,3 puntos porcentuales |
| Método de RL de un solo objetivo | +14,4 puntos porcentuales |
Conclusión: en RTLLM v2, el método mejora la cobertura de la frontera y la diversidad. Las cifras se refieren al Hypervolume relativo, no a la calidad absoluta de cada diseño.
Criterio práctico de elección
La elección del enfoque depende de cuándo se fija el compromiso. La recompensa escalar exige definir la importancia de PPA antes de la generación. El enfoque multiobjetivo traslada la elección a la etapa posterior a la generación. Proporciona un conjunto de candidatos con distintos compromisos.
La evaluación del método se limita al benchmark RTLLM v2. Para otro flujo de diseño se necesita una validación propia. No se deben extrapolar las cifras de mejora a otras condiciones sin verificarlas.
Conclusión: si los requisitos de PPA varían de un producto a otro, el enfoque multiobjetivo se ajusta a una tarea en la que la elección se realiza después de la generación. Si la importancia de los objetivos se conoce y está fijada, la recompensa escalar se ajusta a un caso con un compromiso definido de antemano.
Preguntas frecuentes
Material similar
Todos los materiales
Evaluación de agentes de programación en el desarrollo interactivo de XR: resultados de GenXR-Bench
Se ha publicado GenXR-Bench, un conjunto de 112 tareas expertas para evaluar de forma integral agentes de programación en el desarrollo interactivo de XR: desde la mejora de funciones y la corrección de defectos hasta la creación de aplicaciones con verificación del comportamiento en dispositivos de consumo. Entre los diez modelos probados, el mejor resultado fue un 50,9 % en Pass@1; los fallos recurrentes incluyeron la gestión de eventos asíncronos de sensores, el anclaje de objetos al espacio real y la comprensión de las interacciones en un contexto físico.
5 noviembre 2026
Los LLM médicos se enteran de que se han revisado las recomendaciones, pero a menudo responden según las pautas anteriores
El estudio de ChronoEvo sobre 1709 cambios en las guías clínicas muestra que, en el modelo principal, el 90,8 % de las respuestas detectaba la novedad, pero solo el 58,5 % la aplicaba por completo; la brecha de 32,3 puntos porcentuales se mantuvo en 14 modelos. Ni siquiera aumentar la visibilidad de las actualizaciones produjo una mejora significativa en la incorporación completa de las nuevas reglas a las recomendaciones clínicas.
4 noviembre 2026
Modelo del mundo para agentes basados en LLM cerrados: corrección en puntos de riesgo
Se propone PAWM, un predictor externo que no duplica la observación paso a paso, sino que se activa cuando es probable que ocurra un fallo y desvía al agente de una acción equivocada. Tras el ajuste fino supervisado (SFT) con escenarios sintéticos y el coentrenamiento con GRPO, el método logró una mejora del 24,3 % en ScienceWorld y del 7,7 % en WebArena-Lite para Claude Sonnet 4.5.
4 noviembre 2026