
Anotación híbrida de imágenes: la automatización acelera el entrenamiento de modelos de visión por computadora
El artículo describe cómo el preetiquetado mediante algoritmos reduce el trabajo manual y mejora la calidad de los conjuntos de datos de entrenamiento, así como por qué sigue siendo necesaria la verificación selectiva por parte de una persona. También se analizan las limitaciones del método en condiciones de captura difíciles y con tipos de objetos poco frecuentes.
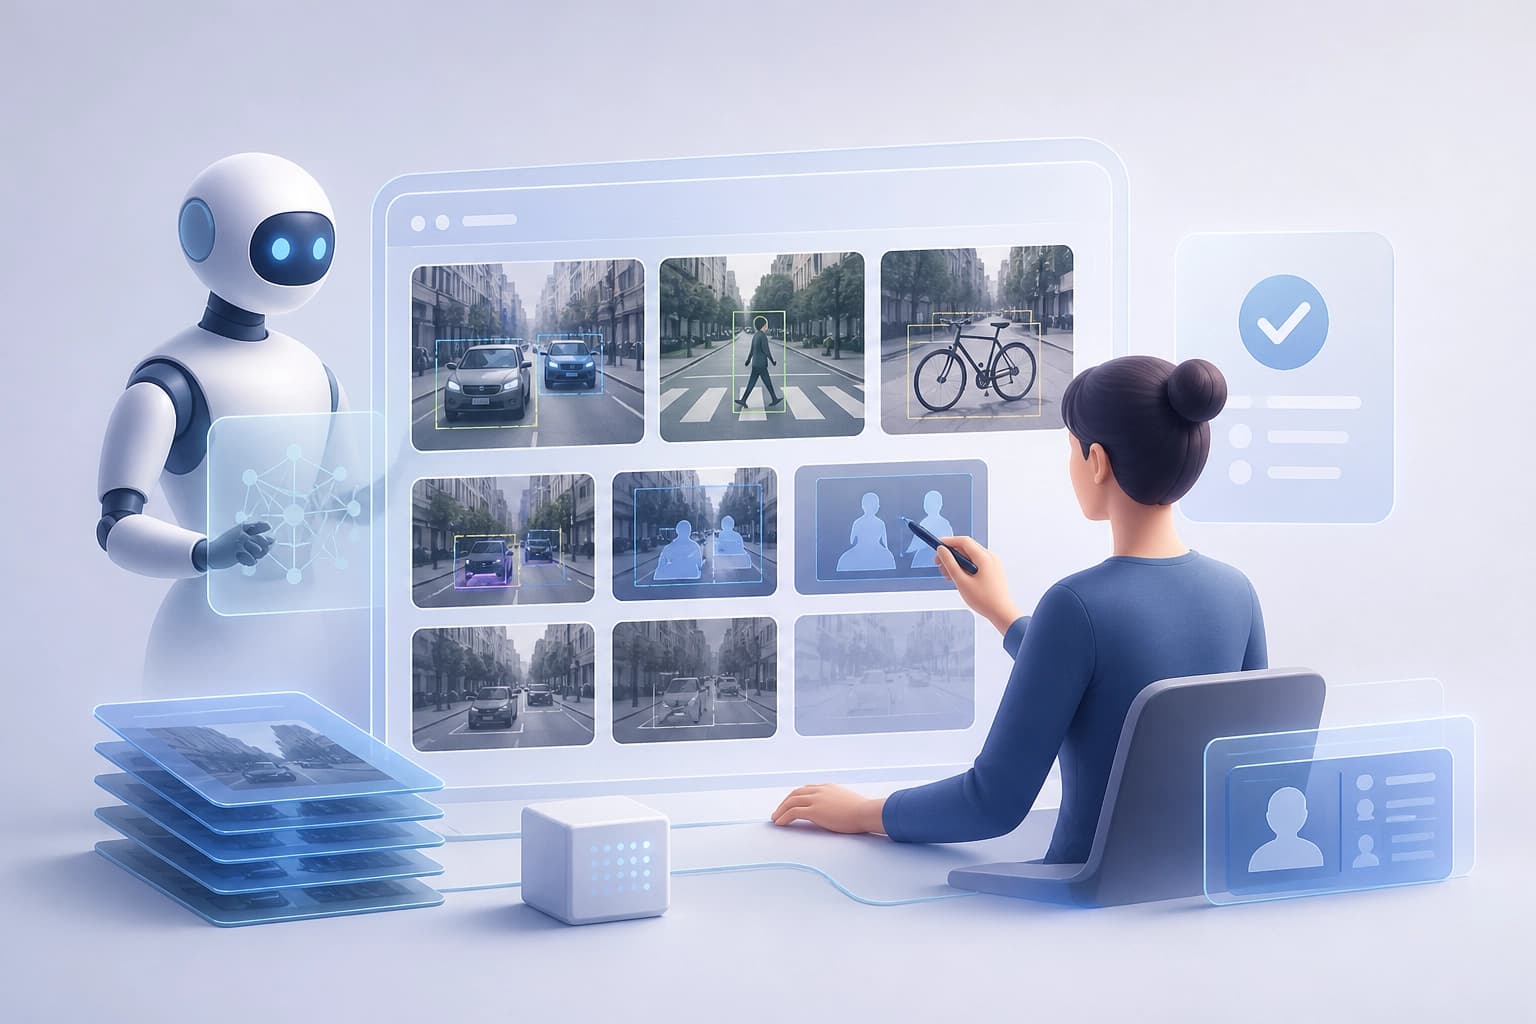
Por qué el etiquetado manual limita el entrenamiento de la visión por computadora
La visión por computadora se entrena con imágenes etiquetadas. El etiquetado ha sido durante mucho tiempo la parte más lenta del desarrollo de estos sistemas. Los modelos de IA modernos necesitan millones de imágenes etiquetadas para funcionar bien.
El trabajo manual no puede seguir el ritmo de este volumen. Por eso, el etiquetado se convierte en un cuello de botella en el entrenamiento de modelos. El etiquetado manual no se adapta a las exigencias de los modelos modernos.
Cómo funciona el etiquetado híbrido
Las herramientas automáticas utilizan modelos preentrenados. Etiquetan imágenes nuevas sin procesar manualmente cada píxel. Una persona revisa y corrige el resultado, en lugar de empezar el etiquetado desde cero.
Etapas del etiquetado híbrido:
- Preetiquetado automático basado en un modelo preentrenado.
- Revisión y corrección del resultado por una persona.
El enfoque híbrido combina la velocidad de la automatización con el control de calidad.
Qué tareas resuelve la automatización del etiquetado
La automatización realiza varios tipos de etiquetado. Lista de tareas:
- detección de objetos y colocación de cuadros delimitadores;
- segmentación semántica;
- segmentación de instancias;
- clasificación de imágenes;
- estimación de puntos clave y poses;
- etiquetado de fotogramas de video.
La automatización cubre las principales tareas de visión por computadora.
Qué ofrece el enfoque híbrido frente al etiquetado manual
| Criterio | Solo manual | Enfoque híbrido |
|---|---|---|
| Tiempo de etiquetado | Referencia para la comparación | Puede reducir el tiempo casi un 40% |
| Tasa de errores | Puede ser hasta un 25% mayor que con el enfoque híbrido | Menor tasa de errores |
| Escalabilidad del conjunto de datos | Requiere aumentar proporcionalmente el equipo de etiquetadores | Permite ampliar los conjuntos de datos sin aumentar proporcionalmente el equipo |
El enfoque híbrido es más rápido, preciso y escalable.
Dónde se utiliza el etiquetado automático
El etiquetado automático se utiliza en:
- vehículos autónomos;
- diagnóstico por imagen;
- comercio minorista y comercio electrónico;
- agricultura y fabricación.
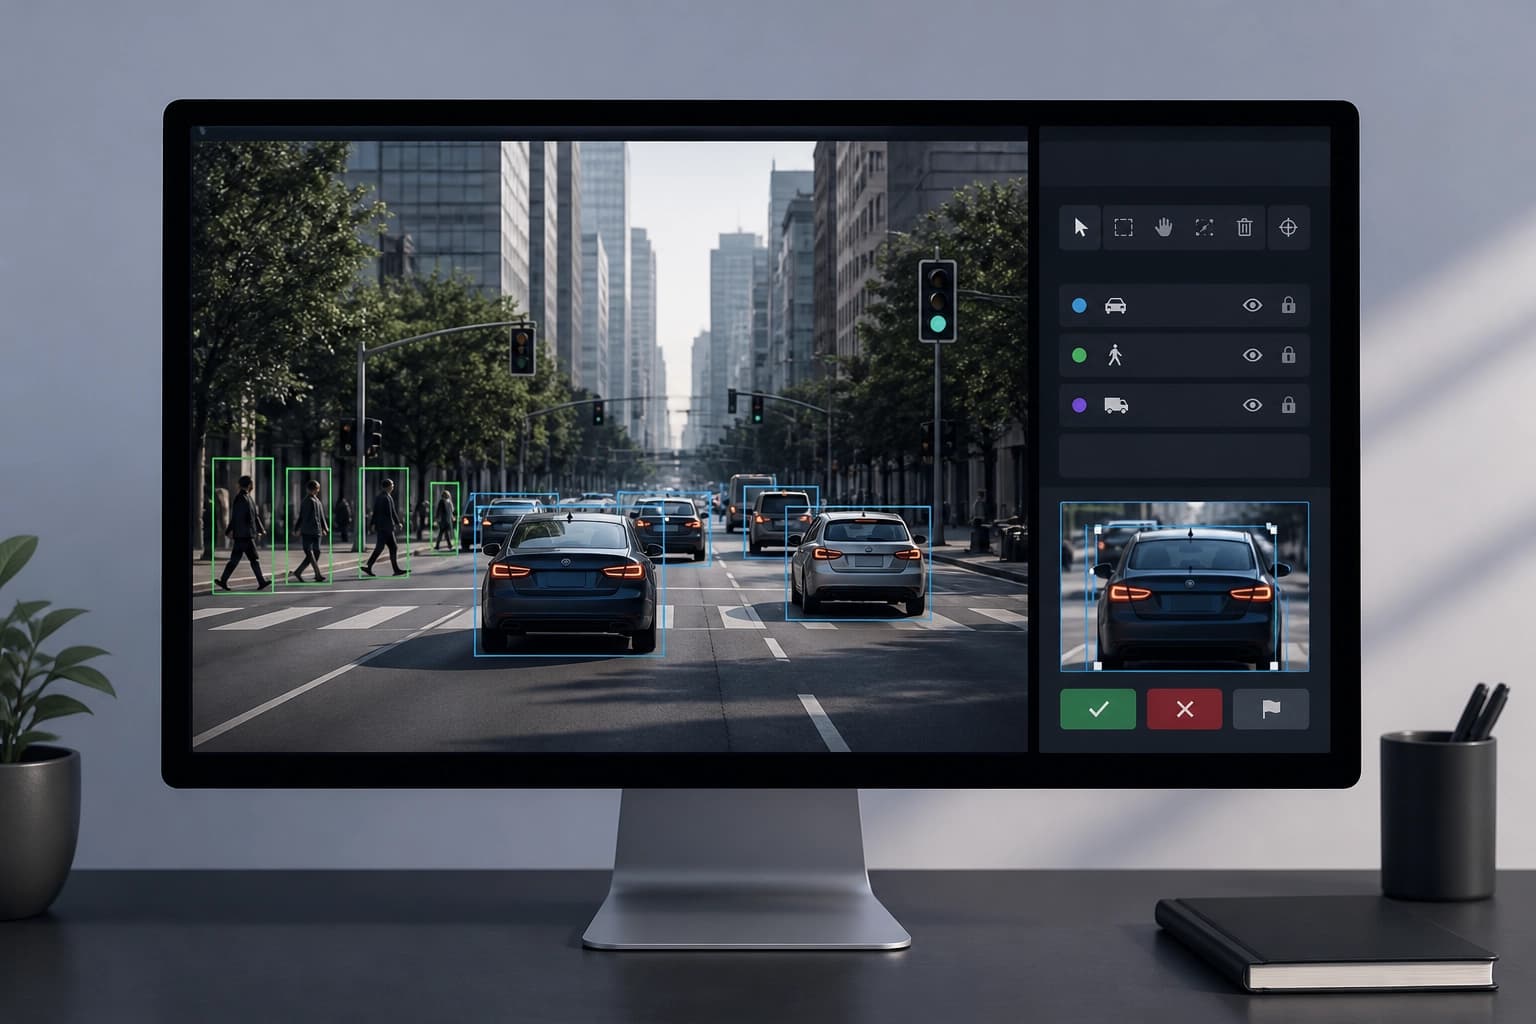
En los sectores donde hay mucho en juego, la calidad del etiquetado es especialmente importante. Los errores en los datos sobre peatones crean riesgos para la seguridad de los vehículos autónomos. Un etiquetado inconsistente de los límites de los tumores puede hacer que un modelo médico no detecte un diagnóstico.
Limitaciones del etiquetado automático
Los sistemas automatizados todavía pueden cometer errores con iluminación inusual, objetos ocluidos, clases de objetos poco frecuentes y casos atípicos. Los sesgos de los datos de entrenamiento pueden trasladarse al etiquetado automático.
Por eso, la automatización se considera una etapa inicial. Se mantiene la revisión humana, sobre todo en el ámbito sanitario. El enfoque híbrido es obligatorio cuando el coste de un error es elevado.
Criterio práctico para elegir un método de etiquetado
Criterios de selección:
- Un alto coste de los errores (seguridad, medicina) exige una revisión humana.
- El crecimiento del volumen de datos sin un aumento proporcional del equipo de etiquetadores se consigue mediante el preetiquetado automático.
- Para las pequeñas empresas, los servicios de etiquetado en la nube y los modelos de código abierto reducen las barreras de entrada.
El método de etiquetado se elige en función del coste de los errores y de las necesidades de escalabilidad.
Preguntas frecuentes
Material similar
Todos los materiales
Quince empresas respaldaron MDK Tether para automatizar la minería.
Los fabricantes de equipos, los pools y los operadores han asumido el desarrollo de integraciones con el conjunto abierto de Tether para unificar la supervisión y la gestión de los equipos; el agente de IA QVAC ya funciona sobre esta base. Aún no se han publicado confirmaciones independientes de una reducción de los costes de electricidad ni de un aumento de la eficiencia.
2 noviembre 2026
Un agente en lugar de un optimizador independiente: un marco unificado que evoluciona en varias tareas a la vez
Los autores demuestran que un único modelo congelado, con una versión inalterada del armazón, primero resuelve tareas y después edita su propio código basándose en registros completos de las ejecuciones. La evolución multitarea de un armazón de 49 líneas mejoró los resultados dentro de la distribución y en benchmarks reservados y, en algunos de ellos, permitió superar a Codex.
29 octubre 2026
Diálogos emparejados con LLM: coincidir con las opiniones actuales intensifica la radicalización más que imponer nuevas posturas
Los autores del preprint arXiv:2609.38296 modelaron una conversación entre un modelo objetivo que interpreta una persona humana y un agente influencer que intenta desplazar sus posturas hacia un polo extremo. Ambos escenarios —reforzar una opinión ya existente y promover otra que antes era secundaria— provocaron cambios en las escalas afectivas y conductuales, aunque el primero resultó más consistente.
27 octubre 2026