
Vector molecular como infraestructura
En química computacional, el embedding de una molécula dejó de ser hace tiempo un detalle técnico. Es una infraestructura reutilizable: una misma representación vectorial sirve tanto para predecir propiedades de un compuesto como para el cribado virtual y la búsqueda de moléculas similares. Se calcula una vez y se aplica en decenas de escenarios, desde el ranking de bibliotecas hasta la selección de candidatos para el laboratorio.
El callejón sin salida de una sola representación
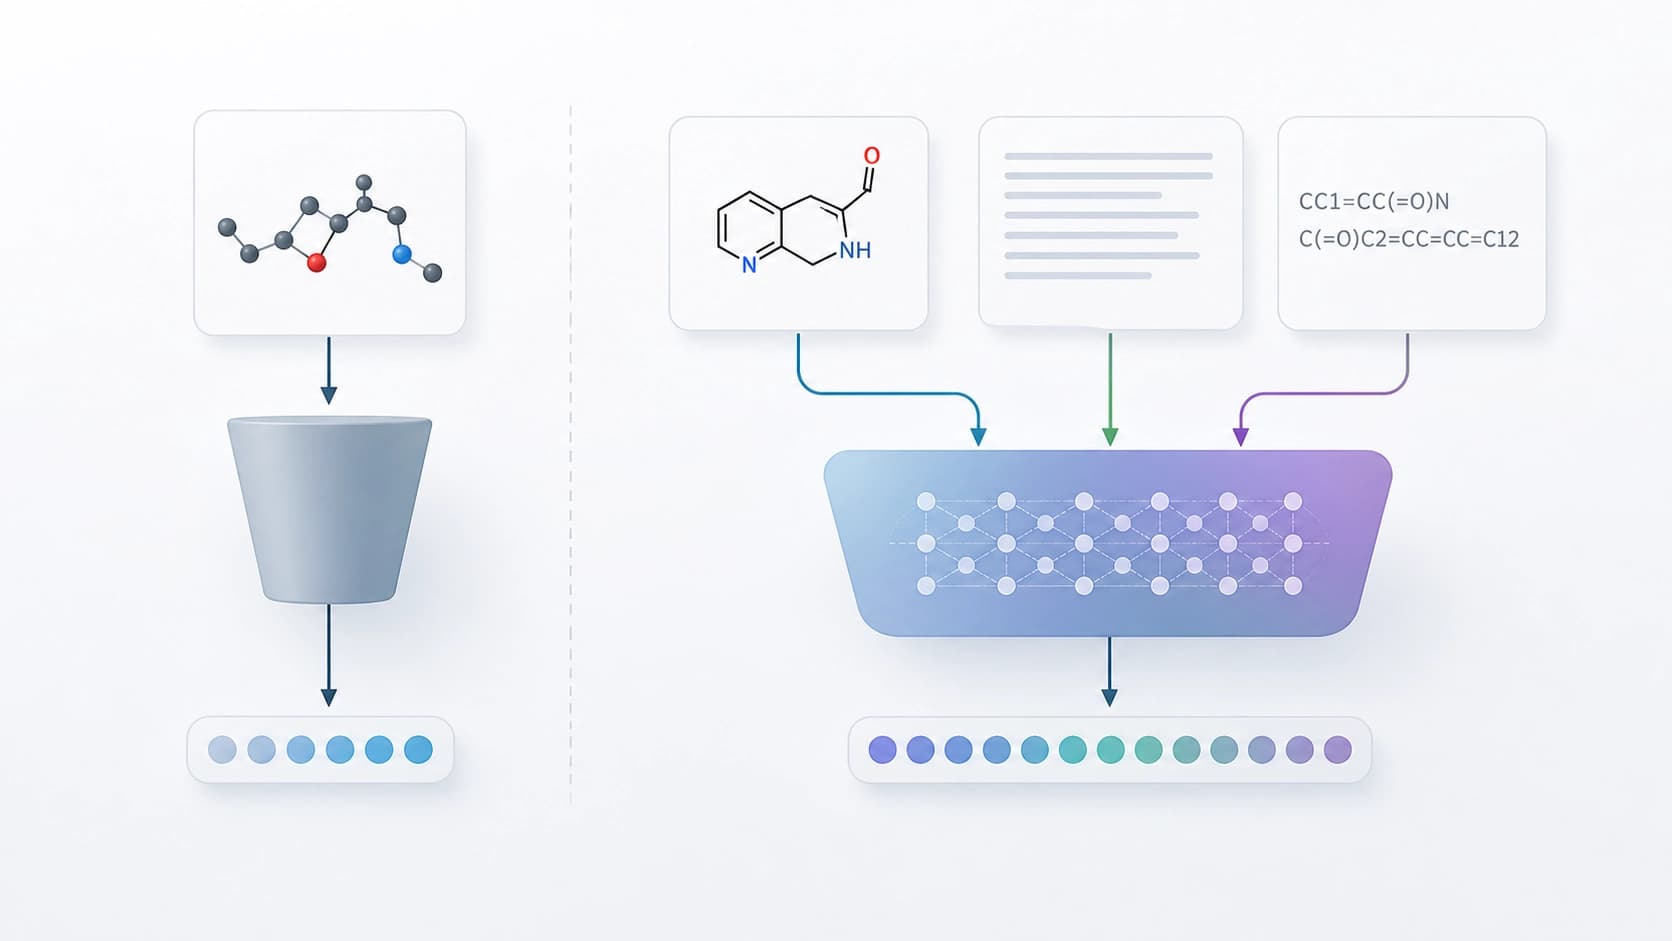
Casi todos los codificadores moleculares siguen un mismo esquema: se elige una única modalidad —el grafo de átomos, la cadena SMILES, un conjunto de descriptores fisicoquímicos o la conformación 3D— y el modelo se entrena estrictamente sobre ella. El vector resultante es incondicional. No hay una interfaz mediante la cual se pueda precisar la consulta: «necesito un análogo por mecanismo de acción, no por esqueleto carbonado» o «un compuesto similar, pero orientado a la solubilidad».
De ahí se deriva un efecto incómodo. Distintos modelos ven la misma molécula de maneras diferentes, y sus representaciones no pueden compararse directamente porque los espacios no están alineados. Además, el químico se ve obligado a tener presente qué codificador conviene para cada tarea, en lugar de simplemente formular la tarea con palabras.
La pregunta que se plantearon los autores
El trabajo de Xinjian Zhao, Xiangru Jian, Yaoyao Xu, Xiaozhuang Song, Wei Pang, Lei Bai y Tianshu Yu (arXiv:2608.23646, 24 de agosto de 2026; presentado en el taller FM4LS en el marco de ICML 2026, non-archival) parte precisamente de esa insatisfacción. Los investigadores se preguntan: ¿por qué construir un codificador distinto para cada representación de una molécula, si los LLM multimodales ya saben trabajar de forma nativa con imágenes, texto y notaciones simbólicas?
La lógica es simple. Si el modelo ya «ve» la imagen de una fórmula estructural, lee una descripción y analiza un SMILES, se lo puede convertir no en un asistente-consultor, sino en un generador de vectores. Y además, de vectores condicionados: que dependen no solo de la molécula en sí, sino también de lo que se pregunta sobre ella en lenguaje natural.
Cómo está construido el framework
MolEmb es una capa ligera, no un nuevo modelo grande. Adapta un MLLM ya existente para que los perfiles moleculares y sus descripciones textuales queden en un mismo espacio común de embeddings. El elemento clave es un objetivo contrastivo bidireccional: acerca entre sí los pares «molécula — texto» y, al mismo tiempo, aleja los pares que no coinciden.
Por qué esto es más importante de lo que parece
El aprendizaje contrastivo resuelve aquí dos problemas a la vez. En primer lugar, define un sistema de coordenadas común: el vector de una molécula y el vector de su descripción pasan a ser comparables. En segundo lugar, habilita la búsqueda cross-modal en ambas direcciones —encontrar texto a partir de una molécula y encontrar una molécula a partir de un texto—, y además dentro de un mismo espacio, sin traductores intermedios entre modalidades.
El resultado declarado es más modesto que un «superamos todos los benchmarks», y por eso mismo resulta más creíble: las representaciones obtenidas son competitivas en la predicción de propiedades moleculares y, a la vez, admiten la búsqueda entre modalidades. Es decir, la interfaz en lenguaje natural no se compró a costa de degradar las tareas clásicas.
El lenguaje como palanca de control
La principal diferencia respecto de los codificadores tradicionales está en el condicionamiento. Un modelo especializado devuelve un único vector fijo para una molécula. El framework, en cambio, permite formular una condición con palabras y obtener una representación desplazada hacia esa condición. Una misma molécula puede representarse de maneras distintas según si interesa su toxicidad, su solubilidad o su cercanía a una clase concreta de compuestos.
Búsqueda molecular que depende del contexto
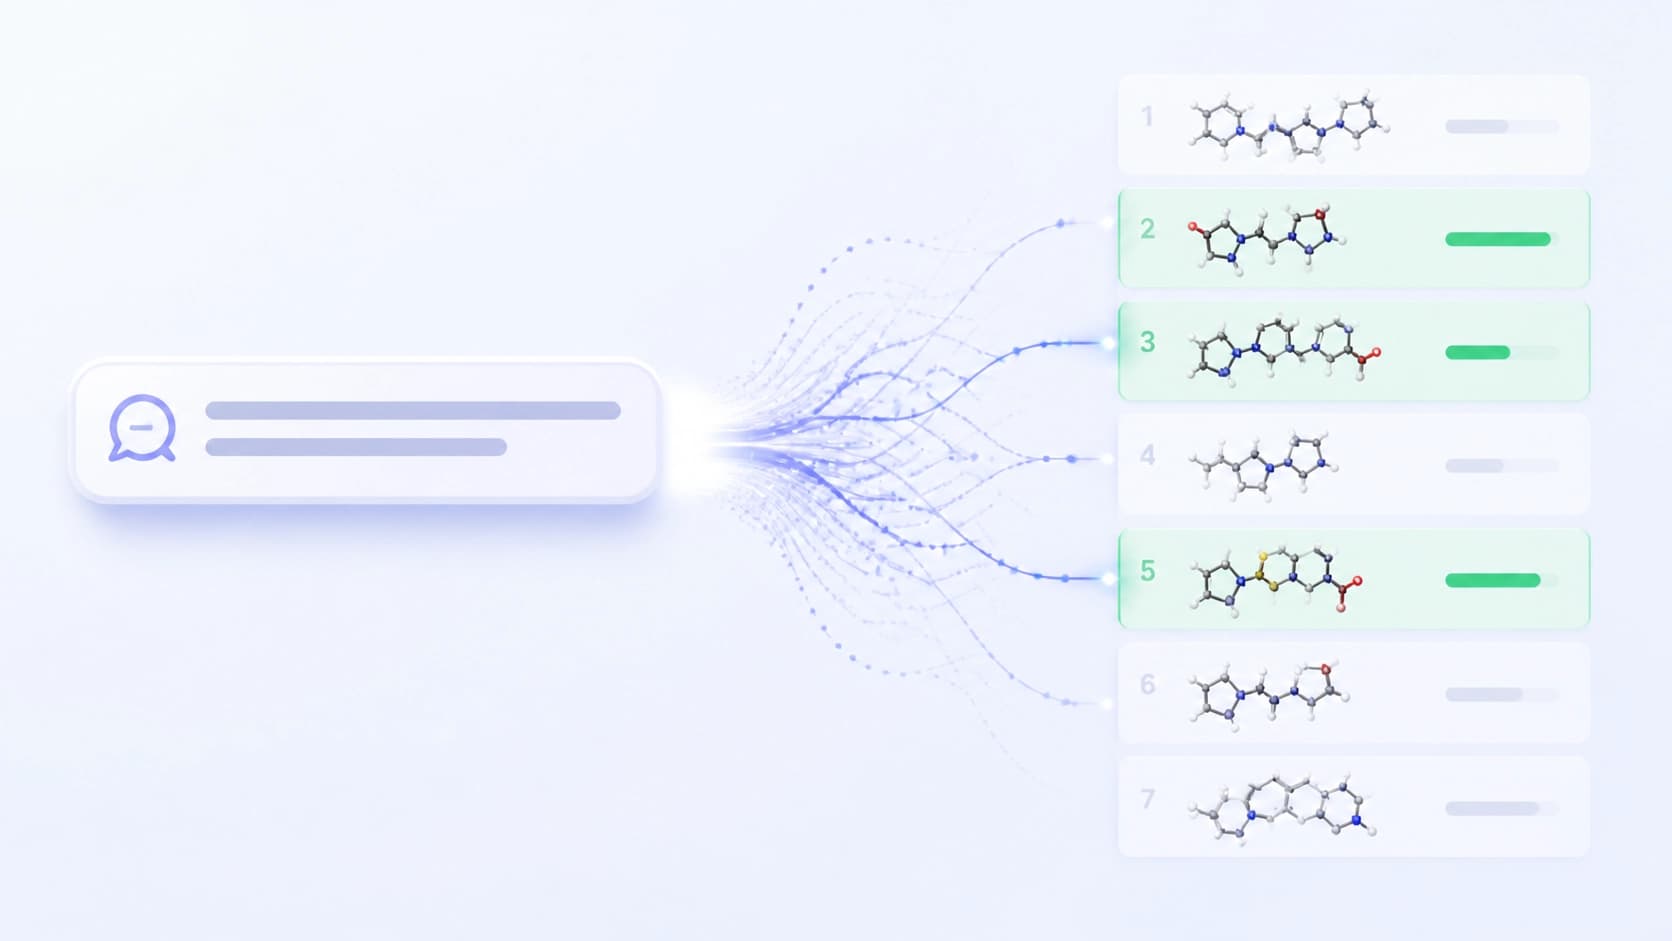
Una parte aparte del trabajo es el benchmark diagnóstico MolCAR. Fue creado para evaluar la búsqueda dependiente del contexto, es decir, situaciones en las que la respuesta correcta cambia según cómo se formule la consulta. Esto es radicalmente más difícil que la búsqueda clásica de estructuras similares: allí la referencia es única, aquí depende del planteamiento de la tarea.
La conclusión más interesante
Quizá la observación más valiosa de los autores suena casi trivial: el embedding molecular dependiente del contexto es, ante todo, una propiedad de los datos de supervisión, no un truco arquitectónico. En otras palabras, el modelo empieza a distinguir contextos no porque se le haya incorporado un módulo ingenioso, sino porque se lo entrenó con pares en los que el contexto realmente difiere.
La conclusión es sobria y útil a la vez. Desplaza el foco de la carrera de arquitecturas hacia la calidad y la estructura de los datos de entrenamiento: si las descripciones de las moléculas en el dataset son homogéneas, ninguna multimodalidad le regalará al modelo sensibilidad a los matices de la consulta.
Qué cambia esto en la práctica
Si este enfoque escala, la ganancia se ve así:
- Una infraestructura única en lugar de un zoológico de codificadores. Un solo modelo cubre propiedades, búsqueda y consultas cross-modales.
- Consultas con palabras en lugar de elegir un modelo. El usuario no necesita saber qué codificador es mejor para su caso.
- Espacios compatibles. Los vectores de moléculas y de textos conviven, lo que significa que pueden compararse y combinarse.
- Reutilización de MLLM ya existentes. El framework adapta un modelo existente en lugar de entrenarlo desde cero.
Límites y preguntas abiertas
El trabajo está marcado como non-archival, así que estamos ante una dirección de investigación más que ante un producto terminado. Quedan bastantes preguntas: hasta qué punto el enfoque es robusto fuera de los conjuntos de datos evaluados, cómo se comporta con clases de compuestos poco frecuentes, si la parte lingüística empieza a dominar sobre la química y si eso convierte el vector en una paráfrasis del texto en lugar de una representación con sentido físico.
Aun así, la idea principal queda formulada con claridad. Los LLM multimodales no son solo asistentes químicos ni solo generadores de respuestas. Aspiran a ser un mecanismo general de embeddings moleculares: ampliable, controlable con palabras y abierto al fine-tuning para nuevas tareas.


