
El protocolo que nadie ejecuta al pie de la letra
Es raro que un protocolo de laboratorio se ejecute literalmente. Entre la publicación y el experimento real casi siempre media una adaptación: otra línea celular, un reactivo sustituido, menos muestras, un instrumento ajeno, un presupuesto recortado. Para alguien con las manos en el banco esto es rutina, pero una rutina traicionera: cualquier cambio arrastra una cadena de consecuencias. Modificas el volumen de un reactivo en un paso temprano y tienes que recordar cómo repercutirá en la etapa de lavado y cómo encaja con lo que ya se hizo antes. Precisamente esa capacidad —tener presente el protocolo entero y modificarlo con criterio— es lo que pone a prueba el nuevo conjunto de tareas.
La investigación se publicó con el nombre BenchBench-Protocol en el preprint arXiv:2608.23898v1 (cs.AI), enviado el 24 de agosto de 2026. Los autores son Aditya Sivakumar, Ashu Singhal, Nicholas Larus-Stone y Nithin Parsan. Son 21 páginas y 15 figuras, es decir, un material más metodológico que promocional.
Cómo se armaron 149 tareas a partir de correcciones en borrador
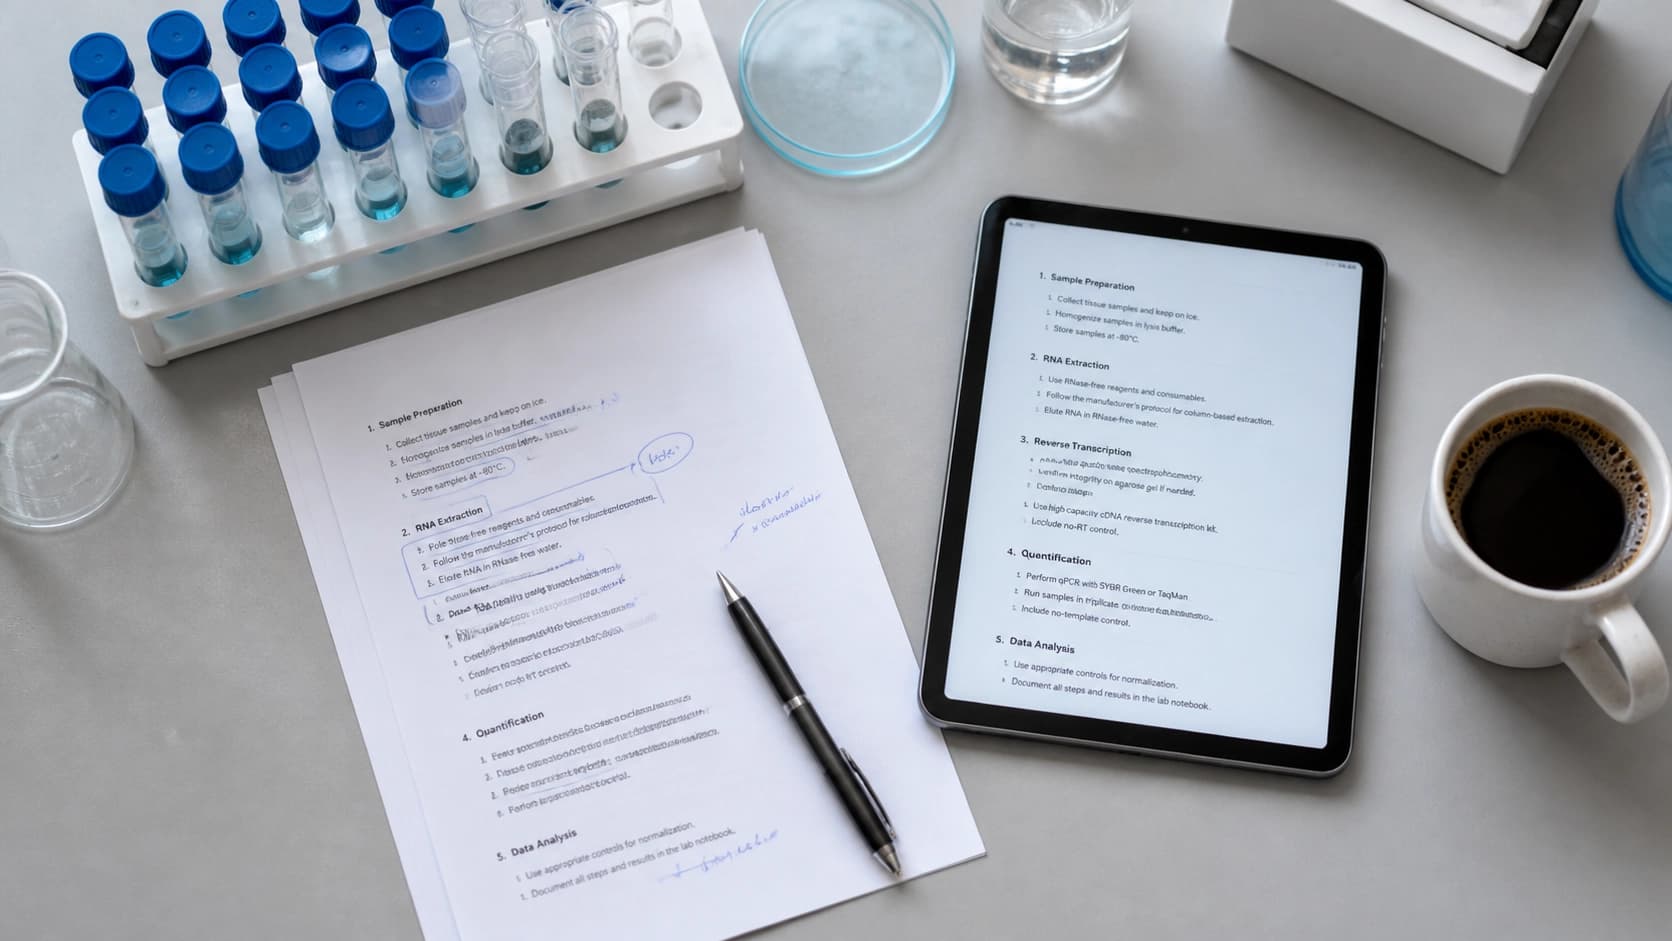
La mecánica de BenchBench-Protocol es poco habitual. Los autores no se sentaron a escribir preguntas: tomaron un rastro de trabajo ya existente. De cada protocolo publicado apareció una versión que el científico había ajustado para su experimento concreto. La diferencia entre esos dos documentos se convirtió en la tarea: a los modelos se les muestra el protocolo original y las condiciones del nuevo experimento, y deben proponer la modificación correcta.
De este enfoque se desprende de inmediato un detalle importante: la tarea no tiene una «respuesta correcta» abstracta, sino una rúbrica ponderada. Porque la corrección que introdujo un investigador real se conoce: se puede descomponer en elementos y evaluar hasta qué punto la propuesta del modelo coincide en sentido con la solución real, y no en la formulación. Esto elimina el eterno problema de los test biomédicos, donde el modelo puede dar una respuesta razonable pero que no coincide con la de referencia y recibir un cero.
La base resultó sólida: 96 protocolos originales de nueve áreas de biología de laboratorio húmedo. En el conjunto final solo entraron las tareas que superaron la revisión de expertos con puntuaciones altas; el resto se descartó. El resultado son esas mismas 149 tareas.
Por qué no es otro conjunto de preguntas de expertos
Los autores explicitan el contexto aparte. En los últimos años los benchmarks biomédicos sí se han desplazado hacia tareas abiertas con evaluación por rúbricas: eso es un avance. Pero las tareas mismas siguen siendo, las más de las veces, inventadas por expertos: se sientan y escriben preguntas a partir de su experiencia. Ese enfoque está limitado por el hecho de que el experto responde a una pregunta que él mismo formuló, es decir, se ajusta implícitamente a su propia idea de la dificultad.
Aquí la lógica es la inversa. La tarea surge donde una persona real ya se topó con un problema real y dedicó tiempo a resolverlo. Esto no garantiza una pureza ideal de los datos, pero sí garantiza que el problema no se inventó por una formulación bonita.
Quién lo logró y quién no
En la evaluación participaron nueve modelos, tanto cerrados como abiertos. La dispersión resultó notable, aunque no dramática.
El mejor resultado lo mostró Claude Opus 5: 59,2% de puntuación normalizada según la rúbrica. Los demás modelos se situaron en un rango de entre 34,1% y 47,1%. Dicho de otro modo, nadie alcanzó al líder, pero tampoco hay un fracaso a la mitad: todos los modelos algo saben hacer, solo que lo hacen de forma distinta y no siempre hasta el final.
Un apartado propio del informe es la comprobación de saturación. Los autores dieron a los modelos diez intentos y eligieron el mejor de ellos (best-of-10). Incluso con un esquema tan generoso, el benchmark no se «desplomó»: no se alcanzó el techo. Para una evaluación esto es una buena noticia: significa que el conjunto de tareas no quedará obsoleto tras la salida de la siguiente generación de modelos.
Qué se deduce de esto en la práctica
La primera conclusión es aplicada y un tanto aleccionadora. Todavía no se puede confiar por completo a un modelo de lenguaje la adaptación de un protocolo. Incluso el mejor resultado, un 59,2%, significa que aproximadamente en cuatro de cada diez casos la propuesta requiere la intervención de una persona. El modelo sirve como borrador, como generador de variantes, como forma de contrastar rápidamente eso que quizá se te pasó por alto. Pero la responsabilidad final sobre el tubo de ensayo no es suya.
La segunda conclusión es metodológica, y es más interesante que la primera. Los autores consideran su trabajo no solo como una evaluación del razonamiento en el laboratorio húmedo, sino también como prueba de una idea más general: los experimentos reales son una fuente subestimada de tareas para los benchmarks. Si en el laboratorio ya existe un historial de correcciones, entonces también hay material para evaluar modelos, y además un material que es imposible inventar desde el escritorio.
La tercera conclusión tiene que ver con hacia dónde avanzar. La diferencia entre 59,2% y 47,1% no parece un abismo frente a la dificultad de la tarea en sí. Es más bien un indicio de que el cuello de botella no está en el volumen de conocimientos del modelo sobre biología, sino en la capacidad de construir una cadena: tener en cuenta las decisiones previas y predecir a qué conducirán en los pasos siguientes. Precisamente a esa cualidad, y no a la memorización de hechos, está dedicado el conjunto de 149 correcciones.


