
Breve: dónde duele exactamente
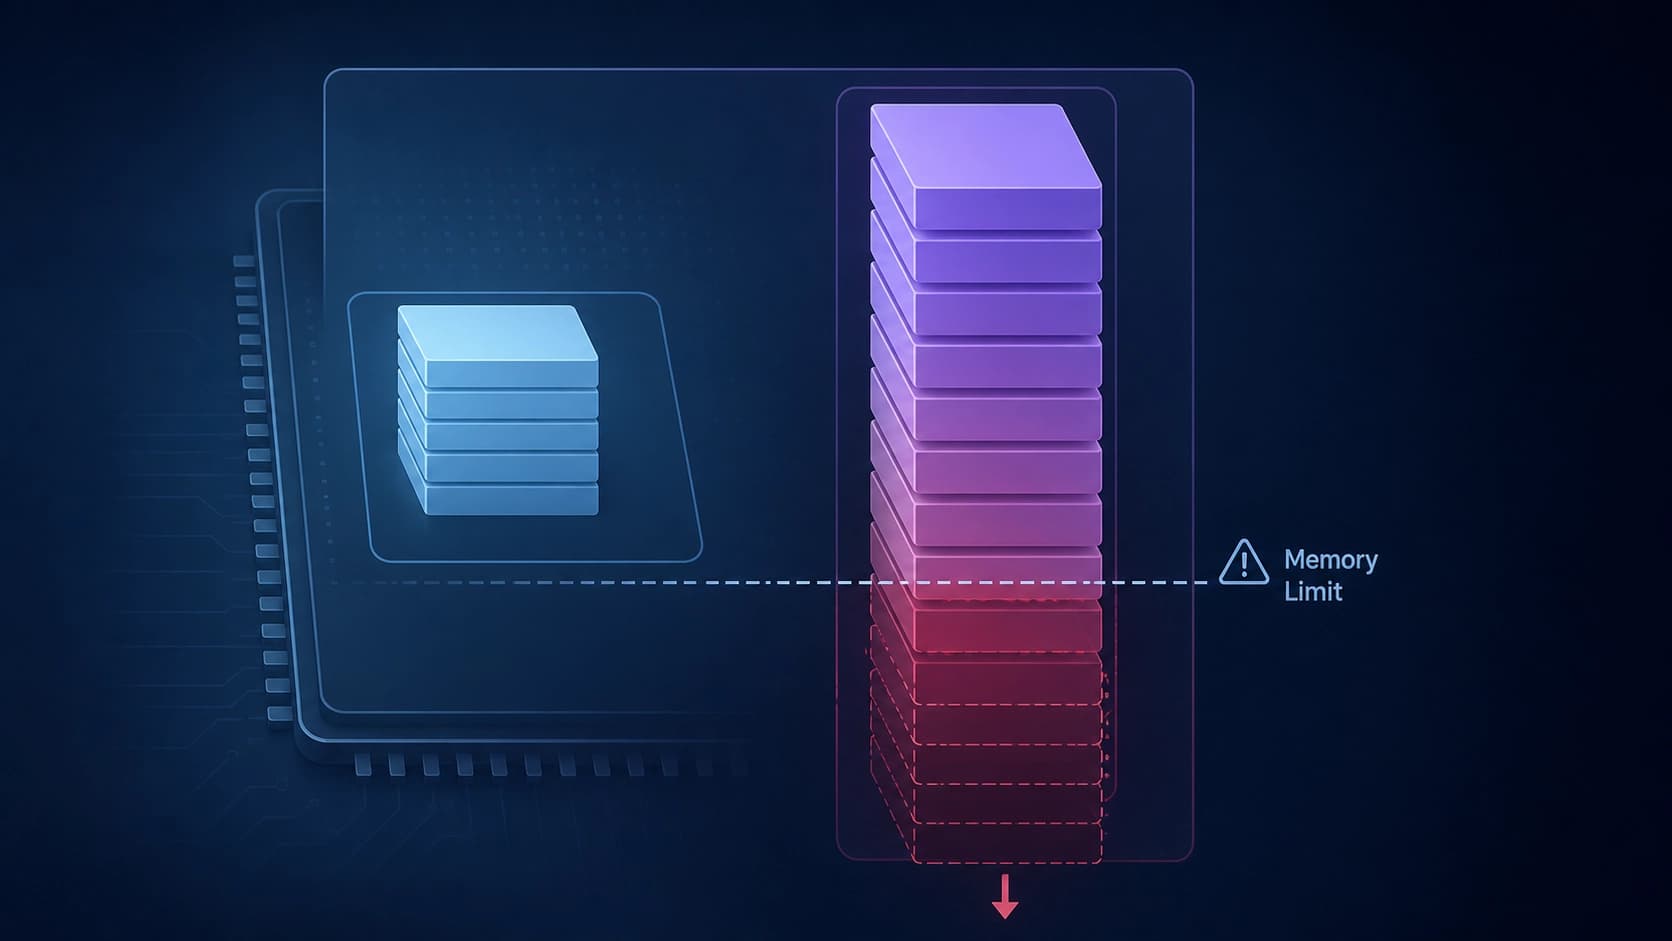
Cuando un modelo de contexto largo atiende una consulta, los principales costos no se van en los pesos, sino en la caché KV: las claves y valores guardados para todos los tokens ya leídos. Cuanto más largo sea el documento o el diálogo, más tensores hay que mantener en memoria y más datos hay que releer en cada paso de generación. De ahí el dilema típico: o recortar el contexto, o pagar por él con memoria y velocidad de inferencia.
Las soluciones existentes suelen elegir uno de dos extremos. O comprimen todo el estado por completo, arriesgándose a perder información reciente, que es justo la que se necesita para la siguiente respuesta, o lo dejan todo en precisión original y chocan con la capacidad del acelerador.
Es precisamente en esta encrucijada donde intenta intervenir el trabajo del que se habla a continuación.
Qué proponen los autores
El artículo «Minima-KV: Retention-Preserving KV Cache Compression with Mixed-Format Paged Attention» fue enviado a arXiv el 24 de agosto de 2026 con el número 2608.23834, categoría cs.AI, 13 páginas y 3 figuras, DOI 10.48550/arXiv.2608.23834. Los autores son Sergii Kozyrev y Davyd Maiboroda, de Minima AI, Inc. Un detalle curioso: en el bloque de enlace al PDF en la página del preprint, la firma apunta al primer autor «y dos más», aunque en la descripción bibliográfica solo se enumeran dos. Es una minucia, pero recuerda que conviene verificar los metadatos de los preprints.
La esencia de la propuesta de Minima-KV es una jerarquía de páginas de la caché KV, donde distintas páginas se almacenan en distintos formatos numéricos. La palabra clave del título es retention-preserving, es decir, «que preserva la retención»: el estado de las consultas recientes no se desaloja a ningún lado.
Anclas en FP8, archivo en TQ3
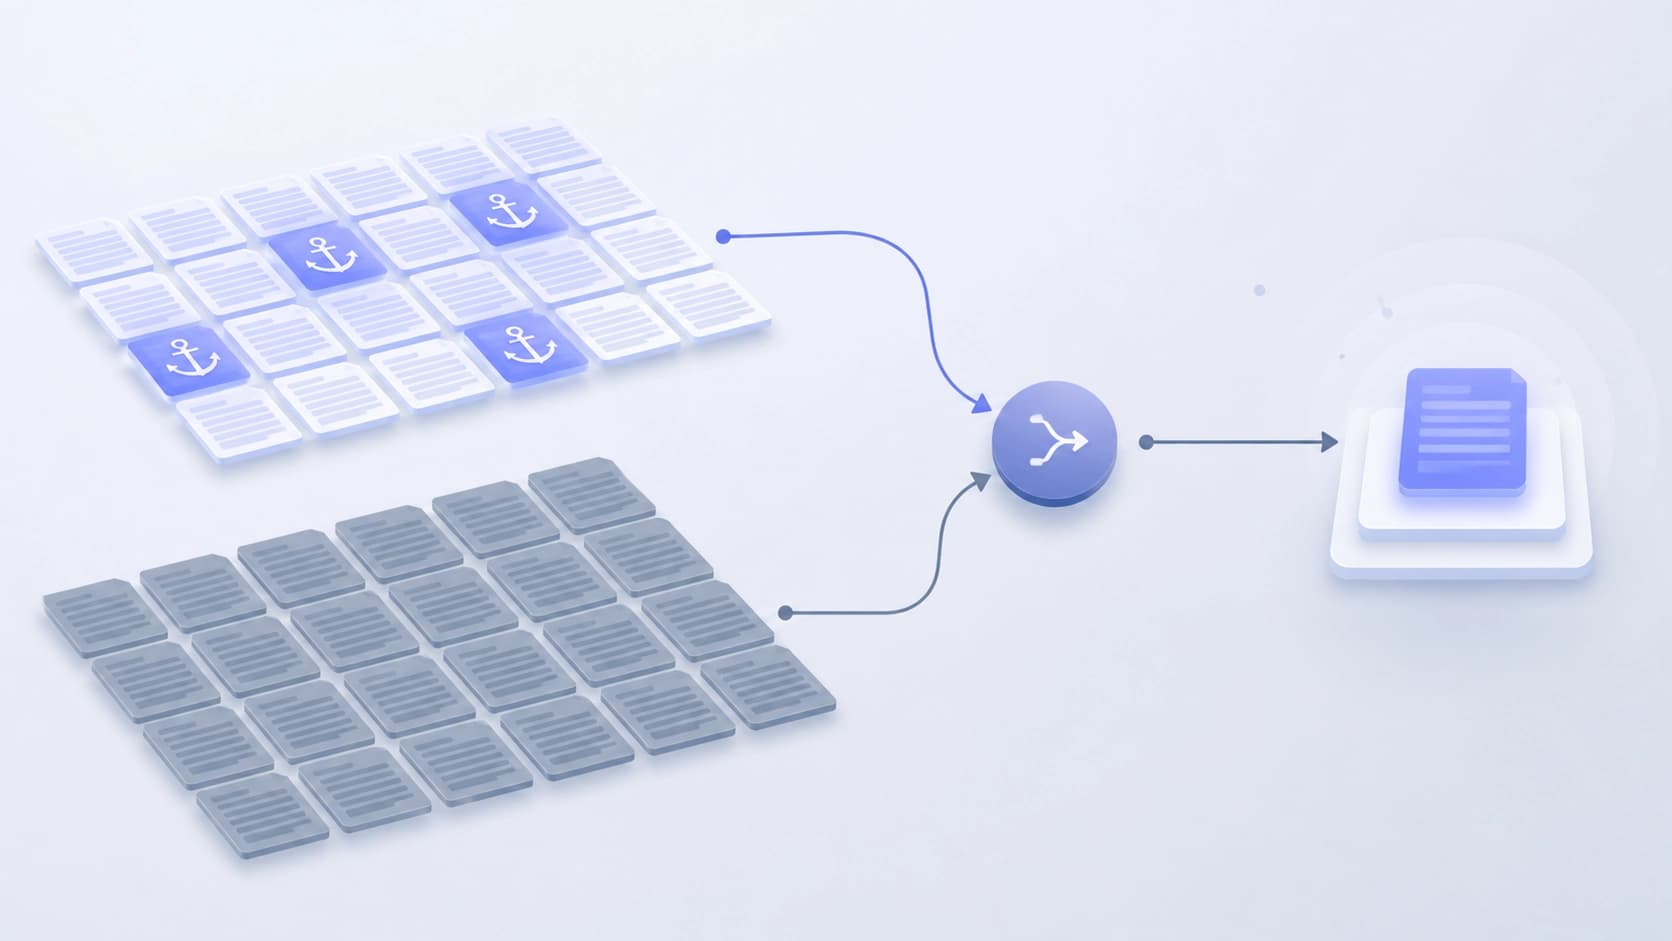
La lógica de la división es simple. Las páginas que se usaron recientemente y están marcadas como protegidas (anchor) permanecen en FP8. Las páginas más antiguas que no entraron en las ancla se convierten a packed TQ3, un formato empaquetado más denso. Además, cada página de una consulta viva sigue siendo direccionable directamente: nada se descarta del espacio de direcciones ni se sustituye por una copia aproximada.
Cómo se combinan los resultados parciales
Lo más interesante es la aritmética. Kérneles separados para cada formato calculan sus propios estados parciales de atención, y luego se combinan mediante un online-softmax merge con normalización global. En palabras simples: en lugar de llevar todas las páginas a un mismo tipo antes del cálculo, el sistema calcula la contribución de cada grupo en su propio formato y suma correctamente los resultados normalizados.
Gracias a esto, la decodificación va directamente sobre la caché heterogénea, sin la llamada sombra densa: una copia completa de la caché en un formato único que anularía todo el ahorro de memoria.
Qué muestran las mediciones
Memoria y compresión
Las mediciones se realizaron sobre perfiles vinculados a una configuración concreta del modelo Qwen3.6-27B en un único acelerador NVIDIA RTX PRO 6000 Blackwell con 96 GB de memoria. Se obtuvo 18,3 KiB de KV de atención por cada token vivo. Esto es una compresión de 3,50x respecto a BF16 y de 1,75x respecto a FP8.
La segunda cifra es más importante de lo que parece a primera vista. La comparación con FP8 muestra que la ganancia no se logra solo por pasar de media precisión a formatos más económicos, sino precisamente por el esquema híbrido de almacenamiento.
Calidad en contexto largo
El perfil materializador —aquel donde las páginas híbridas realmente se despliegan en tensores— coincidió con su control denso en las tareas RULER needle-in-a-haystack a 16K. Es decir, en la búsqueda de la aguja en el pajar no se detectó diferencia.
Después empiezan los compromisos. En el conjunto LongBench v2 de 503 preguntas, los deltas resultaron negativos: -0,80 puntos porcentuales a 16K, -0,60 a 32K y -0,40 a 64K. Preste atención a la forma de la curva: las pérdidas no crecen linealmente con la longitud del contexto, sino que fluctúan ligeramente. Los autores no aportan una explicación, pero el hecho en sí conviene tenerlo en cuenta al interpretar: una dispersión de décimas de porcentaje se confunde fácilmente con ruido de medición.
Prueba canario
Una prueba aparte es el single-pair canary, donde se compararon dos decodificaciones directas con consultas de 59 008 tokens cada una. Resultados: el KV activo se comprimió 3,625 veces, el rendimiento fue de 0,9821x respecto al control, las 16 capas de atención completa se enrutaron sin fallback al modo denso, y no se guardó ninguna sombra densa.
Un rendimiento ligeramente por debajo de uno es, en esencia, un intercambio honesto: alrededor de dos por ciento de velocidad por una reducción múltiple de la memoria ocupada.
Conclusiones y salvedades
La conclusión declarada por los autores es prudente: los resultados muestran un camino práctico hacia la compresión del estado de contexto largo en formatos mixtos sin desalojar las páginas de las consultas vivas. Esto es justo lo que faltaba a los enfoques anteriores: una compresión que no sacrifica los datos recientes en favor de los antiguos.
Qué conviene tener en cuenta al leer:
- Los perfiles de prueba están vinculados a la configuración. Se trata de un modelo concreto y un acelerador concreto; no se demuestra la transferibilidad de las cifras a otras arquitecturas.
- La prueba canario es estrecha. Un par de consultas, un escenario de decodificación directa: es una ilustración de funcionamiento, no una estadística de carga.
- La caída en LongBench v2 no es nula. Décimas de punto porcentual es poco, pero en tareas donde cada unidad de precisión importa, ya es motivo para una medición propia.
- No hay datos sobre latencia en condiciones de producción. El rendimiento en la prueba canario, según la descripción, pasa enteramente por 16 capas sin ruta de reserva: es interesante cómo se comportará el enrutamiento en el peor escenario, cuando las páginas ancla se vuelven más numerosas de lo habitual.
El valor práctico del trabajo no está en cifras récord de compresión, sino en otra cosa: muestra que una caché heterogénea se puede atender directamente, sin armar su copia completa para cada paso. Si este enfoque se traslada a otros modelos, los escenarios de contexto largo ganan una palanca más, además del escalado de hardware.


