
Problema: la traza de un agente es un log, no un modelo de comportamiento
Un agente LLM de varios pasos deja tras de sí un rastro largo: llamadas a herramientas, razonamientos intermedios, correcciones, reintentos. Leerlo con los ojos casi no tiene sentido: cientos de líneas de texto donde la señal útil queda diluida en todo el volumen. Para el desarrollador que despliega un agente en producción, ese log se convierte en una caja negra: no queda claro ni dónde exactamente la ejecución se desvió, ni qué estados son siquiera típicos del sistema.
De esto trata precisamente el trabajo arXiv:2608.23670 (cs.AI) «Automata from Agent Traces: Failure and Next-Step Prediction»: sus autores Seonglae Cho, Franklin Cardenoso Fernandez, Umar Mohammed, Zekun Wu, Kleyton Da Costa, Ilham Wicaksono y Adriano Koshiyama proponen ver las trazas no como texto, sino como datos sobre transiciones entre estados. La lógica es simple: si el comportamiento del agente se repite de una ejecución a otra, entonces detrás del caos aparente hay una estructura, y esa estructura se puede reconstruir.
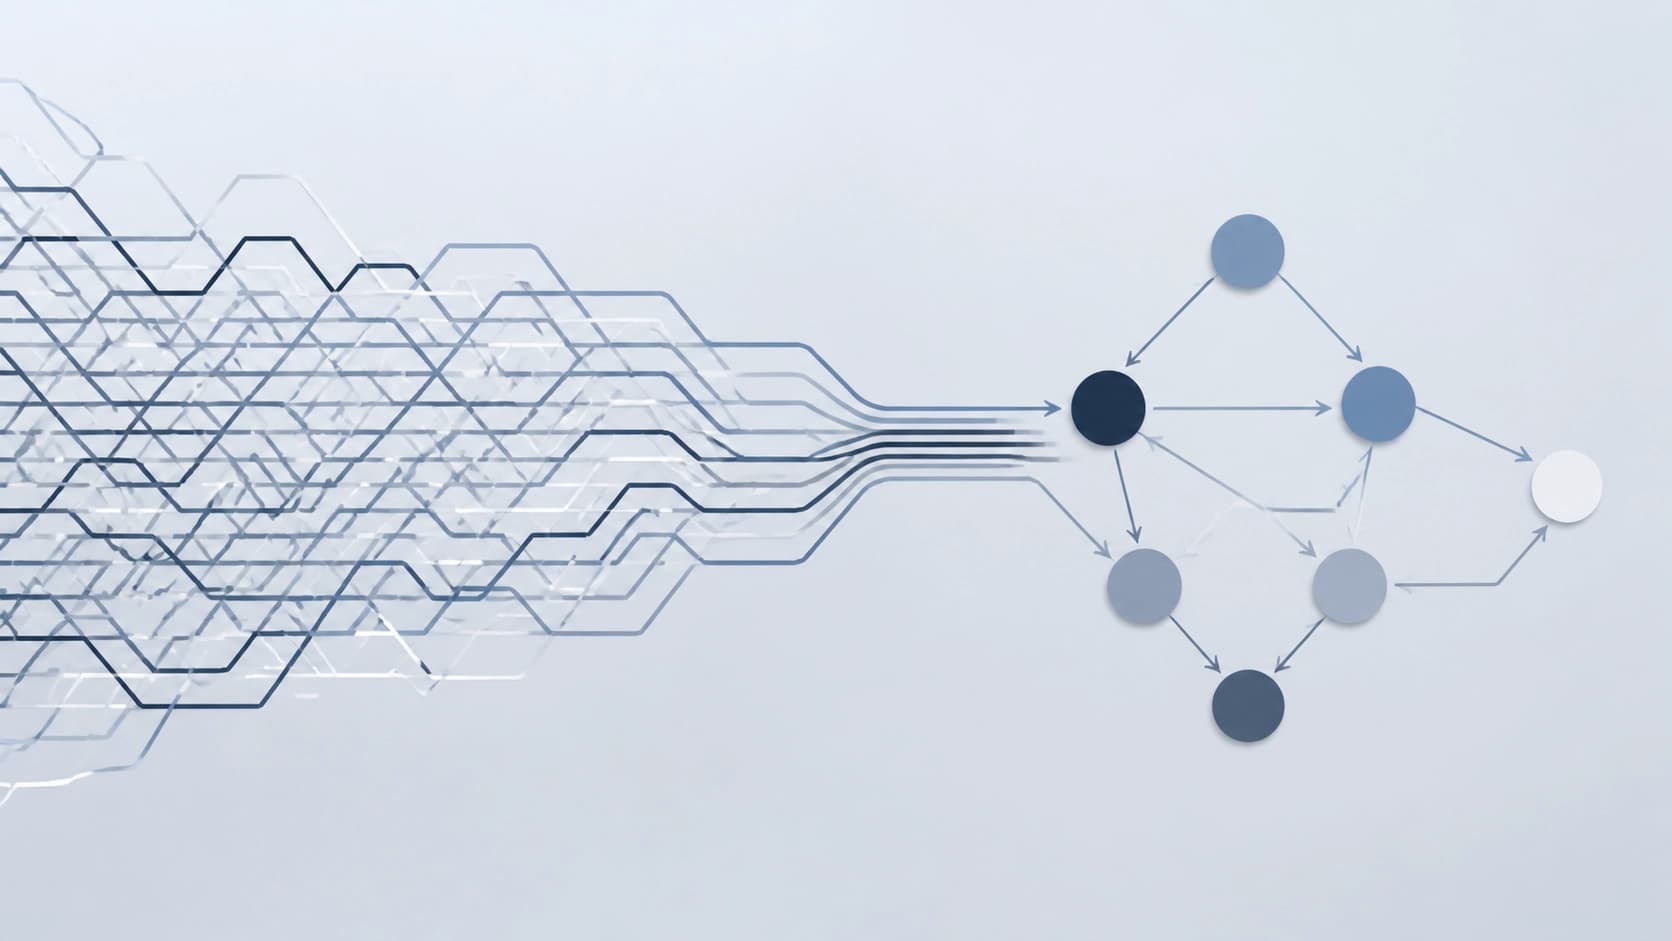
Merece la pena señalar aparte qué les faltaba a los enfoques anteriores. El análisis solía hacerse traza por traza o se apoyaba únicamente en ejecuciones exitosas. En ambos casos se pierde la imagen de conjunto: esa topología que conecta entre sí la predicción de la siguiente acción y la predicción de fallo. Y es justamente la que se necesita tanto para auditar la seguridad como para monitorizar en tiempo real.
Un solo autómata para todo el corpus
La idea del método: tomar todo el conjunto de trazas y reducirlo a una única máquina de estados finitos (FSM) compacta. No un árbol de decisión por ejecución, no embeddings en algún lugar del espacio vectorial, sino un grafo normal con estados y transiciones: ese mismo sustrato estructural que hace que el comportamiento del agente sea, si no predecible, al menos descriptible.
Los resultados sobre doce datasets públicos resultan alentadores:
- los autómatas salen pequeños: de 7 a 43 estados, es decir, se pueden dibujar de verdad y discutir en una llamada;
- sobre datos reservados reproducen las trazas con un fitness no inferior a 0.997, una correspondencia casi perfecta;
- la topología construida sobre distintos splits de un mismo dataset resulta prácticamente idéntica;
- el ensamblaje en sí lleva milisegundos, no horas de entrenamiento.
El último punto es más importante de lo que parece. Un método que se construye al instante se puede reensamblar tras cada cambio de prompt o de configuración, y ver de inmediato si el comportamiento del sistema ha cambiado.
Por qué esto no es solo una visualización bonita
La compacidad aquí no es un fin en sí mismo. Cuando tienes 20 estados en lugar de miles de líneas de texto, aparece la posibilidad de razonar sobre los modos de funcionamiento del agente: aquí está el ciclo «intenté, recibí un error, repetí»; aquí la rama «la tarea derivó en preguntas aclaratorias»; aquí un estado raro del que casi no hay salidas. Después, con esos modos se puede trabajar de forma ingenieril: por ejemplo, construir características que se calculan por cada estado.
Predicción del siguiente paso: el estado importa más que la memoria
Para predecir la siguiente acción del agente, los autores usan el contexto del estado de la FSM. Y este enfoque supera a Agent Workflow Memory en cada dataset donde el etiquetado es coherente con el curso real de la ejecución. En otras palabras, saber «en qué modo se encuentra ahora el agente» resulta más útil que la memoria acumulada de episodios de trabajo anteriores.
Aquí hay un matiz interesante. El contexto del estado no es simplemente el número del nodo, sino una descripción comprimida de lo que ya ocurrió y de lo que probablemente ocurrirá después. Se obtiene una especie de mapa de continuaciones probables, construido no sobre la semántica del texto, sino sobre la estadística de transiciones. Para la práctica, esto significa que el predictor del siguiente paso se puede entrenar más barato: no necesita acceso a los estados ocultos del modelo, le basta con la estructura.
Predicción de fallo y monitorización sobre una traza parcial
La segunda mitad del trabajo trata sobre el diagnóstico. Las características calculadas sobre estados individuales del autómata dan un AUROC de hasta 0.94 sobre datos reservados. Es decir, un modelo que no sabe nada de las interioridades del LLM distingue, por características de comportamiento, las ejecuciones que terminarán en fallo de las que llegarán hasta el final.
Lo más práctico aquí es el monitor en línea. Observa una traza incompleta y clasifica las ejecuciones fallidas por encima de las exitosas, sin esperar al final. Esto basta para activar una parada temprana mucho antes de que el agente se desvíe definitivamente: ahorrar tokens, tiempo y, lo que es más importante, evitar que cause daño. Para agentes que escriben en bases de datos, llaman a API de pago o gestionan infraestructura, esa posibilidad de interrumpir la ejecución a mitad no es un lujo, sino un requisito.
Conclusión principal: el comportamiento lo define el entorno de despliegue, no el modelo
Quizá la tesis más provocadora del artículo suena así: la topología del comportamiento del agente está determinada en gran medida no por el propio modelo de lenguaje, sino por el deployment harness, ese entorno en el que se ejecuta el modelo. La plantilla del prompt, el conjunto de herramientas, las reglas de gestión de errores, los límites de pasos: eso es lo que da forma al grafo de transiciones.
De aquí se siguen varias conclusiones. Primero, sustituir el modelo por otro con el mismo entorno puede no cambiar radicalmente la estructura del comportamiento, y por tanto conviene probar en otro modelo el autómata construido sobre uno. Segundo, mejorar el agente suele ser más eficaz mediante cambios en el harness que mediante una actualización de los pesos. Tercero, aparece una primitiva estructural agnóstica al modelo: el mismo enfoque sirve para auditar la seguridad y para la monitorización en tiempo de ejecución, independientemente de qué API estés llamando.
Qué conviene tener en cuenta
El enfoque no elimina la prudencia. Doce datasets siguen siendo una muestra limitada, y un fitness de 0.997 indica lo bien que el autómata describe trazas ya recogidas, no que vaya a predecir el comportamiento del sistema en un entorno desconocido. El alto AUROC para la predicción de fallo también se obtuvo en tareas concretas: en dominios nuevos habrá que recalcular las características.
Y aun así, la dirección parece sensata. En lugar de aumentar sin fin la ventana de contexto y esperar que el modelo «se aclare por sí solo», se puede construir una vez un modelo compacto del comportamiento de tu entorno y usarlo después como esquema: ver dónde se atasca el agente, qué estados llevan al fallo y qué cambiará si ajustas la configuración. El autómata no es más listo que el LLM, pero es más honesto: cabe entero en la cabeza, y eso ya es la mitad del éxito en la depuración.


