
La elección del codificador no se hace por esa métrica
Un codificador congelado suele incorporarse a un proyecto fijándose en una sola cosa: qué tan bien se entrena una cabeza ligera sobre sus representaciones — una capa lineal, una MLP pequeña, algo por el estilo. Si una cabeza simple extrae la característica deseada, el codificador se considera acertado. Pero esa evaluación responde a la pregunta «¿es cómodo leer algo de estos embeddings?», no a la pregunta «¿la propia geometría del espacio separa la característica?». Son dos preguntas distintas, y confundirlas sale caro: la cabeza enmascara la debilidad de la representación mientras las tareas son simples y hay pocas clases.
Aparte está el problema del balance. Mientras las clases son más o menos iguales, la diferencia entre «el codificador sabe» y «la cabeza lo extrae» casi no se nota. En cuanto una clase se vuelve rara, las métricas basadas en vecinos más cercanos empiezan a mentir sistemáticamente.
Por qué la discordancias por vecinos más cercanos miente
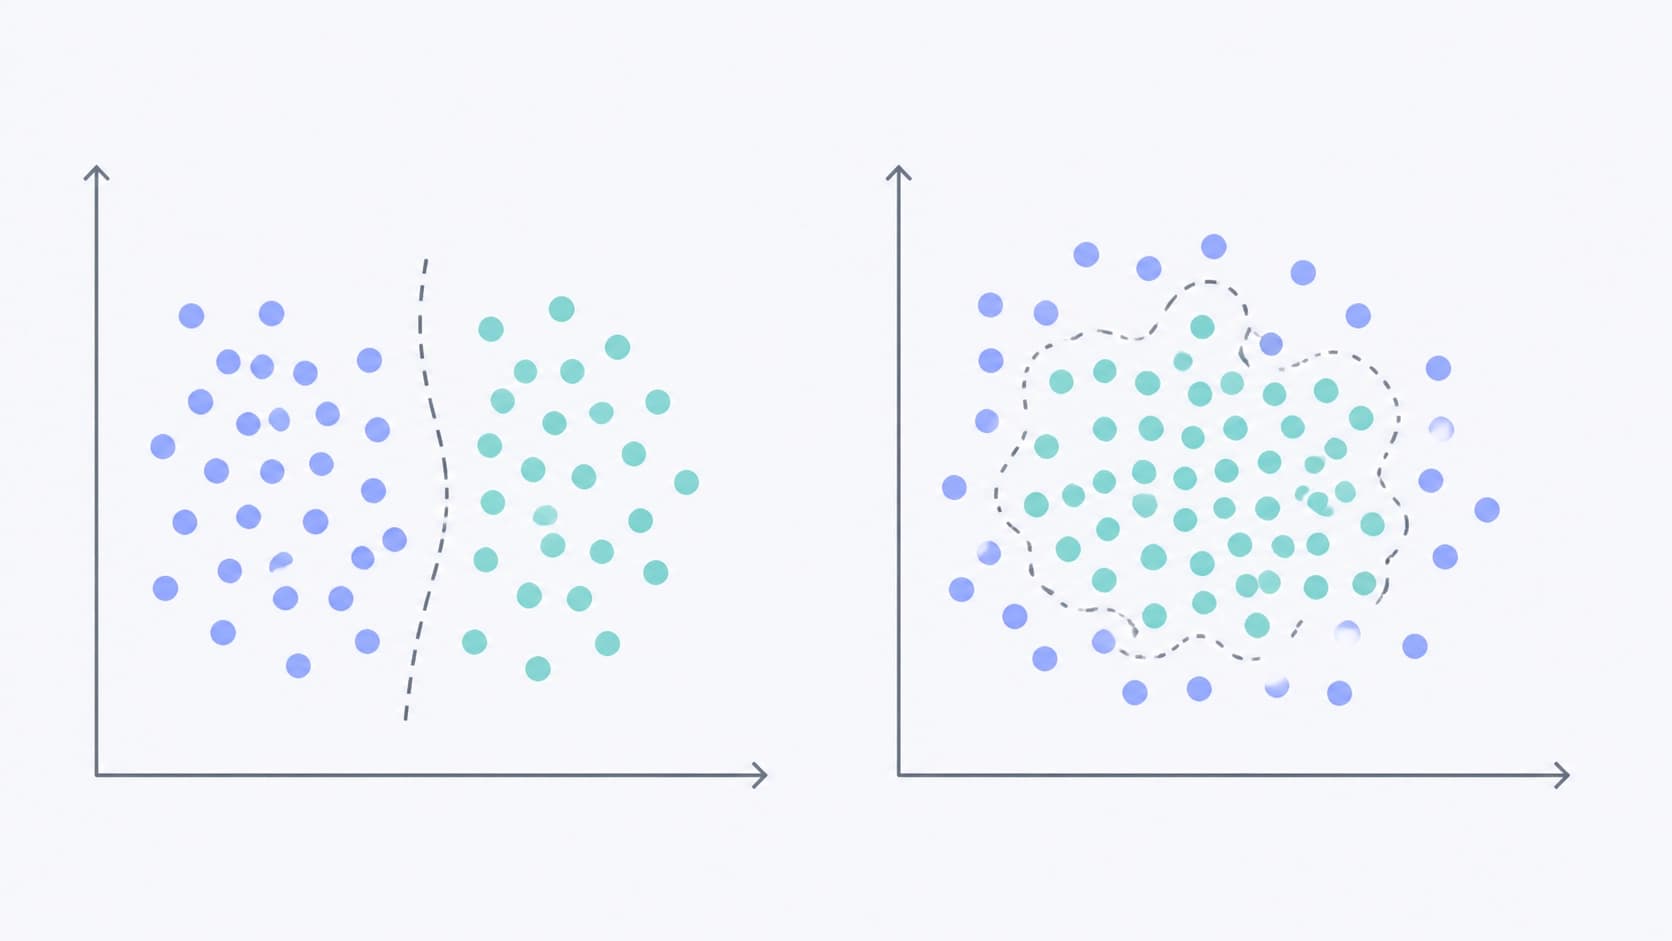
La métrica clásica de discordancias es sencilla: para cada punto se buscan vecinos en el espacio de embeddings, y si el vecino más cercano lleva la etiqueta opuesta, el caso se registra como discordante. Dentro de una misma clase la geometría funciona de maravilla, no hay queja sobre los vecinos.
El problema está en la asimetría del procedimiento. Cuando los vecinos para ejemplos positivos y negativos se toman de conjuntos de distinto tamaño, el vecino más cercano con la etiqueta opuesta gana no porque así esté construida la geometría, sino porque su clase simplemente yace más densa en la vecindad. En otras palabras, en el resultado se filtra la prevalencia de la clase — una estadística del dataset, no una propiedad de la representación. El efecto es desagradable: un codificador completamente desinformado empieza a parecer ciego, aunque en realidad es exactamente tan inútil como una moneda honesta, y no peor.
Qué cambia exactamente CANDOR
CANDOR — Chance-Calibrated Discordance in Frozen Foundation Encoders — redefine el propio procedimiento de conteo. Aquí los bancos de vecinos se arman de igual tamaño, y la construcción de la métrica es simétrica respecto al intercambio de etiquetas: cambie los positivos y negativos de lugar, y el valor no cambia. Como consecuencia, el nivel de acierto aleatorio queda fijado exactamente en un medio — 50%. No «más o menos cerca de la mitad, depende del dataset», sino un punto de referencia estricto en 1/2.
No es una corrección cosmética. Precisamente el punto de referencia flotante impedía comparar codificadores entre sí y entre datasets: donde el desbalance es mayor, el acierto aleatorio parecía peor de lo que es, y el modelo recibía un crédito de confianza inmerecido. Cuando el punto de referencia queda fijado, la comparación se vuelve justa.
Y otro detalle importante para la práctica: como el punto de referencia es fijo, CANDOR se puede calcular antes de entrenar cualquier cabeza. Sin fine-tuning, sin ajuste de hiperparámetros — la métrica describe las propias representaciones y anticipa qué hallazgos concretos soporta mal un codificador congelado dado.
Verificación a escala
Los autores corrieron la evaluación a lo ancho: 22 codificadores, 20 datasets de 7 dominios temáticos, en total 605 443 imágenes. Esa amplitud era necesaria justamente para separar el efecto de la métrica de las particularidades de una sola tarea.
El resultado da vuelta la conclusión a la que llevaba el procedimiento antiguo. Tras la corrección, el colapso de representaciones resulta estar por debajo del nivel de acierto aleatorio casi en todas partes. Se lee así: ninguno de los codificadores evaluados es ciego — hay información sobre la característica en las representaciones —, pero todos son débiles. La formulación «todos son débiles, ninguno es ciego» suena más suave que la anterior, y a la vez describe la realidad con mucha más precisión.
Ejemplo clínico: cabeza fuerte con geometría débil
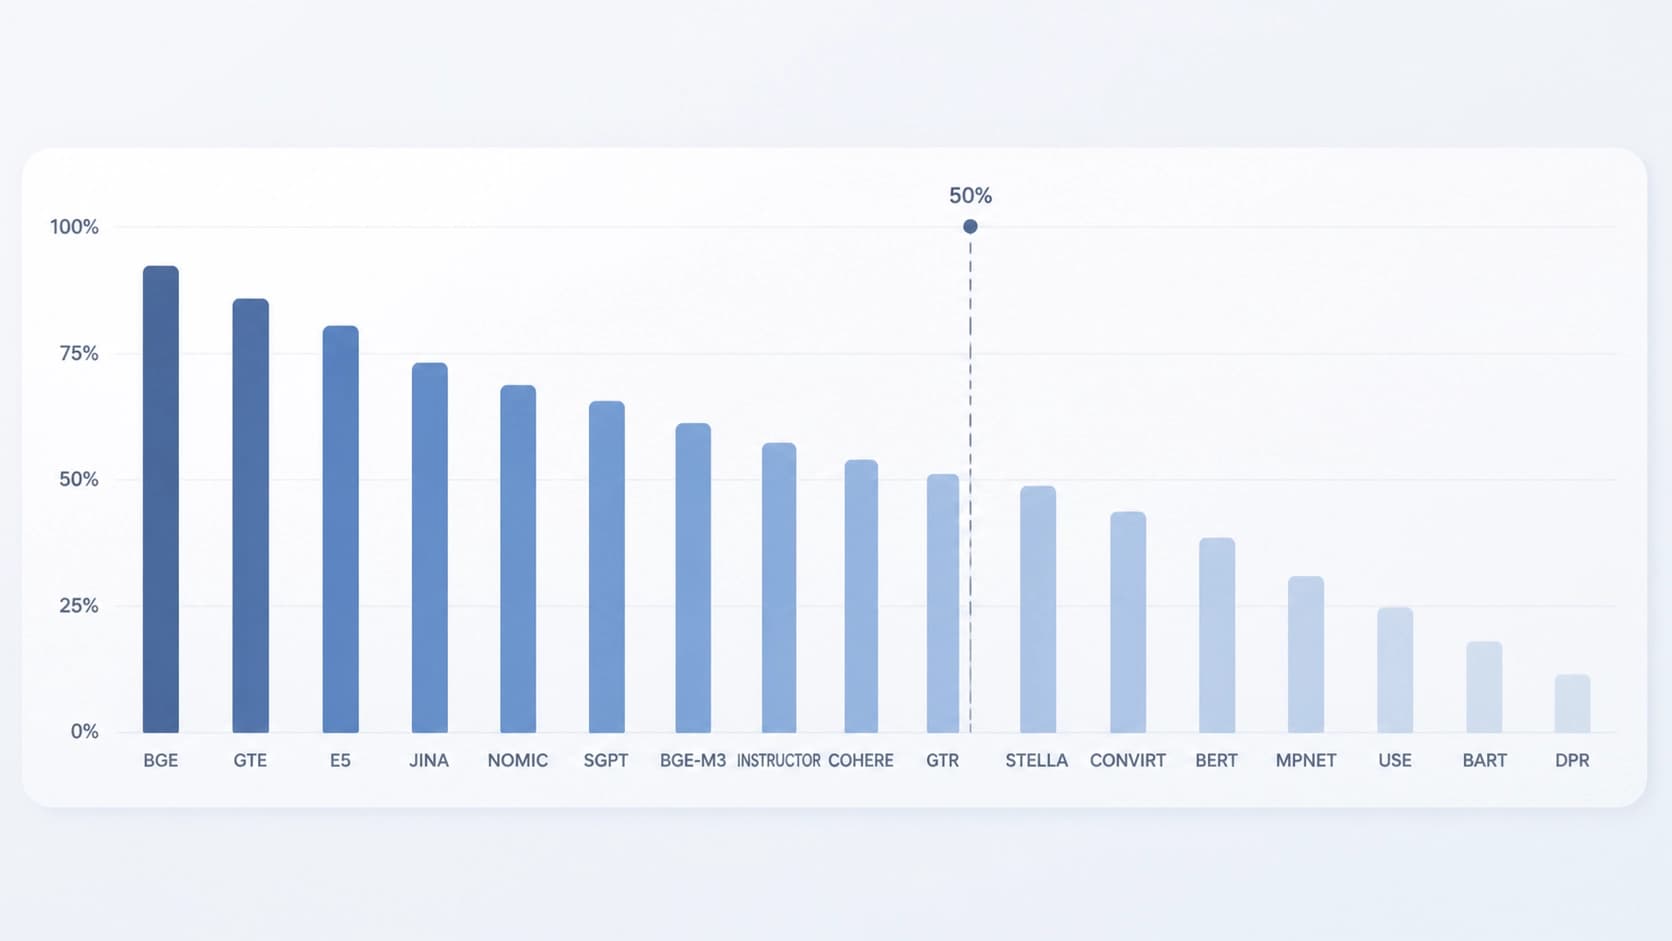
La ilustración más clara es la imagenología médica. El mejor modelo para tórax lee el neumotórax con un AUROC de 84,5. La cifra es sólida, y normalmente es lo que se mira al elegir un modelo. Pero ese mismo modelo coloca el 18,4% de los casos positivos más cerca de una imagen con la etiqueta opuesta que de su propia imagen con el mismo hallazgo — dentro del mismo hospital, es decir, sin un cambio de dominio como explicación.
La brecha entre «la cabeza resuelve bien la tarea» y «la geometría confunde positivos y negativos» es justamente esa discrepancia. La cabeza compensa una representación débil; la métrica CANDOR muestra que hay que compensar mucho.
Sigue la comparación entre dominios. Un mismo codificador distingue especies de aves a un nivel de 4,5 (es decir, casi perfecto), mientras que deja los hallazgos de tórax en 42,8 y el glaucoma en 49,8. Este último número está al nivel del acierto aleatorio y, en esencia, es peor que pesos aleatorios. Un codificador, un entrenamiento, tres calidades de geometría completamente distintas.
Déficit de selección, no de información
De esto surge una pregunta natural: ¿entonces las representaciones son un caso perdido? No exactamente. El azar limita el margen normalizado (normalized margin) de cualquier cabeza lipschitziana — es decir, una cabeza con sensibilidad acotada al desplazamiento de la entrada. Sin embargo, dentro de un conjunto de once cabezas hay una que acierta en todos los casos salvo el 2,8%, mientras que una cabeza tomada por separado falla en el 35,9%. La información sobre la característica está en la representación — simplemente no es igualmente accesible para distintos dispositivos de lectura. Por lo tanto, el déficit está relacionado con la selección (selection), no con la ausencia de información.
Una asociación interesante apareció también en otro lugar: la retención ante el borrado (erasure retention) está relacionada con el colapso. En cambio, con el objetivo de entrenamiento, la escala del modelo, la antigüedad del lanzamiento o el tamaño del hallazgo no se encontró relación. En pocas palabras, «tomar un modelo más grande y más reciente» no resuelve el problema — no se trata de tamaño ni de antigüedad.
Qué se desprende de esto en la práctica
Tres conclusiones prácticas.
- Calcule CANDOR antes de entrenar la cabeza. Es una verificación barata que muestra si el codificador soporta un hallazgo raro concreto, y permite descartar un backbone inadecuado antes de que pierda tiempo ajustándolo.
- No confunda el AUROC de la cabeza con la calidad de la representación. 84,5 con un 18,4% de positivos discordantes es una situación normal, no rara, y merece medirse por separado.
- No espere que la escala y la novedad lo arreglen todo. No se encontraron asociaciones con el tamaño, el objetivo de entrenamiento ni la antigüedad; la debilidad de los codificadores congelados parece sistémica.
El principal valor de esta historia no está ni siquiera en la métrica en sí, sino en la conclusión invertida. Antes parecía que los codificadores eran «ciegos» a ciertas clases. Tras la calibración por azar se ve otra cosa: ven casi en todas partes, pero en todas partes ven débil. Es un panorama mucho menos dramático y mucho más útil — con él queda claro qué reparar y en qué orden.


