
সমস্যা: পরীক্ষা কম, আর তাদের পুরস্কারটাই সব
যাচাইযোগ্য পুরস্কারভিত্তিক রিইনফোর্সমেন্ট লার্নিং (RLVR) কোড জেনারেশনে ভাষার মডেলগুলোকে গ্রহণযোগ্য মানে পৌঁছে দেওয়ার প্রধান উপায় হয়ে দাঁড়িয়েছে। পদ্ধতিটা সহজ: মডেল একটা সমাধান লেখে, একটা বিশেষ যাচাই প্রক্রিয়া সেটাকে পরীক্ষার মধ্য দিয়ে চালায়, আর ফলাফল অনুযায়ী মডেল পুরস্কার পায়। সবকিছু দাঁড়িয়ে আছে একটাই অনুমানের ওপর — পরীক্ষাগুলো সত্যিই পুরো সমস্যাটাকে বর্ণনা করে।
বাস্তবে এই অনুমান প্রায় সবসময়ই ভঙ্গ হয়। পরীক্ষার কেসের সেট সংকীর্ণ, কভারেজ ছিদ্রময়, আর মডেল বেশ দ্রুতই সমস্যাটা নয়, বরং একটা ফাঁকফোকর খুঁজে বের করে: একই ধরনের সমস্যার শ্রেণি সমাধান করতে শেখার বদলে কোডটাকে নির্দিষ্ট কিছু যাচাইয়ের সাথে খাপ খাইয়ে দেয়। এরপর চালু হয় চেনা সর্পিল — reward hacking, তার পিছনে নীতি বা পলিসির অবক্ষয়। সংকীর্ণ চালাকিতে মডেল যতটা এগোয়, সাধারণ দক্ষতায় ঠিক ততটাই পিছিয়ে পড়ে।
মোটা দাগে একটা উপমা: দুটো প্রশ্নের পরীক্ষা। যে শিক্ষার্থী এই দুটো প্রশ্নের উত্তর মুখস্থ করেছে সে ফাইভ পায়, কিন্তু বিষয়টা জানে না। আর এভাবে যত দীর্ঘ প্রশিক্ষণ চলে, বাকি সবকিছুতে সে তত খারাপ হতে থাকে।
RobustTests-এর ধারণা: ভুলকে পরীক্ষা তৈরির জেনারেটর বানানো
সাধারণত সমস্যার শর্ত থেকে ভাবনা শুরু করে পরীক্ষা বানানো হয়: কী কী ইনপুট হতে পারে, রেঞ্জের প্রান্ত কোথায়, খালি ইনপুটে কী হবে। যুক্তিসঙ্গত, কিন্তু ঠিক এই পথেই সংকীর্ণ কভারেজ আসে — পরীক্ষা লেখক আর সমাধান লেখক একই দিক থেকে সমস্যাটার দিকে তাকান, আর একই জায়গাগুলোর প্রতি সমানভাবে অন্ধ থাকেন।
RobustTests প্রক্রিয়াটা উল্টে দেয়। ফ্রেমওয়ার্কের ভিত্তি হলো ত্রুটিপূর্ণ কোড-চালিত পরীক্ষা কেস সংশ্লেষণ (faulty-code-driven test case synthesis)। এখানে কথা এলোমেলো ভাঙা কোডের নয়, বরং «প্রায় সঠিক» সমাধানের: যেগুলো যুক্তির সামান্য পরিবর্তনে সঠিকটার থেকে আলাদা — উল্টে যাওয়া তুলনা চিহ্ন, ভুল লুপ সীমা, বাদ পড়া শাখা। এমন প্রতিটি সমাধান প্রায় কাজ করে, আর ঠিক সেজন্যই সেটা মূল্যবান।
এরপর এমন একটা ইনপুট খোঁজা হয়, যেখানে প্রায় সঠিক কোডটা আদর্শ কোডের থেকে আলাদা হয়ে যায়। পাওয়া ইনপুটটাই হয়ে ওঠে পরীক্ষা। এমন পরীক্ষার আছে উচ্চ ডায়াগনস্টিক শক্তি: এটা শুধু «কিছু একটা যাচাই করে» না, বরং দুটো কাছাকাছি আচরণের মধ্যে পার্থক্য করে — যেটা আমরা মডেলের কাছ থেকে চাই, আর যেটা বিশ্বাসযোগ্য দেখায় কিন্তু ভুল।
কাজটা arXiv:2608.24135 প্রিপ্রিন্টে বর্ণিত (Yiwen Zhang এবং আরও আটজন লেখক, তাঁদের মধ্যে Xiaodong Yan, Zhenyu Huang, Deng Zhao ও অন্যান্য; v1 — ২৫ আগস্ট ২০২৬, v2 — ২৭ আগস্ট ২০২৬, DOI 10.48550/arXiv.2608.24135, EMNLP 2026-এ গৃহীত)। লেখকেরা উপাদানটাকে একসাথে দুটো বিভাগে রাখেন — cs.AI এবং cs.SE, যা যুক্তিসঙ্গত: এটা মডেল প্রশিক্ষণ এবং পরীক্ষণ প্রকৌশল — দুটোই নিয়ে।
ফিল্টারিং: ভ্যালিডেটর এজেন্ট আর ক্লাস্টারিং
যেকোনো স্বয়ংক্রিয় পরীক্ষা সংশ্লেষণ সহজেই আবর্জনা জেনারেটরে পরিণত হতে পারে। ভাবা ইনপুটের কিছুটা অবৈধ হবে, কিছুটা একে অন্যের নকল হবে, কিছুটা ভিন্ন কোণ থেকে একই আচরণ যাচাই করবে। এমন সেট থেকে দরকারি সংকেত কম, শব্দ বেশি।
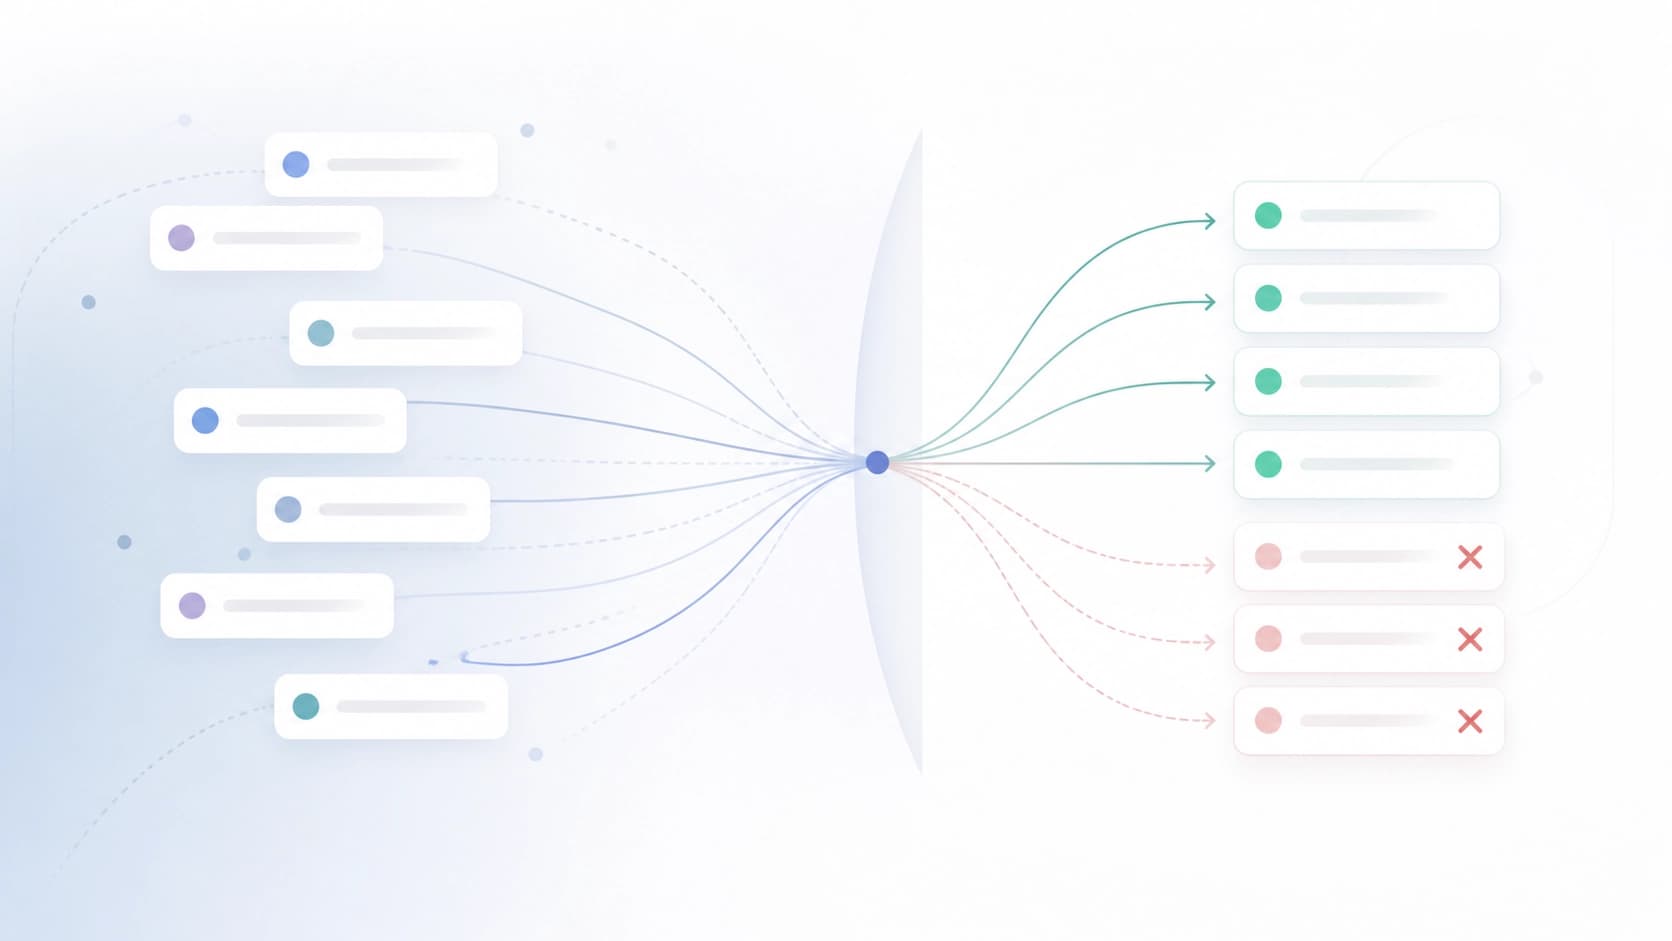
তাই পাইপলাইনে রাখা হয়েছে দ্বিতীয় স্তর — ভ্যালিডেটর এজেন্ট, যারা ভুল ও অপ্রয়োজনীয় পরীক্ষা কেস ছেঁটে ফেলে। এর সাথে যোগ করা হয়েছে আচরণগত বৈশিষ্ট্য অনুযায়ী ক্লাস্টারিং: পরীক্ষাগুলো কোডের কোন আচরণে পার্থক্য করে সেই অনুযায়ী দলবদ্ধ হয়, আর দলের ভেতরের নকলগুলো চুপসে যায়। শেষে থাকে একটা সংক্ষিপ্ত সেট, যেখানে প্রতিটি উপাদান নতুন তথ্য যোগ করে, প্রতিবেশীর পুনরাবৃত্তি করে না।
বিরল সংকেতের বদলে ঘন পুরস্কার
ফ্রেমওয়ার্কের দ্বিতীয় উপাদানটা পরীক্ষা নিয়ে নয়, বরং সেগুলো থেকে পুরস্কার কীভাবে হিসাব হয় সেটা নিয়ে। চিরাচরিত বাইনারি পদ্ধতি — «সব পাস করেছে বা কিছুই পাস করেনি» — ভালো কাজ করে না যখন পরীক্ষা অনেক হয়ে যায় আর সেগুলো ভিন্ন কঠিনতার হয়: মডেল প্রায় সবটাই সমাধান করে, একটা প্রান্তিক কেসে হোঁচট খায়, আর পুরোপুরি ভাঙা সমাধানের মতোই শূন্য পায়। শেখার সংকেত কেটে যায়, আর সেটা থেকে শেখার মতো প্রায় কিছুই থাকে না।
RobustTests চালু করে ধাপে ধাপে ঘন পুরস্কার ফাংশন (stepwise dense reward), যা পাস হওয়া যাচাইয়ের অনুপাতের — pass rate — ওপর নির্ভর করে। মডেল আংশিক সংকেত পায় আর গতির দিকটা বোঝে: «ব্যর্থতা» নয়, বরং «ত্রিশটার মধ্যে দুটো পরীক্ষা বাকি»। এটা একসাথে দুটো সমস্যার সমাধান করে। প্রথমত, মিথ্যা নেতিবাচক সক্রিয়তার (false negatives) সংখ্যা কমায়, যখন অতিরিক্ত কঠোর বা কেবল ভুল একটা পরীক্ষার কারণে সঠিক সমাধান বাতিল হয়ে যায়। দ্বিতীয়ত, প্রশিক্ষণকে আরও স্থিতিশীল করে: পুরস্কার আর বিরল ঘটনা থাকে না, একটা স্কেলে পরিণত হয়।
এই দুটো ধারণার জোড়াটা আলাদাভাবে জোর দেওয়া দরকার। ঘন পুরস্কার তখনই অর্থবহ যখন পরীক্ষাগুলো সত্যিই ভিন্ন ধরনের ভুলের পার্থক্য করে — নাহলে আপনি কেবল শব্দের গড় করছেন। আর প্রায় সঠিক সমাধান থেকে পরীক্ষা সংশ্লেষণ, ঘন পুরস্কার ছাড়া, একই সংকেত-বিচ্ছিন্নতা রেখে দেবে। উপাদানগুলো জোড়ায় কাজ করে।
ডেটাসেট ও ফলাফল
এই পাইপলাইনে লেখকেরা CodeContests+ ডেটাসেটের একটা সম্প্রসারিত সংস্করণ তৈরি করেছেন — উল্লেখযোগ্যভাবে বেশি ডায়াগনস্টিক উপযোগিতা নিয়ে: পরীক্ষার সেটগুলো আরও নিখুঁতভাবে দেখাতে পারে মডেল সমাধানের ঠিক কোন ধাপে ভুল করছে।
মূল পরিমাপ ডেটাসেটের আকার নয়, বরং ফাইন-টিউনিংয়ের পর মডেলের আচরণ। RobustTests ব্যবহার করে Qwen3-32B-এর RL প্রশিক্ষণ LiveCodeBench-এ ৩% পরম বৃদ্ধি দেয়। কোড ও ডেটা লেখকেরা উন্মুক্তভাবে প্রকাশ করেছেন।
এখানে সংযম রাখা দরকার। একটা মডেল ফাইন-টিউন করে একটা বেঞ্চমার্কে তিন শতাংশ পয়েন্ট — এটা ক্ষেত্রে কোনো বিপ্লব নয়, বরং স্পষ্ট প্রক্রিয়াসহ একটা সযত্ন উন্নতি। কাজটার মূল্য বরং পদ্ধতিতত্ত্বে: এটা একটা পুনরুৎপাদনযোগ্য রেসিপি দেয়, কীভাবে হাতে পরীক্ষার সংখ্যা না বাড়িয়েই সেগুলো থেকে বেশি সংকেত বের করা যায়। সীমাবদ্ধতাও স্পষ্ট — ফলাফলটা অন্য মডেল, ভাষা ও সমস্যার ধরনে সরানোর বিষয়টা এখনো যাচাই করা বাকি।
এর থেকে কী নিজের অভ্যাসে নেওয়া যায়
এমনকি যদি আপনি RL পাইপলাইন না বানান আর কেবল কোড জেনারেশনের গুণমান মূল্যায়ন করেন, তবু যুক্তিটা প্রায় অপরিবর্তিতভাবে প্রযোজ্য:
- শর্ত থেকে নয়, ভুল থেকে পরীক্ষা লিখুন। এমন একটা সমাধান নিন যা প্রায় কাজ করে, আর খুঁজুন কোন ইনপুটে সেটা ভাঙে। এমন পরীক্ষা প্রায় সবসময়ই সোজাসুজি ভাবা দশটা পরীক্ষার চেয়ে বেশি তথ্যবহ।
- পাস করার ঘটনা নয়, পাস হওয়া যাচাইয়ের অনুপাত গুনুন। আংশিক স্কোর প্রশিক্ষণে এবং গুণমান বিশ্লেষণে — দুটোতেই গ্রেডিয়েন্ট দেয়: ধরা পড়ে মডেল ঠিক কোথায় ব্যর্থ হচ্ছে।
- সংশ্লেষিত পরীক্ষা ফিল্টার করুন। যাচাই ও ডুপ্লিকেট অপসারণ ছাড়া স্বয়ংক্রিয়ভাবে তৈরি সেট দ্রুত একে অন্যের মতো যাচাইয়ের স্তূপে পরিণত হয়।
- পুরস্কার আসলে কী উৎসাহ দিচ্ছে সেদিকে খেয়াল রাখুন। ঘন স্কেল ফাঁকি দেওয়ার প্রবণতা কমায়, কিন্তু মুছে দেয় না: পরীক্ষা যদি আচরণের পার্থক্য না করে, যেকোনো পুরস্কারই দেরি-আগে হ্যাক হবে।
RobustTests যে ধারণাটা বহন করে সেটা মানুষের ভাষায় সহজ: কঠিন পরীক্ষার সেরা উৎস লেখকের কল্পনা নয়, বরং সিস্টেমের নিজের প্রায়-ভুলগুলো। মডেল যা প্রায় ঠিক করতে যাচ্ছিল, সেটাই সবচেয়ে সৎ সূচক — «সমাধানের মতো দেখতে» আর «সমাধান»-এর সীমারেখা কোথায়।


