
কনফিডেন্স ভোটিং কেন আদৌ কাজ করেছিল
বড় ভাষা মডেলকে ঘিরে পাইপলাইন তৈরি করেছেন যারা, তাদের সবার পরিচিত ধারণাটি সহজ: একই কাজ সমান্তরালে কয়েকবার চালান, তারপর সংখ্যাগরিষ্ঠতার ভিত্তিতে উত্তর বেছে নিন। তবে "সমতল" সংখ্যাগরিষ্ঠতা নয়, ওজনযুক্ত — প্রতিটি রান মডেলের অভ্যন্তরীণ সংকেতের ভিত্তিতে ওজন পায়, বেশিরভাগ ক্ষেত্রে টোকেনের লগ-সম্ভাবনার ভিত্তিতে। যে রানে মডেল বেশি আত্মবিশ্বাসী ছিল, সেটিই বাকিদের চেয়ে জোরে শোনায়।
একধাপি যুক্তির জন্য এই পদ্ধতি বেশ ভালো কাজ করে: মডেল ভুল করলে সাধারণত দ্বিধা করে, আর সঠিক উত্তর উচ্চ আত্মবিশ্বাসের সঙ্গে আসে। লগ-সম্ভাবনার ব্যবধান একধরনের অন্তর্নির্মিত ত্রুটি-শনাক্তকারীতে পরিণত হয়, যার জন্য অতিরিক্ত কল, লেবেল বা আলাদা বিচারক-মডেলের দরকার পড়ে না।
যেখানে শুরু হয়েছিল, সেখানেই ভেঙে পড়ে: বহু-ধাপি অনুসন্ধানে
সমস্যা হলো, আধুনিক এজেন্টরা ভিন্নভাবে গঠিত। তারা কেবল এক পাসে যুক্তি করে না: তারা কোয়েরি তৈরি করে, বাইরের ডকুমেন্ট আনে, সেগুলো কনটেক্সটে ঢোকায়, কোয়েরি সূক্ষ্ম করে — এভাবে কয়েকবার, যতক্ষণ না চূড়ান্ত উত্তরের জন্য যথেষ্ট উপাদান জড়ো হয়। প্রতিটি ধাপ মডেলের উইন্ডোতে অন্যের লেখার টুকরো যোগ করে।
«Beyond Confidence: Test-Time Scaling for Multi-Turn Search Agents via Retrieval Grounding» (arXiv:2608.24024, EMNLP 2026 সম্মেলনের Findings-এ গৃহীত) গবেষণাপত্রের লেখকরা — Hyunho Kook, Junhyuk So, Tianyu Fu, Haizhong Zheng এবং Beidi Chen — এই পরিস্থিতিতে কনফিডেন্স ভোটিংয়ের কী হয় তা যাচাই করেছেন। ফলাফল অস্বস্তিকর: একধাপি কাজে নিখুঁতভাবে টিউন করা কৌশল অনুসন্ধান এজেন্টে ভালোভাবে স্থানান্তরিত হয় না।
ব্যর্থতার কার্যপ্রণালী: copy inflation
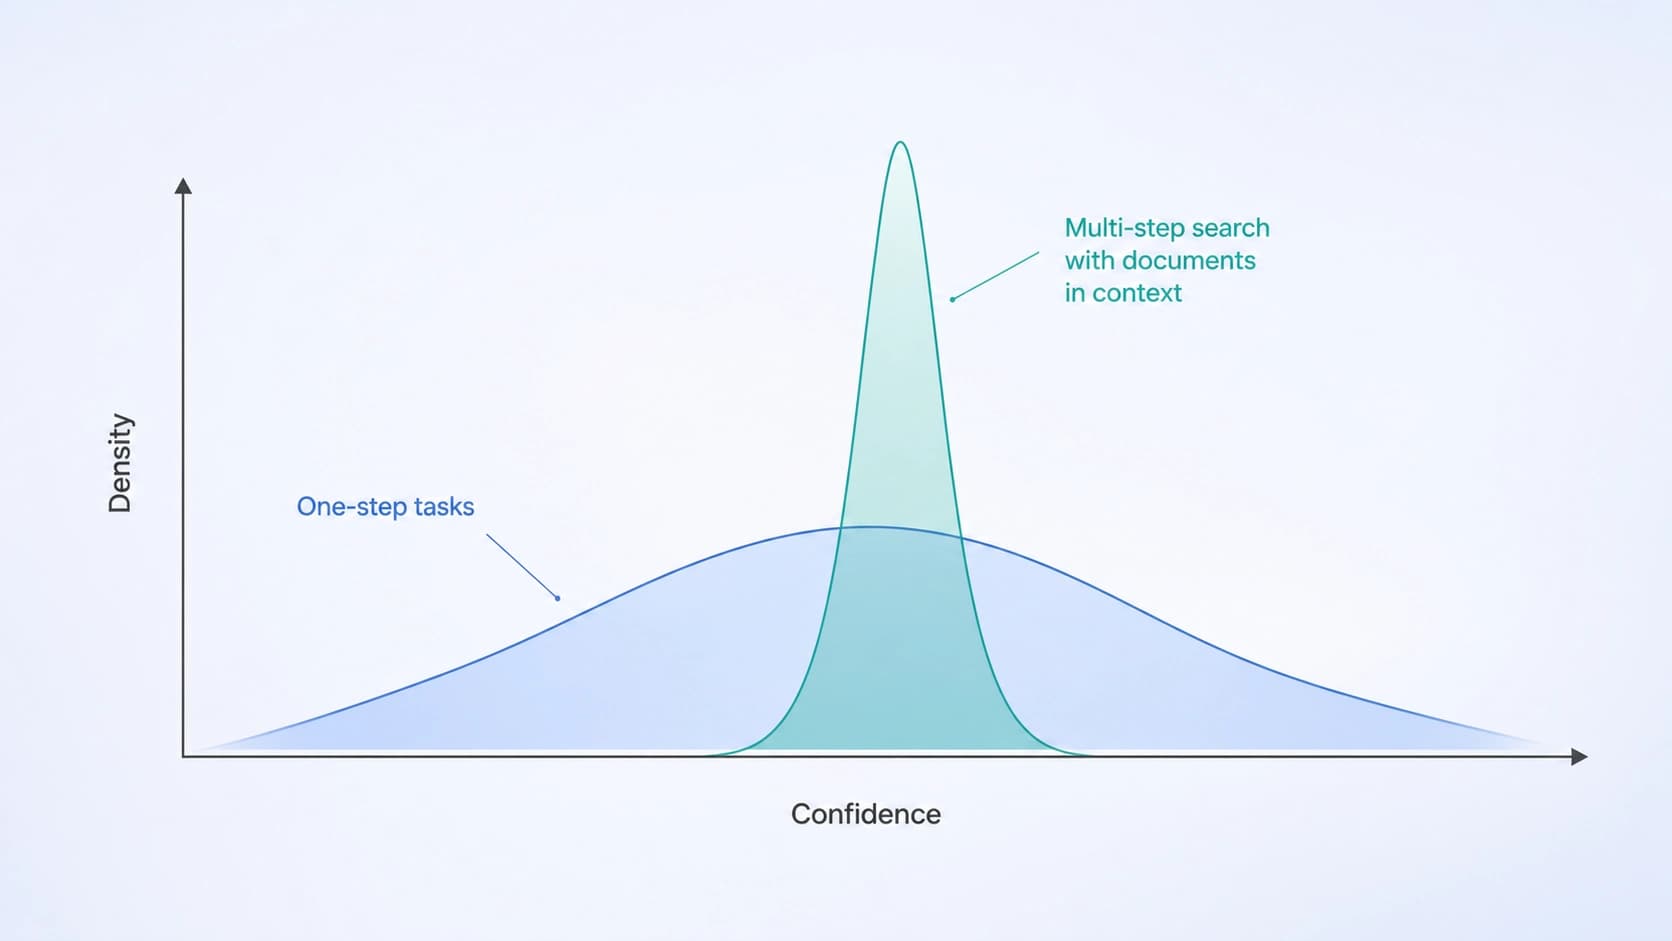
কারণটির নাম গবেষকরা দিয়েছেন copy inflation — "কপি-ফুলে ওঠা"। যখন উদ্ধার করা ডকুমেন্ট কনটেক্সটে ঢোকে, তখন মডেল যে টোকেনগুলো ওই ডকুমেন্ট থেকে নিজের উত্তরে নিয়ে আসে, সেগুলো পদ্ধতিগতভাবে অতিরিক্ত উচ্চ লগ-সম্ভাবনা পায়। কপি করা একটি সহজ কাজ: চোখের সামনে পড়ে থাকা লেখা চালিয়ে যাওয়া পরিসংখ্যানগতভাবে নিজের কিছু তৈরি করার চেয়ে সহজ। মডেল এমন টোকেনে "আত্মবিশ্বাসী" থাকে এই কারণে নয় যে সেটি সঠিক, বরং এই কারণে যে সেটি আক্ষরিকভাবে নকল করা।
এরপর প্রভাব জমতে থাকে। যেহেতু সব রান কোনো না কোনোভাবে পাওয়া ডকুমেন্টের উপর নির্ভর করে, সবাই ফুলে ওঠা সম্ভাবনার নিজস্ব ভাগ পায়। একই প্রশ্নের ভেতরে আত্মবিশ্বাসের স্কোরগুলো সমান হয়ে যায়, সংকীর্ণ পরিসরে সংকুচিত হয় — আর ওজনযুক্ত ভোটিং তার অস্তিত্বের মূল উদ্দেশ্যটি হারায়: শক্তিশালী রানকে দুর্বল রান থেকে আলাদা করার ক্ষমতা। ওজনগুলো প্রায় একই রকম হয়ে যায়, আর সমষ্টিকরণ সাধারণ সংখ্যাগরিষ্ঠতায় পরিণত হয়, শুধু বাড়তি গণনার বোঝা নিয়ে।
যা প্রস্তাব করা হচ্ছে: Retrieval-Grounded Voting
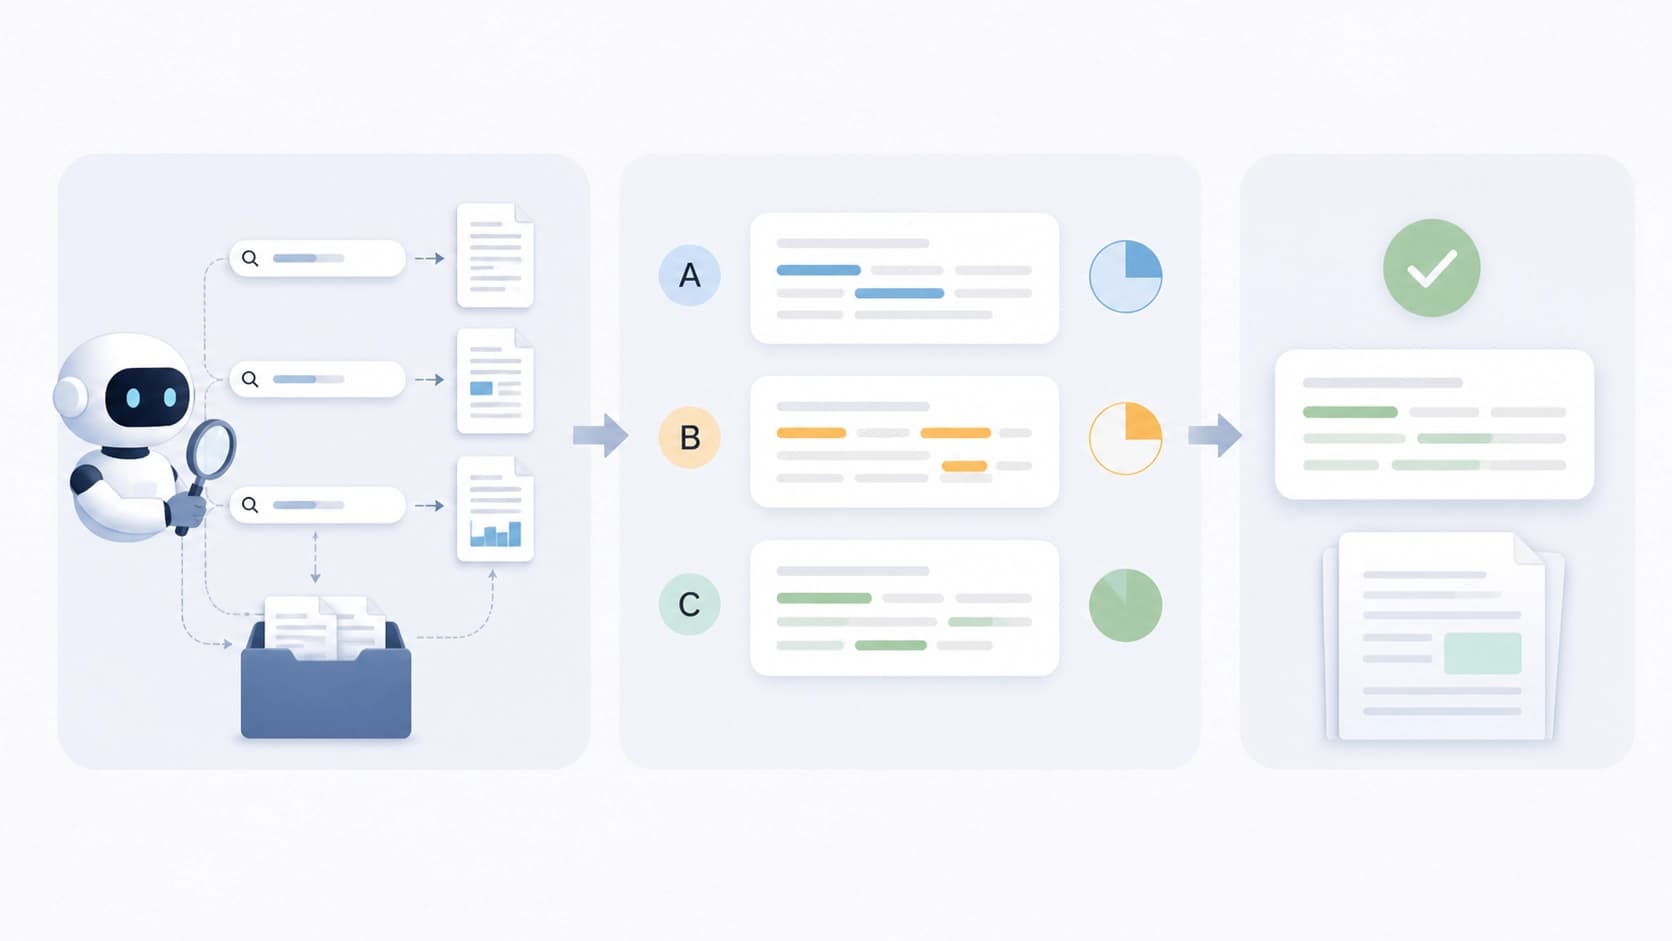
বিকল্প হিসেবে লেখকরা প্রস্তাব করেন Retrieval-Grounded Voting (RGV) পদ্ধতি। এটিও প্রতিটি রান আলাদাভাবে মূল্যায়ন করে, তবে মডেলের ভেতরে নয়, বাইরে তাকায় — চূড়ান্ত উত্তর আর সেই রান নিজেই যে ডকুমেন্টগুলো এনেছে, তাদের মধ্যে সম্পর্কের দিকে।
মেট্রিকটি ইচ্ছাকৃতভাবে সহজ: উত্তরের টেক্সট আর উদ্ধার করা সূত্রের টেক্সটের মধ্যে আভিধানিক ছেদ। উত্তরটি পাওয়া উপাদানের উপর যত বেশি নির্ভর করে, তার স্কোর তত বেশি। যে রান নিজে থেকে কিছু বানিয়ে ফেলেছে বা পথভ্রষ্ট হয়েছে, সেটি তার ডকুমেন্টের সঙ্গে কম শব্দ ভাগ করে এবং কম ওজন পায়।
সংকেতটি কেন কাজ করে
এখানে যুক্তিটি এইরকম: এজেন্ট যদি সত্যিই প্রাসঙ্গিক পৃষ্ঠা খুঁজে পায় এবং সেগুলোর উপর সিদ্ধান্ত গড়ে, তবে উত্তরের ভাষা অনিবার্যভাবে সূত্রের ভাষার সঙ্গে মিলে যাবে — পরিভাষা, নাম, বাক্যবন্ধ। এটি নির্ভুলতার নিখুঁত লক্ষণ নয়, তবে যেখানে লগ-সম্ভাবনা ইতিমধ্যেই নষ্ট, সেখানে এটি টেকসই।
RGV-এর মূল সুবিধা — এটি সংকেত গণনা করে দূষিত কনটেক্সটের বাইরে। মূল্যায়ন গড়ে ওঠে "উত্তর — ডকুমেন্ট" জোড়ার উপর, জেনারেশনের মুহূর্তে মডেলের অবস্থার উপর নয়, তাই copy inflation এটিকে প্রভাবিত করে না। একইসঙ্গে পদ্ধতিটির টোকেনের লগ-সম্ভাবনায় প্রবেশাধিকার বা LLM-এ অতিরিক্ত অনুরোধের দরকার নেই: কোনো বিচারক-মডেল নেই, দ্বিতীয় পাস নেই, শুধু ছেদ গণনা — একটি কাজ যা সাধারণ কোড দিয়ে প্রায় বিনামূল্যে করা যায়।
ফলাফল
পরীক্ষাগুলো চালানো হয়েছিল অনুসন্ধান এজেন্টের জন্য চারটি বেঞ্চমার্ক এবং পাঁচটি ভিন্ন ভাষা মডেলে। চিত্রটি পুনরাবৃত্ত হয়: RGV ধারাবাহিকভাবে কনফিডেন্স ভোটিংকে ছাড়িয়ে যায়।
সবচেয়ে তাৎপর্যপূর্ণ পরিমাপ — "minority-correct" প্রশ্নে, যেখানে আটটি রানের মধ্যে মাত্র এক-দুইটিতে সঠিক উত্তর আসে। এখানেই আত্মবিশ্বাসের ভিত্তিতে ওজন নির্ধারণ সবচেয়ে বেশি ব্যর্থ হয়: ফুলে ওঠা সম্ভাবনা ভোটিংকে সংখ্যাগরিষ্ঠ কিন্তু ভুল সংস্করণের দিকে টেনে নেয়। এমন প্রশ্নে RGV থেকে লাভ +35% পর্যন্ত পৌঁছায়, আর সামগ্রিক নির্ভুলতায় — +5.4% পর্যন্ত।
সংখ্যাগুলো একটি শর্তসাপেক্ষে পড়া উচিত: এটি "যেকোনো অনুসন্ধান সিস্টেমের গুণমানে প্লাস পাঁচ শতাংশ" নয়, বরং নির্দিষ্ট মডেল ও রানের সেটে সমষ্টিকরণ পদ্ধতির উন্নতি। অর্থাৎ পদ্ধতিটি এজেন্টের নিজের মধ্যে কিছুই বদলায় না — এটি কেবল এজেন্ট ইতিমধ্যে যা তৈরি করেছে, তা থেকে আরও সতর্কভাবে বেছে নেয়।
বাস্তবে এর অর্থ কী
আপনি যদি বহু-ধাপি এজেন্ট তৈরি করেন এবং ইতিমধ্যে self-consistency বা সম্ভাবনার ভিত্তিতে যেকোনো ভোটিং ব্যবহার করেন, তবে RGV-এর তিনটি ব্যবহারিক সুবিধা আছে:
- ইনফারেন্সে কিছুই খরচ হয় না। মডেলের অতিরিক্ত কল দরকার নেই, ওজন হিসাব হয় ঘটনার পরে, ইতিমধ্যে তৈরি উত্তর ও ডকুমেন্টের ভিত্তিতে।
- বন্ধ মডেলের সঙ্গেও কাজ করে। টোকেনের লগ-সম্ভাবনা সবসময় পাওয়া যায় না, কখনো API-র পিছনে লুকানো থাকে। টেক্সট তুলনা এই সীমাবদ্ধতা থেকে মুক্ত।
- পূর্বানুমেয়ভাবে ডিবাগ করা যায়। মেট্রিকটি স্বচ্ছ: কোন শব্দগুলো মিল এনেছে তা দেখা যায়, আর বোঝা যায় কেন একটি রান এমন ওজন পেল।
পদ্ধতিটি কোথায় হোঁচট খেতে পারে
দুর্বল দিকটি গঠন থেকেই স্পষ্ট: আভিধানিক ছেদ শব্দের মিলকে পুরস্কৃত করে, অর্থের মিলকে নয়। পুনর্বাক্যে লেখা কিন্তু সঠিক উত্তর অন্যায্যভাবে কম ওজন পাবে; সংখ্যাগত ফলাফল বা সংক্ষিপ্ত সারমর্মও মূল টেক্সটের সঙ্গে প্রায় মিলবে না, এমনকি সম্পূর্ণভাবে তার সঙ্গে সঙ্গতিপূর্ণ হলেও। উল্টো পরিস্থিতি আরও অস্বস্তিকর: যে রান কেবল পাওয়া লেখা দীর্ঘভাবে উদ্ধৃত করে, সেটি সমাধানে কিছু না যোগ করেও উচ্চ স্কোর পাবে।
তাই যুক্তিসঙ্গত কৌশল হলো — RGV-কে সব সংকেতের বিকল্প নয়, বরং একটি অতিরিক্ত ভোট হিসেবে দেখা, যা ঠিক সেখানেই বিশেষভাবে উপকারী যেখানে মডেলের আত্মবিশ্বাস আর কোনো অর্থ রাখে না। এটিকে অন্য ধরনের যাচাইয়ের সঙ্গে মেলানোও যুক্তিসঙ্গত: অর্থের তুলনা, আলাদা মডেল দিয়ে মূল্যায়ন, তথ্যের ভিত্তিতে যাচাই। লেখকরা, কাজের প্রণয়ন দেখে মনে হয়, ঠিক এই দিকেই এগিয়েছেন — "মডেলের অভ্যন্তরীণ অনুভূতিতে ভরসা করা" থেকে "সে সত্যিই যা করেছে তা মূল্যায়ন করা"-র দিকে।
সারসংক্ষেপ
copy inflation-এর গল্পটি এজেন্ট পাইপলাইনের একটি সাধারণ সমস্যার ভালো দৃষ্টান্ত: একটি মডেল, যুক্তির একটি ধাপ — এই বিচ্ছিন্ন পরিবেশে নিখুঁতভাবে টিউন করা কৌশলগুলো নীরবে ভেঙে পড়ে, যখন চক্রে অনুসন্ধান, কনটেক্সট আর অন্যের লেখা যোগ হয়। মডেলের আত্মবিশ্বাস নির্ভুলতার মাপকাঠি হওয়া বন্ধ করে কপি করার সহজতার মাপকাঠিতে পরিণত হয়।
RGV একটি বৃত্তাকার পথ প্রস্তাব করে, যা প্রায় একঘেয়ে দেখায় — উত্তর ও সূত্রের মধ্যে শব্দের ছেদ গণনা করা। কিন্তু ঠিক এই একঘেয়েমিই পদ্ধতিটিকে আকর্ষণীয় করে তোলে: এটি সস্তা, স্বচ্ছ, মডেলের অভ্যন্তরীণ কিছু দরকার নেই, আর যেখানে সঠিক উত্তর শোরগোলে ডুবে যায় সেখানে লক্ষণীয় লাভ দেয়। যেসব দল প্রস্তুত API থেকে অনুসন্ধান এজেন্ট তৈরি করে, তাদের জন্য এটি উপকারী উন্নতির বিরল উদাহরণ, যার জন্য পুনঃপ্রশিক্ষণ বা ইনফারেন্সে নতুন বাজেট — কোনোটিই দরকার নেই।


