
মলিকুলার ভেক্টর অবকাঠামো হিসেবে
কম্পিউটেশনাল কেমিস্ট্রিতে অণুর এমবেডিং অনেক আগেই কেবল একটি কারিগরি খুঁটিনাটি হয়ে থাকেনি। এটি একটি পুনঃব্যবহারযোগ্য অবকাঠামো: একই ভেক্টর উপস্থাপনা একইসাথে যৌগের বৈশিষ্ট্য পূর্বাভাস, ভার্চুয়াল স্ক্রিনিং এবং অনুরূপ অণু খোঁজার কাজে ব্যবহৃত হয়। একবার হিসাব করে নিন — তারপর দশটি পরিস্থিতিতে প্রয়োগ করুন, লাইব্রেরি র্যাঙ্কিং থেকে শুরু করে ল্যাবরেটরির জন্য প্রার্থী বাছাই পর্যন্ত।
একটি উপস্থাপনার অচলাবস্থা
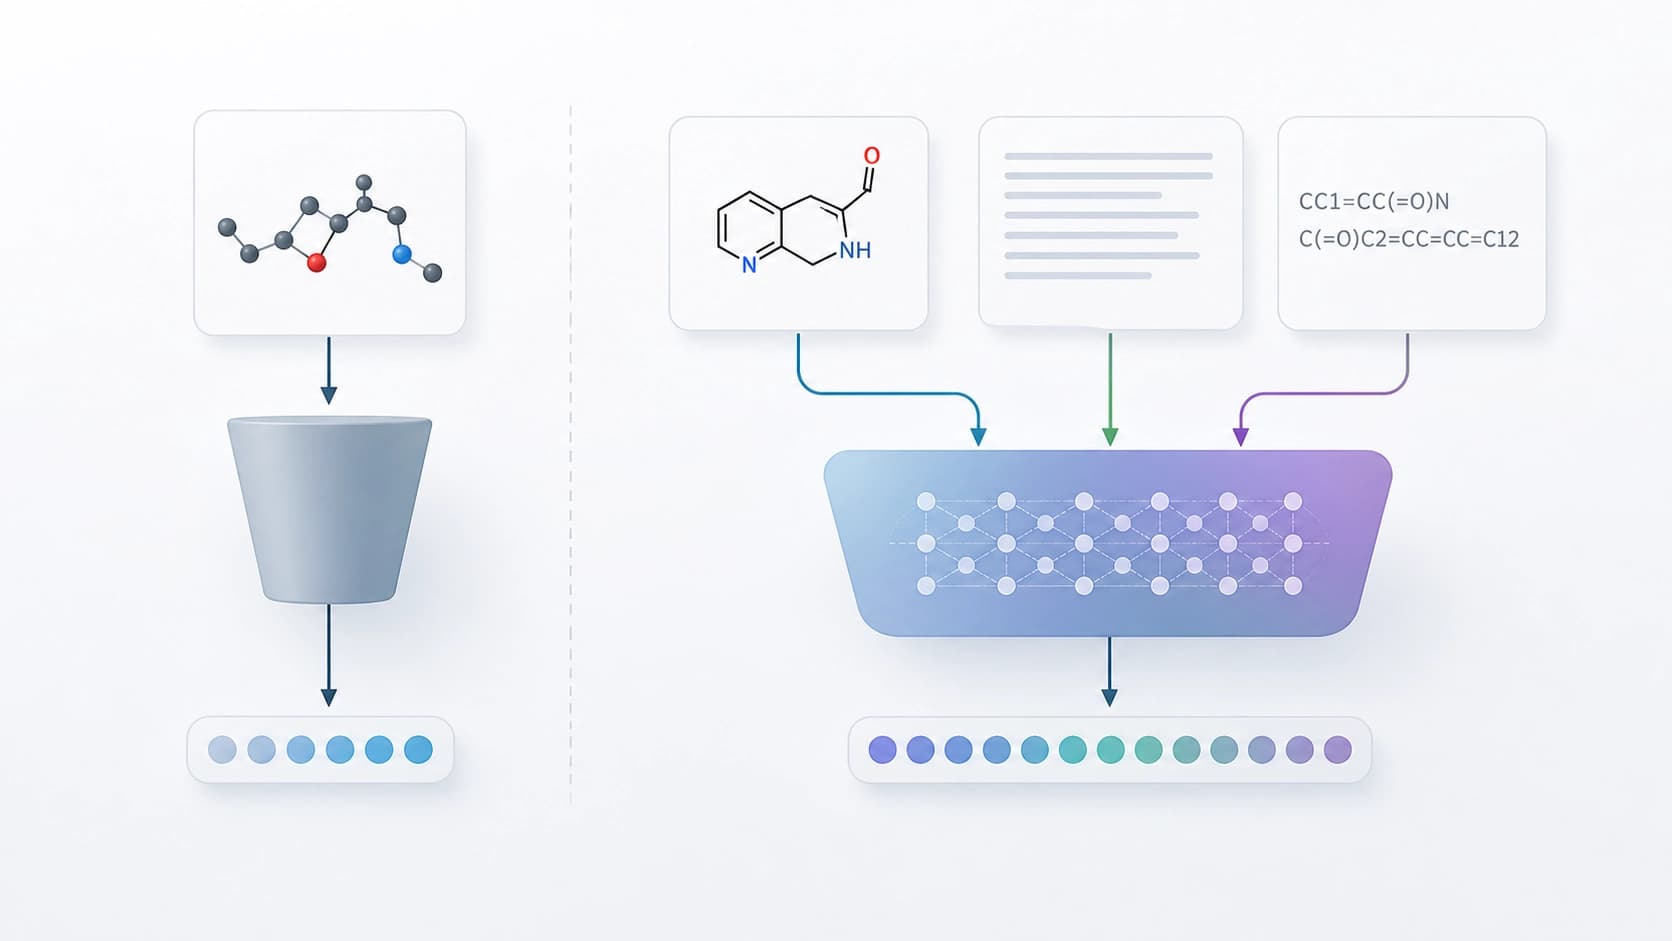
প্রায় সব মলিকুলার এনকোডার একই ধরনে গড়া: একটি একক মোডালিটি বেছে নেওয়া হয় — পরমাণুর গ্রাফ, SMILES স্ট্রিং, ভৌত-রাসায়নিক ডেসক্রিপ্টরের সেট বা 3D-কনফরমেশন — এবং মডেল কেবল তার উপরেই প্রশিক্ষিত হয়। আউটপুটে পাওয়া ভেক্টরটি শর্তহীন হয়ে যায়। এতে এমন কোনো ইন্টারফেস থাকে না, যার মাধ্যমে অনুরোধটি আরও নির্দিষ্ট করা যেত: "ক্রিয়ার কৌশল অনুযায়ী সদৃশ চাই, কার্বন কাঠামো অনুযায়ী নয়" বা "অনুরূপ যৌগ, তবে দ্রাব্যতার দিকে লক্ষ্য রেখে"।
এখান থেকেই একটি অস্বস্তিকর পরিণতি আসে। একই অণুকে বিভিন্ন মডেল ভিন্নভাবে দেখে, আর তাদের উপস্থাপনাগুলো সরাসরি তুলনা করা যায় না — স্থানগুলো পরস্পর সমন্বিত নয়। রসায়নবিদকে তখন মাথায় রাখতে হয় কোন এনকোডার কোন কাজের জন্য উপযুক্ত, বরং কেবল শব্দে সমস্যাটি বর্ণনা করার পরিবর্তে।
লেখকরা যে প্রশ্নটি তুলেছেন
Xinjian Zhao, Xiangru Jian, Yaoyao Xu, Xiaozhuang Song, Wei Pang, Lei Bai এবং Tianshu Yu-এর কাজটি (arXiv:2608.23646, ২৪ আগস্ট ২০২৬; ICML 2026-এর অংশ হিসেবে FM4LS ওয়ার্কশপে উপস্থাপিত, non-archival) ঠিক এই অসন্তোষ থেকেই শুরু হয়। গবেষকরা প্রশ্ন তোলেন: অণুর প্রতিটি উপস্থাপনার জন্য আলাদা এনকোডার বানানোর দরকারই বা কী, যখন মাল্টিমোডাল LLM-গুলো ইতিমধ্যেই ছবি, টেক্সট এবং প্রতীকী লেখার সাথে স্বাভাবিকভাবে কাজ করতে পারে?
যুক্তিটি সরল। যদি মডেল ইতিমধ্যেই কাঠামোগত সূত্রের ছবি "দেখে", বর্ণনা পড়ে এবং SMILES বিশ্লেষণ করে, তবে তাকে উপদেষ্টা-সহায়ক নয়, বরং ভেক্টর উৎপাদক হিসেবে গড়ে তোলা যায়। তাছাড়া সেই ভেক্টরগুলো হবে শর্তসাপেক্ষ — যা কেবল অণুর উপরই নির্ভর করে না, বরং স্বাভাবিক ভাষায় তার সম্পর্কে যা জিজ্ঞাসা করা হয় তার উপরও নির্ভর করে।
ফ্রেমওয়ার্কটি কীভাবে গঠিত
MolEmb হলো একটি হালকা সংযোজন, নতুন কোনো বড় মডেল নয়। এটি ইতিমধ্যে বিদ্যমান একটি MLLM-কে এমনভাবে অভিযোজিত করে, যাতে মলিকুলার প্রোফাইল এবং তাদের টেক্সট বর্ণনা একই সাধারণ এমবেডিং স্থানে অবস্থান করে। মূল উপাদানটি হলো দ্বিমুখী কনট্রাস্টিভ লক্ষ্য: এটি "অণু — টেক্সট" জোড়াগুলোকে পরস্পরের কাছে টেনে আনে এবং একইসাথে মিলহীন জোড়াগুলোকে দূরে ঠেলে দেয়।
কেন এটি যতটা মনে হয় তার চেয়ে বেশি গুরুত্বপূর্ণ
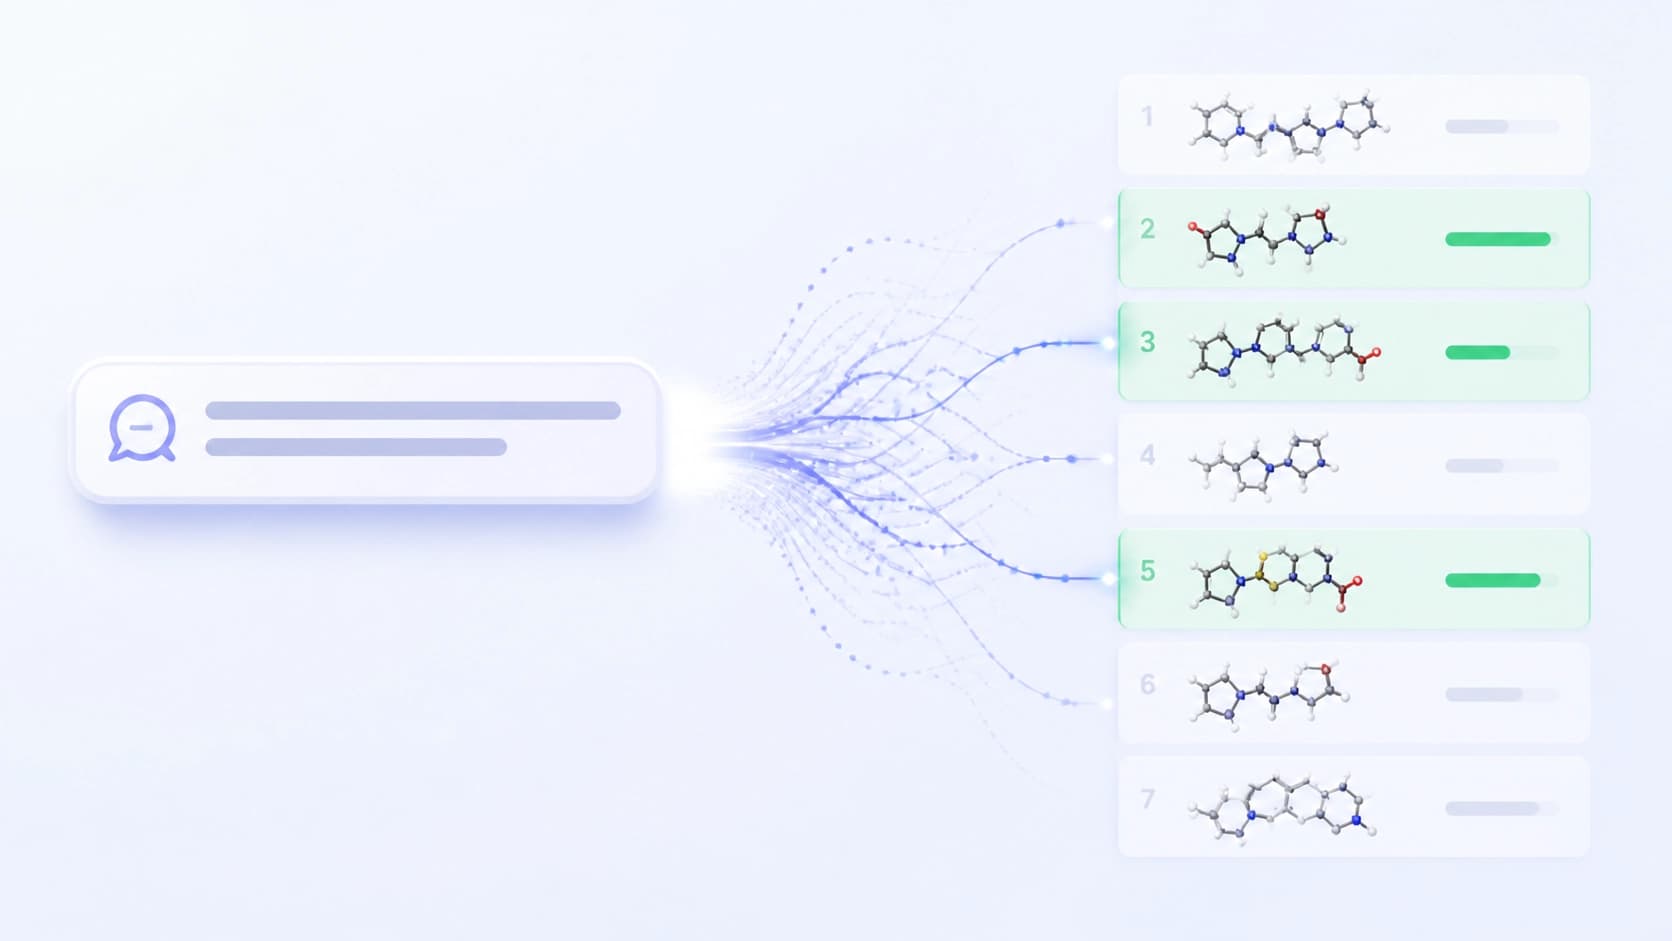
এখানে কনট্রাস্টিভ শেখা একইসাথে দুটি কাজ সমাধান করে। প্রথমত, এটি একটি সাধারণ স্থানাঙ্ক ব্যবস্থা নির্ধারণ করে: অণুর ভেক্টর এবং তার বর্ণনার ভেক্টর তুলনাযোগ্য হয়ে ওঠে। দ্বিতীয়ত, এটি উভয় দিকে ক্রস-মোডাল অনুসন্ধান দেয় — অণু থেকে টেক্সট খুঁজুন, টেক্সট থেকে অণু খুঁজুন, তাও একই স্থানের ভেতরে, মোডালিটিগুলোর মধ্যে কোনো মধ্যবর্তী অনুবাদক ছাড়াই।
ঘোষিত ফলাফলটি "সব বেঞ্চমার্ক ভেঙে দিয়েছি"-র চেয়ে বিনয়ী, আর সেজন্যই বেশি বিশ্বাসযোগ্য: প্রাপ্ত উপস্থাপনাগুলো মলিকুলার বৈশিষ্ট্য পূর্বাভাসে প্রতিযোগিতামূলক এবং একইসাথে মোডালিটিগুলোর মধ্যে অনুসন্ধান সমর্থন করে। অর্থাৎ ভাষাগত ইন্টারফেসটি ধ্রুপদী কাজগুলোর অবনতির বিনিময়ে কেনা হয়নি।
নিয়ন্ত্রণের হাতিয়ার হিসেবে ভাষা
প্রচলিত এনকোডার থেকে মূল পার্থক্য হলো শর্তসাপেক্ষতা। বিশেষায়িত মডেল একটি অণুর জন্য একটি নির্দিষ্ট ভেক্টর দেয়। কিন্তু ফ্রেমওয়ার্কটি শব্দে শর্ত প্রণয়ন করে সেই শর্তের দিকে সরে যাওয়া একটি উপস্থাপনা পাওয়ার সুযোগ দেয়। একই অণু ভিন্নভাবে উপস্থাপিত হতে পারে — আপনি বিষাক্ততা, দ্রাব্যতা নাকি নির্দিষ্ট শ্রেণির যৌগের সাথে নৈকট্য নিয়ে আগ্রহী, তার উপর নির্ভর করে।
প্রসঙ্গ-নির্ভর মলিকুলার অনুসন্ধান
কাজটির একটি আলাদা অংশ হলো ডায়াগনস্টিক বেঞ্চমার্ক MolCAR। এটি তৈরি করা হয়েছে প্রসঙ্গ-নির্ভর অনুসন্ধান যাচাই করার জন্য, অর্থাৎ এমন পরিস্থিতি যেখানে সঠিক উত্তর অনুরোধের ভাষার উপর নির্ভর করে বদলে যায়। এটি ধ্রুপদী অনুরূপ কাঠামো অনুসন্ধানের চেয়ে মৌলিকভাবে কঠিন: সেখানে মানদণ্ড একটিই, এখানে তা সমস্যার উপস্থাপনার উপর নির্ভর করে।
সবচেয়ে আকর্ষণীয় সিদ্ধান্ত
সম্ভবত লেখকদের সবচেয়ে মূল্যবান পর্যবেক্ষণটি প্রায় নিত্যদিনের মতো শোনায়: প্রসঙ্গ-নির্ভর মলিকুলার এমবেডিং মূলত সুপারভিশন ডেটার একটি বৈশিষ্ট্য, কোনো স্থাপত্যকৌশলগত কৌশল নয়। অন্য কথায়, মডেল প্রসঙ্গগুলো আলাদা করতে শুরু করে এই কারণে নয় যে তাতে একটি চতুর মডিউল বসানো হয়েছে, বরং এই কারণে যে তাকে এমন জোড়ার উপর শেখানো হয়েছে যেখানে প্রসঙ্গ সত্যিই ভিন্ন।
সিদ্ধান্তটি একইসাথে বাস্তববাদী এবং উপকারী। এটি মনোযোগ স্থাপত্যের প্রতিযোগিতা থেকে প্রশিক্ষণ ডেটার গুণমান ও কাঠামোর দিকে সরিয়ে দেয়: যদি ডেটাসেটে অণুর বর্ণনাগুলো একরকম হয়, তবে কোনো মাল্টিমোডালিটিই মডেলকে অনুরোধের সূক্ষ্মতা প্রতি সংবেদনশীলতা দান করবে না।
বাস্তবে এটি কী বদলায়
যদি এমন পদ্ধতি স্কেল করা যায়, তবে লাভটি দেখতে এমন:
- এনকোডারদের চিড়িয়াখানার বদলে একক অবকাঠামো। একটি মডেলই বৈশিষ্ট্য, অনুসন্ধান এবং ক্রস-মোডাল অনুরোধ — সবই সামলায়।
- মডেল বাছাইয়ের বদলে শব্দে অনুরোধ। ব্যবহারকারীর জানার দরকার নেই তার ক্ষেত্রে কোন এনকোডার ভালো।
- সামঞ্জস্যপূর্ণ স্থান। অণু ও টেক্সটের ভেক্টর একসাথে থাকে, অর্থাৎ সেগুলো তুলনা ও সমন্বয় করা যায়।
- প্রস্তুত MLLM পুনঃব্যবহার। ফ্রেমওয়ার্কটি বিদ্যমান মডেলকে অভিযোজিত করে, শূন্য থেকে প্রশিক্ষণ দেয় না।
সীমা ও খোলা প্রশ্ন
কাজটি non-archival হিসেবে চিহ্নিত, অর্থাৎ এটি একটি প্রস্তুত পণ্যের চেয়ে বরং একটি দিকনির্দেশনা। অনেক প্রশ্ন রয়ে যায়: যাচাই করা ডেটাসেটের বাইরে পদ্ধতিটি কতটা টেকসই, বিরল শ্রেণির যৌগে এটি কেমন আচরণ করে, ভাষাগত অংশটি রাসায়নিক অংশের উপর প্রাধান্য বিস্তার করতে শুরু করে কি না এবং এটি ভেক্টরটিকে ভৌতভাবে অর্থবহ উপস্থাপনার বদলে টেক্সটের পুনর্কথনে পরিণত করে কি না।
তবুও মূল ভাবনাটি স্পষ্টভাবে প্রণীত। মাল্টিমোডাল LLM-গুলো কেবল রাসায়নিক সহায়ক বা কেবল উত্তর উৎপাদক নয়। তারা মলিকুলার এমবেডিংয়ের একটি সাধারণ ব্যবস্থার ভূমিকার দাবি করে: সম্প্রসারণযোগ্য, শব্দে নিয়ন্ত্রণযোগ্য এবং নতুন কাজের জন্য পুনঃপ্রশিক্ষণের প্রতি উন্মুক্ত।


