
সমস্যা: এজেন্টের ট্রেস একটি লগ, আচরণের মডেল নয়
মাল্টি-স্টেপ LLM এজেন্ট তার পিছনে একটি দীর্ঘ চিহ্ন রেখে যায়: টুল কল, মধ্যবর্তী যুক্তি, সংশোধন, পুনরায় চেষ্টা। এটি চোখে পড়া প্রায় অর্থহীন — শত শত লাইনের টেক্সট, যেখানে দরকারি সংকেত পুরো আয়তনে ছড়িয়ে থাকে। যে ডেভেলপার এজেন্টকে প্রোডাকশনে ছাড়ছেন, তার কাছে এমন লগ একটি ব্ল্যাক বক্সে পরিণত হয়: কোথায় ঠিক রানটি ভুল পথে গেল, বা সিস্টেমের জন্য কোন অবস্থাগুলো সাধারণ, তা কিছুই বোঝা যায় না।
ঠিক এই বিষয়েই arXiv:2608.23670 (cs.AI) «Automata from Agent Traces: Failure and Next-Step Prediction» কাজটি — এর লেখক Seonglae Cho, Franklin Cardenoso Fernandez, Umar Mohammed, Zekun Wu, Kleyton Da Costa, Ilham Wicaksono এবং Adriano Koshiyama প্রস্তাব করেন ট্রেসগুলোকে টেক্সট হিসেবে নয়, বরং অবস্থার মধ্যে переходের ডেটা হিসেবে দেখা। যুক্তিটি সহজ: যদি এজেন্টের আচরণ প্রতিটি রান থেকে রানে পুনরাবৃত্ত হয়, তাহলে বাহ্যিক বিশৃঙ্খলার পিছনে একটি কাঠামো আছে, এবং তা পুনরুদ্ধার করা সম্ভব।
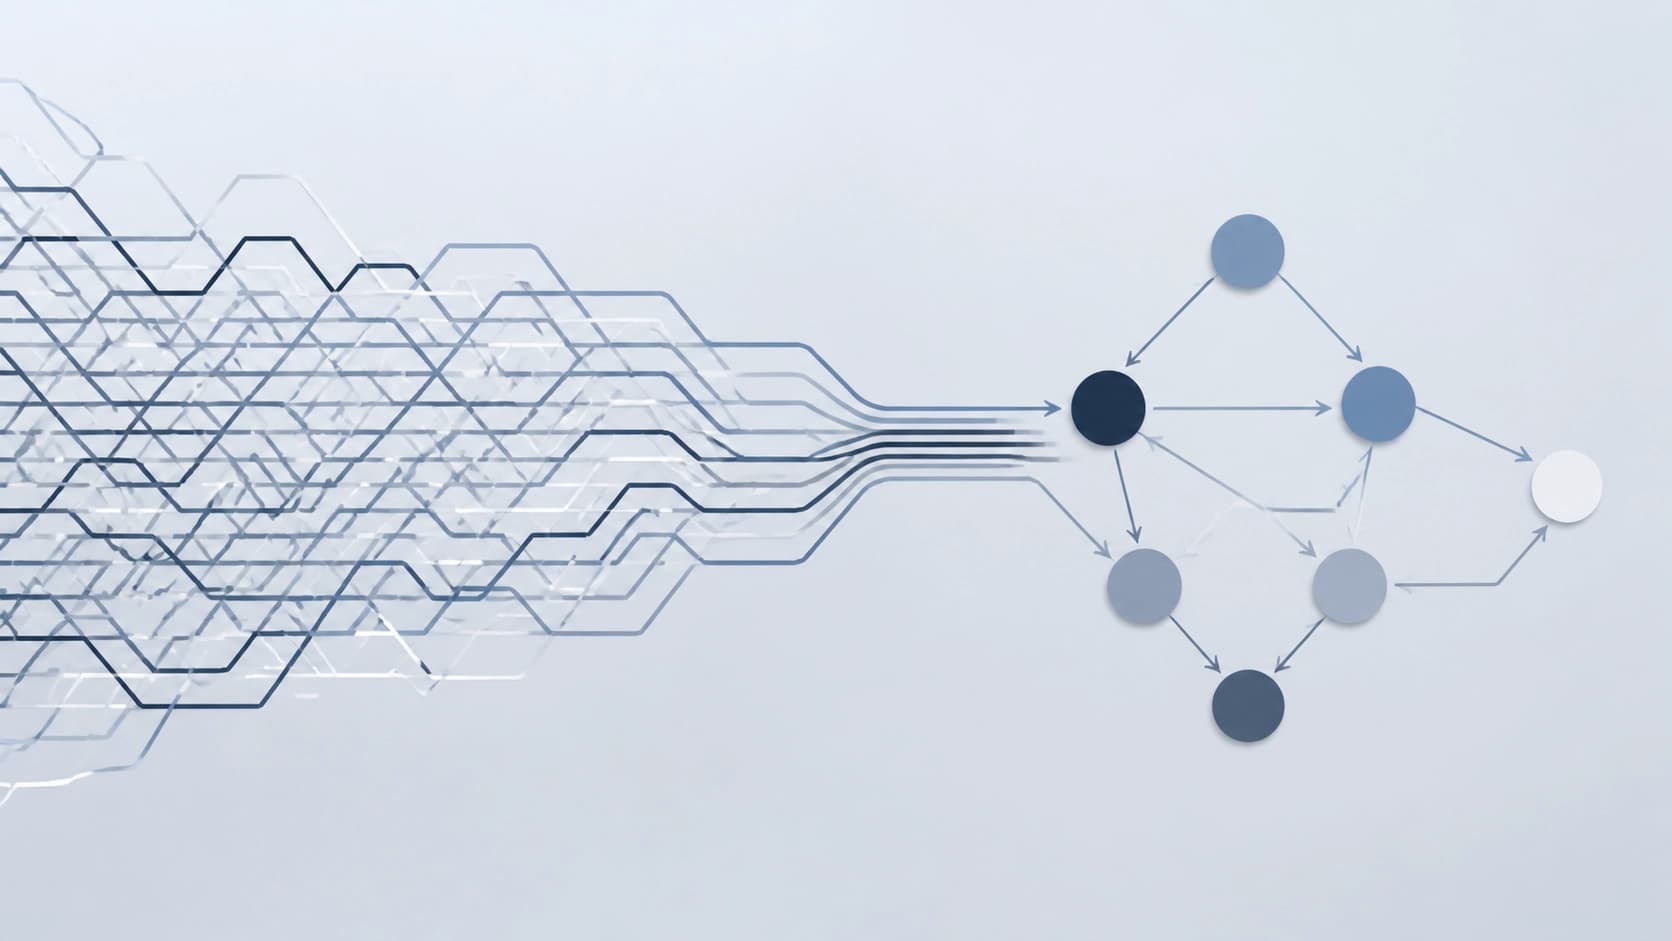
আলাদাভাবে উল্লেখ করা দরকার, আগের পদ্ধতিগুলোতে কী অভাব ছিল। বিশ্লেষণ সাধারণত একবারে একটি ট্রেস ধরে করা হতো, অথবা শুধু সফল রানের উপর নির্ভর করা হতো। দুই ক্ষেত্রেই সামগ্রিক চিত্রটি হারিয়ে যায় — সেই টপোলজি, যা পরবর্তী কর্মের পূর্বাভাস এবং ব্যর্থতার পূর্বাভাসকে পরস্পরের সাথে যুক্ত করে। অথচ নিরাপত্তা নিরীক্ষা এবং রিয়েল-টাইম মনিটরিং — দুই ক্ষেত্রেই ঠিক এটিই দরকার।
পুরো কর্পাসের জন্য একটি অটোমেটন
পদ্ধতির ধারণা: সমস্ত ট্রেসের সেট নিয়ে সেটিকে একটি মাত্র কম্প্যাক্ট ফিনিট স্টেট মেশিনে (FSM) সংকুচিত করা। প্রতিটি রানের জন্য সিদ্ধান্ত-বৃক্ষ নয়, ভেক্টর স্পেসে কোথাও এমবেডিং নয়, বরং অবস্থা ও переходসহ একটি সাধারণ গ্রাফ — সেই কাঠামোগত সাবস্ট্রেট, যা এজেন্টের আচরণকে যদি পূর্বানুমেয় না-ও করে, অন্তত বর্ণনাযোগ্য করে তোলে।
বারোটি পাবলিক ডেটাসেটে ফলাফল আশাব্যঞ্জক দেখাচ্ছে:
- অটোমেটনগুলো ছোট হয় — ৭ থেকে ৪৩টি অবস্থা, অর্থাৎ সেগুলো সত্যিই আঁকা যায় এবং একটি কল-এ আলোচনা করা যায়;
- হোল্ডআউট ডেটায় তারা 0.997-এর কম নয় এমন fitness-এ ট্রেস পুনরুৎপাদন করে — প্রায় নিখুঁত মিল;
- একটি ডেটাসেটের বিভিন্ন স্প্লিটে তৈরি টপোলজি প্রায় একই রকম হয়;
- নির্মাণ নিজেই মিলিসেকেন্ডে শেষ হয়, ঘণ্টার পর ঘণ্টা প্রশিক্ষণে নয়।
শেষ পয়েন্টটি যতটা মনে হয় তার চেয়ে বেশি গুরুত্বপূর্ণ। যে পদ্ধতি তৎক্ষণাৎ তৈরি হয়, তা প্রম্পট বা কনফিগারেশনের প্রতিটি সংশোধনের পরেই পুনর্নির্মাণ করা যায় — এবং সঙ্গে সঙ্গে দেখা যায়, সিস্টেমের আচরণ বদলেছে কি না।
কেন এটি কেবল সুন্দর একটি ভিজ্যুয়ালাইজেশন নয়
এখানে কম্প্যাক্টতা নিজেই লক্ষ্য নয়। যখন হাজার হাজার লাইনের টেক্সটের বদলে আপনার কাছে ২০টি অবস্থা থাকে, তখন এজেন্টের কাজের মোড নিয়ে চিন্তা করার সুযোগ তৈরি হয়: এই যে «চেষ্টা করল — ত্রুটি পেল — পুনরাবৃত্তি করল» চক্র, এই যে «কাজটি স্পষ্টীকরণমূলক প্রশ্নে গিয়ে ঠেকল» শাখা, এই যে বিরল অবস্থা, যা থেকে প্রায় কোনো পথ বেরোয় না। এরপর এই মোডগুলো নিয়ে প্রকৌশলীভাবে কাজ করা যায় — যেমন প্রতিটি অবস্থার উপর গণনা করা বৈশিষ্ট্য তৈরি করা।
পরবর্তী ধাপের পূর্বাভাস: স্মৃতির চেয়ে অবস্থা বেশি গুরুত্বপূর্ণ
এজেন্টের পরবর্তী কর্মের পূর্বাভাসের জন্য লেখকেরা FSM অবস্থার কনটেক্সট ব্যবহার করেন। এবং এই পদ্ধতি প্রতিটি ডেটাসেটে Agent Workflow Memory-কে ছাড়িয়ে যায়, যেখানে লেবেলিং বাস্তব কার্যসম্পাদনের ধারার সাথে সঙ্গতিপূর্ণ। অন্য কথায়, «এজেন্ট এখন কোন মোডে আছে» — এই জ্ঞানটি কাজের পূর্ববর্তী এপিসোডগুলোর সঞ্চিত স্মৃতির চেয়ে বেশি কাজে লাগে।
এখানে একটি মজার সূক্ষ্ম বিষয় আছে। অবস্থার কনটেক্সট কেবল নোডের নম্বর নয়, বরং ইতিমধ্যে কী ঘটেছে এবং এরপর কী ঘটার সম্ভাবনা কত — তার একটি সংকুচিত বর্ণনা। ফলে এক ধরনের সম্ভাব্য ধারাবাহিকতার মানচিত্র তৈরি হয়, যা টেক্সটের সেমান্টিক্সের উপর নয়, বরং переходের পরিসংখ্যানের উপর গড়া। বাস্তব কাজে এর অর্থ হলো, পরবর্তী ধাপের পূর্বাভাসককে আরও সস্তায় প্রশিক্ষণ দেওয়া যায়: তার মডেলের লুকানো অবস্থাগুলোতে প্রবেশাধিকার দরকার নেই, কাঠামোই যথেষ্ট।
ব্যর্থতার পূর্বাভাস এবং আংশিক ট্রেসে মনিটরিং
কাজের দ্বিতীয় অর্ধেকটি ডায়াগনস্টিকস নিয়ে। অটোমেটনের পৃথক অবস্থাগুলোর উপর গণনা করা বৈশিষ্ট্যগুলো হোল্ডআউট ডেটায় 0.94 পর্যন্ত AUROC দেয়। অর্থাৎ, LLM-এর অন্তর্গত বিষয়ে কিছু না জেনেও একটি মডেল আচরণগত বৈশিষ্ট্যের ভিত্তিতে ব্যর্থতায় শেষ হওয়া রান এবং শেষ পর্যন্ত পৌঁছানো রানগুলোর মধ্যে পার্থক্য করতে পারে।
এখানে সবচেয়ে ব্যবহারিক বিষয়টি হলো অনলাইন মনিটর। এটি অসম্পূর্ণ ট্রেসের দিকে তাকিয়ে সমাপ্তির জন্য অপেক্ষা না করেই ব্যর্থ রানগুলোকে সফল রানগুলোর চেয়ে উপরে স্থান দেয়। এজেন্ট চূড়ান্তভাবে ভুল পথে যাওয়ার অনেক আগেই আর্লি স্টপ চালু করার জন্য এটি যথেষ্ট: টোকেন, সময় বাঁচানো যায় এবং আরও গুরুত্বপূর্ণ — এজেন্টকে ক্ষতি করতে না দেওয়া যায়। যে এজেন্টগুলো ডেটাবেসে লেখে, পেমেন্ট API কল করে বা ইনফ্রাস্ট্রাকচার পরিচালনা করে, তাদের জন্য মাঝপথে কার্যসম্পাদন বাধা দেওয়ার এই সুযোগটি বিলাসিতা নয়, বরং একটি প্রয়োজনীয়তা।
মূল সিদ্ধান্ত: আচরণ নির্ধারণ করে obвязка, মডেল নয়
সম্ভবত নিবন্ধের সবচেয়ে উসকানিমূলক বক্তব্যটি এই: এজেন্টের আচরণগত টপোলজি অনেকাংশে নির্ধারিত হয় ভাষা মডেল নিজে দ্বারা নয়, বরং deployment harness — যে obвязка-এর মধ্যে মডেলটি চালানো হয়, তা দ্বারা। প্রম্পট টেমপ্লেট, টুলের সেট, ত্রুটি পরিচালনার নিয়ম, ধাপের সীমা — এগুলোই переходের গ্রাফ গঠন করে।
এ থেকে কয়েকটি সিদ্ধান্তে আসা যায়। প্রথমত, একই obвязকায় মডেল বদলে অন্য মডেল বসালে আচরণের কাঠামো আমূল বদলে নাও যেতে পারে — অর্থাৎ, একটি মডেলে তৈরি অটোমেটন অন্য মডেলে যাচাই করা উচিত। দ্বিতীয়ত, এজেন্টের উন্নতি করা প্রায়ই ওয়েট আপগ্রেডের চেয়ে harness-এ পরিবর্তনের মাধ্যমে বেশি কার্যকর। তৃতীয়ত, একটি model-agnostic কাঠামোগত প্রিমিটিভ আবির্ভূত হয়: একই পদ্ধতি নিরাপত্তা নিরীক্ষা এবং runtime-মনিটরিং — দুই ক্ষেত্রেই উপযুক্ত, আপনি কার API কল করছেন তা নির্বিশেষে।
মনে রাখা উচিত
পদ্ধতিটি সতর্কতার প্রয়োজন মেটায় না। বারোটি ডেটাসেট এখনও একটি সীমিত নমুনা, এবং fitness 0.997 বলে যে অটোমেটন ইতিমধ্যে সংগৃহীত ট্রেসগুলোকে কত ভালোভাবে বর্ণনা করে, তা নয় যে এটি অপরিচিত পরিবেশে সিস্টেমের আচরণ পূর্বাভাস দেবে। ব্যর্থতার পূর্বাভাসের জন্য উচ্চ AUROC-ও নির্দিষ্ট কাজের উপর পাওয়া: নতুন ডোমেইনে বৈশিষ্ট্যগুলো পুনরায় গণনা করতে হবে।
তবুও দিকটি যুক্তিসঙ্গত দেখাচ্ছে। কনটেক্সট উইন্ডো অসীমভাবে বাড়িয়ে «মডেল নিজেই বুঝে নেবে» আশা করার বদলে, একবার নিজের obвязকা-এর একটি কম্প্যাক্ট আচরণ মডেল তৈরি করা যায় — এবং এরপর সেটিকে একটি স্কিমা হিসেবে ব্যবহার করা যায়: দেখা যায় এজেন্ট কোথায় আটকে যায়, কোন অবস্থাগুলো ব্যর্থতার দিকে নিয়ে যায়, এবং কনফিগারেশন ঠিক করলে কী বদলাবে। অটোমেটন LLM-এর চেয়ে বুদ্ধিমান নয়, কিন্তু সে বেশি সৎ: তাকে সম্পূর্ণভাবে মাথায় ধারণ করা যায়, আর ডিবাগিংয়ে এটি ইতিমধ্যে অর্ধেক সাফল্য।


