
যে প্রোটোকল কেউ হুবহু অনুসরণ করে না
ল্যাবরেটরি প্রোটোকল খুব কমই অক্ষরে অক্ষরে অনুসরণ করা হয়। প্রকাশনা আর প্রকৃত পরীক্ষার মাঝখানে প্রায় সবসময়ই থাকে অভিযোজন: ভিন্ন কোষ-রেখা, বদলে দেওয়া রিএজেন্ট, কম নমুনা, অন্যের যন্ত্র, কাটছাঁট করা বাজেট। ভেজা বেঞ্চে কাজ করা মানুষের কাছে এটি রুটিন, কিন্তু রুটিনটা ধূর্ত — যেকোনো পরিবর্তন টেনে আনে একগুচ্ছ পরিণতি। শুরুর ধাপে রিএজেন্টের পরিমাণ বদলালে মনে রাখতে হয়, ধোয়ার ধাপে এর ফল কী হবে আর আগে যা করা হয়েছে তার সঙ্গে এটি কীভাবে মিলবে। ঠিক এই দক্ষতাটাই — পুরো প্রোটোকল মাথায় ধরে রেখে অর্থপূর্ণভাবে তা বদলানোর ক্ষমতা — নতুন এই টাস্ক-সেট যাচাই করে।
গবেষণাটি প্রকাশ পেয়েছে BenchBench-Protocol নামে, arXiv:2608.23898v1 (cs.AI) প্রিপ্রিন্টে, জমা দেওয়া হয়েছে ২০২৬ সালের ২৪ আগস্ট। লেখকরা হলেন Aditya Sivakumar, Ashu Singhal, Nicholas Larus-Stone এবং Nithin Parsan। এটি ২১ পৃষ্ঠা ও ১৫টি চিত্র, অর্থাৎ উপাদানটি বিজ্ঞাপনের চেয়ে বরং পদ্ধতিগত।
খসড়া সংশোধন থেকে ১৪৯টি টাস্ক কীভাবে তৈরি হলো
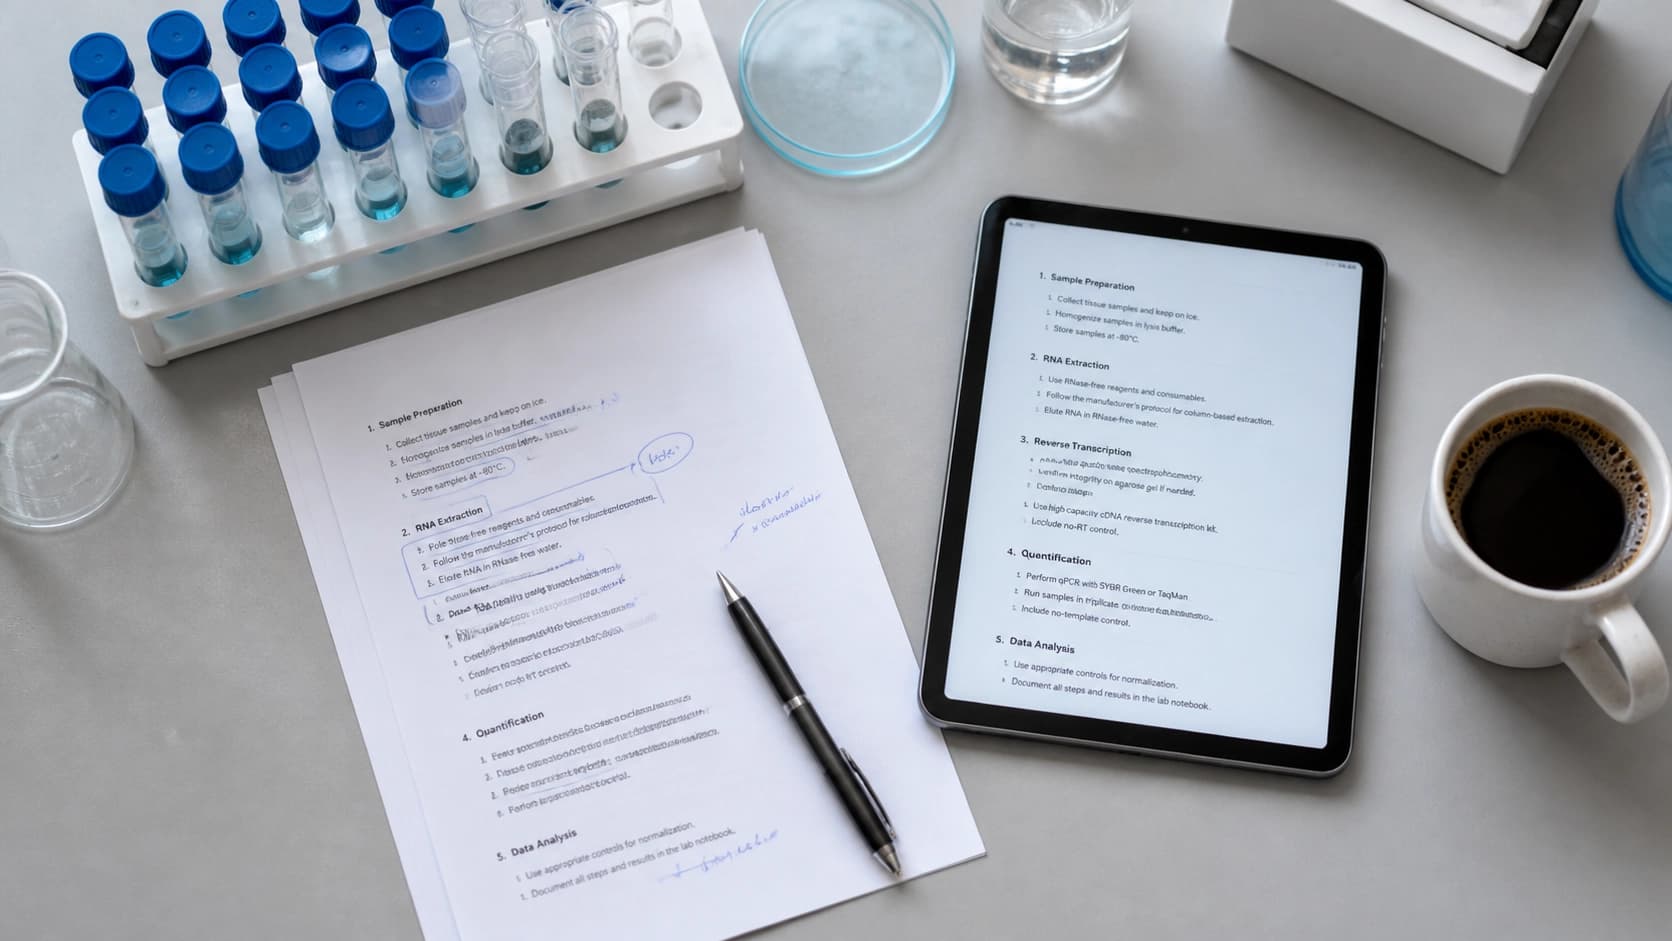
BenchBench-Protocol-এর কার্যপ্রণালী অস্বাভাবিক। লেখকরা প্রশ্ন লিখতে বসেননি — তাঁরা নিয়েছেন কাজের একটি বিদ্যমান চিহ্ন। প্রতিটি প্রকাশিত প্রোটোকলের একটি সংস্করণ পাওয়া গেছে, যা গবেষক নিজের নির্দিষ্ট পরীক্ষার জন্য সংশোধন করেছিলেন। এই দুই নথির পার্থক্যই হয়ে উঠেছে টাস্ক: মডেলকে দেখানো হয় মূল প্রোটোকল ও নতুন পরীক্ষার শর্ত, আর তাকে প্রস্তাব করতে হয় একটি সঠিক পরিবর্তন।
এই পদ্ধতি থেকেই সরাসরি একটি গুরুত্বপূর্ণ দিক উঠে আসে: টাস্কের একটি বিমূর্ত "সঠিক উত্তর" নেই, আছে একটি ওজনযুক্ত রুব্রিক। কারণ একজন জীবিত গবেষক যে সংশোধন করেছিলেন তা জানা আছে — এটিকে উপাদানে ভাগ করা যায় এবং মূল্যায়ন করা যায়, মডেলের প্রস্তাব অর্থে বাস্তব সমাধানের সঙ্গে কতটা মেলে, শব্দচয়নে নয়। এটি বায়োমেডিকেল পরীক্ষার চিরন্তন সমস্যাটি দূর করে, যেখানে মডেল যুক্তিসঙ্গত কিন্তু মানদণ্ডের সঙ্গে না মেলা উত্তর দিয়ে শূন্য পেতে পারে।
ভিত্তিটা হয়েছে বেশ শক্ত: ভেজা ল্যাবরেটরি পরীক্ষার নয়টি জীববিজ্ঞান ক্ষেত্র থেকে ৯৬টি মূল প্রোটোকল। চূড়ান্ত সেটে কেবল সেই টাস্কগুলোই ঢুকেছে, যেগুলো উচ্চ রেটিংসহ বিশেষজ্ঞ যাচাই পেরিয়েছে — বাকিগুলো বাদ পড়েছে। ফলাফলই সেই ১৪৯টি কাজ।
কেন এটি বিশেষজ্ঞদের আরেকটি প্রশ্ন-সেট নয়
লেখকরা আলাদাভাবে প্রেক্ষাপটটি স্পষ্ট করেন। সাম্প্রতিক বছরগুলোতে বায়োমেডিকেল বেঞ্চমার্ক সত্যিই খোলা টাস্ক ও রুব্রিক-ভিত্তিক মূল্যায়নের দিকে সরে গেছে — এটি অগ্রগতি। কিন্তু কাজগুলো এখনও বেশিরভাগ ক্ষেত্রেই বিশেষজ্ঞরা বানান: বসে নিজেদের অভিজ্ঞতার ভিত্তিতে প্রশ্ন লেখেন। এই পদ্ধতির সীমাবদ্ধতা হলো, বিশেষজ্ঞ এমন প্রশ্নের উত্তর দেন যা তিনি নিজেই গঠন করেছেন, অর্থাৎ পরোক্ষভাবে নিজের কঠিনতার ধারণার সঙ্গে মানিয়ে নেন।
এখানে যুক্তি উল্টো। টাস্কের জন্ম সেখানে, যেখানে একজন প্রকৃত মানুষ ইতিমধ্যেই একটি প্রকৃত সমস্যায় আটকে গেছেন এবং তা সমাধানে সময় ব্যয় করেছেন। এটি তথ্যের নিখুঁত পরিচ্ছন্নতার নিশ্চয়তা দেয় না, কিন্তু নিশ্চিত করে যে সমস্যাটি সুন্দর শব্দচয়নের জন্য বানানো হয়নি।
কে পারল, কে পারল না
পরীক্ষায় নয়টি মডেল অংশ নিয়েছিল — বন্ধ ও খোলা উভয়ই। ব্যবধান চোখে পড়ার মতো, যদিও নাটকীয় নয়।
সেরা ফলাফল দেখিয়েছে Claude Opus 5 — রুব্রিক অনুযায়ী ৫৯.২% স্বাভাবিকীকৃত স্কোর। বাকি মডেলগুলো ৩৪.১% থেকে ৪৭.১% পরিসরে থেমেছে। সহজ কথায়, শীর্ষস্থানীয়ের কাছে কেউ পৌঁছায়নি, তবে দেড় গুণের ব্যর্থতাও নেই: সব মডেলই কিছু একটা পারে, শুধু ভিন্নভাবে করে এবং সবসময় শেষ পর্যন্ত নয়।
রিপোর্টের আলাদা একটি লাইন — সম্পৃক্ততার পরীক্ষা। লেখকরা মডেলদের দশটি করে সুযোগ দিয়েছিলেন এবং সেরাটি বেছে নিয়েছিলেন (best-of-10)। এত উদার পদ্ধতিতেও বেঞ্চমার্ক "চুপসে" যায়নি: সীমা ছোঁয়া হয়নি। মূল্যায়নের জন্য এটি সুসংবাদ — অর্থাৎ পরবর্তী প্রজন্মের মডেল আসার পরেও টাস্ক-সেটটি পুরনো হয়ে যাবে না।
এর থেকে বাস্তবে যা বোঝা যায়
প্রথম উপসংহারটি প্রায়োগিক এবং কিছুটা বাস্তবতায় ফেরানো। প্রোটোকল অভিযোজনের জন্য ভাষা-মডেলকে পুরোপুরি বিশ্বাস করা এখনও সম্ভব নয়। এমনকি সেরা ৫৯.২% ফলাফলও বোঝায়, প্রায় দশটির মধ্যে চারটি ক্ষেত্রে প্রস্তাবটির জন্য মানুষের হস্তক্ষেপ দরকার। মডেল খসড়া হিসেবে, বিকল্প তৈরির উপায় হিসেবে, কিংবা আপনি হয়তো যা বাদ দিয়েছেন তা দ্রুত মিলিয়ে দেখার বাহন হিসেবে কাজে লাগে। কিন্তু টেস্ট টিউবের চূড়ান্ত দায়িত্ব তার নয়।
দ্বিতীয় উপসংহারটি পদ্ধতিগত, এবং প্রথমটির চেয়ে বেশি আগ্রহজনক। লেখকরা তাঁদের কাজকে কেবল ভেজা ল্যাবরেটরিতে যুক্তি-বিশ্লেষণের মূল্যায়ন হিসেবে নয়, বরং আরও সাধারণ একটি ধারণার প্রমাণ হিসেবে দেখেন: প্রকৃত পরীক্ষা হলো বেঞ্চমার্কের জন্য টাস্কের একটি অবমূল্যায়িত উৎস। ল্যাবরেটরিতে যদি সংশোধনের ইতিহাস আগে থেকেই থাকে, তবে মডেল যাচাইয়ের উপাদানও আছে — এবং তা এমন উপাদান, যা লেখার টেবিলে বসে ভাবা অসম্ভব।
তৃতীয় উপসংহারটি আগামী পথ নিয়ে। ৫৯.২% আর ৪৭.১%-এর ব্যবধান টাস্কের জটিলতার তুলনায় কোনো অতল গহ্বর মনে হয় না। এটি বরং ইঙ্গিত দেয়, সংকীর্ণ স্থানটি জীববিজ্ঞান সম্পর্কে মডেলের জ্ঞানের পরিমাণে নয়, বরং শৃঙ্খল গড়ার দক্ষতায়: আগের সিদ্ধান্তগুলো বিবেচনা করা এবং সেগুলো পরের ধাপে কোথায় নিয়ে যাবে তা পূর্বানুমান করা। ঠিক এই গুণটির জন্যই, তথ্য মুখস্থ করার জন্য নয়, ১৪৯টি সংশোধনের এই সেটটি নিবেদিত।


