
সংক্ষেপে: ঠিক কোথায় ব্যথা
যখন একটি দীর্ঘ-প্রসঙ্গ মডেল একটি অনুরোধ পরিবেশন করে, মূল খরচ ওজনে নয়, বরং KV-ক্যাশে যায় — ইতিমধ্যে পড়া সমস্ত টোকেনের সংরক্ষিত কী ও ভ্যালু। ডকুমেন্ট বা সংলাপ যত দীর্ঘ হয়, তত বেশি টেনসর মেমোরিতে রাখতে হয় এবং প্রতিটি জেনারেশন ধাপে তত বেশি ডেটা পুনরায় পড়তে হয়। এখান থেকেই সাধারণ দ্বিধা: হয় প্রসঙ্গ ছেঁটে ফেলো, নয়তো মেমোরি ও ইনফারেন্স গতির বিনিময়ে তা বহন করো।
বিদ্যমান সমাধানগুলো সাধারণত দুটি চরমের একটি বেছে নেয়। হয় পুরো অবস্থাটি একসাথে সংকুচিত করে, যাতে পরবর্তী উত্তরের জন্য প্রয়োজনীয় সাম্প্রতিক তথ্য হারানোর ঝুঁকি থাকে, নয়তো সবকিছু মূল নির্ভুলতায় রেখে দেয় এবং অ্যাক্সিলারেটরের ধারণক্ষমতায় আটকে যায়।
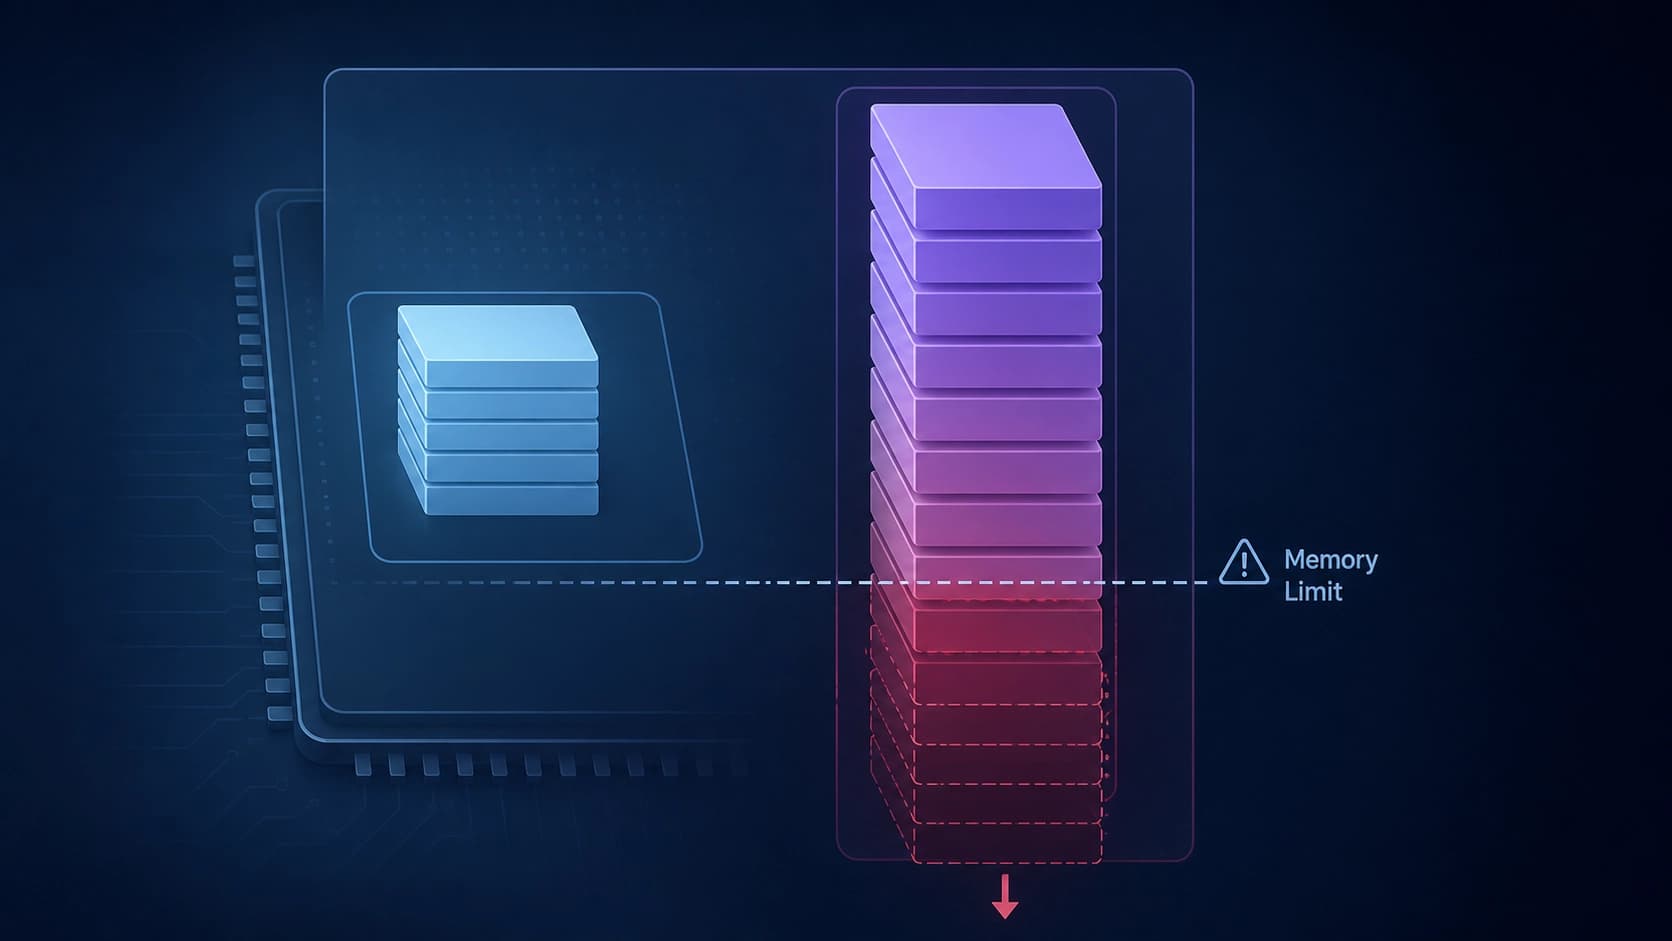
ঠিক এই দ্বিধাদ্বন্দ্বেই হস্তক্ষেপ করার চেষ্টা করছে নিচে আলোচিত কাজটি।
লেখকেরা কী প্রস্তাব করছেন
«Minima-KV: Retention-Preserving KV Cache Compression with Mixed-Format Paged Attention» শীর্ষক নিবন্ধটি ২০২৬ সালের ২৪ আগস্ট arXiv-এ 2608.23834 নম্বরে জমা দেওয়া হয়েছে, বিভাগ cs.AI, ১৩ পৃষ্ঠা ও ৩টি চিত্র, DOI 10.48550/arXiv.2608.23834। লেখক — Minima AI, Inc.-এর Sergii Kozyrev এবং Davyd Maiboroda। একটি কৌতূহলোদ্দীপক খুঁটিনাটি: প্রিপ্রিন্ট পৃষ্ঠায় PDF লিঙ্ক ব্লকে ক্যাপশনটি প্রথম লেখককে «এবং আরও দুজন» বলে নির্দেশ করছে, যদিও গ্রন্থপঞ্জি বিবরণে কেবল দুজনকে তালিকাভুক্ত করা হয়েছে। ছোট বিষয়, তবে এটি মনে করিয়ে দেয় যে প্রিপ্রিন্টের মেটাডেটা যাচাই করা উচিত।
Minima-KV-এর প্রস্তাবের মূল কথা হলো KV-ক্যাশে পৃষ্ঠাগুলোর একটি স্তরক্রম, যেখানে বিভিন্ন পৃষ্ঠা বিভিন্ন সংখ্যাসূচক ফরম্যাটে সংরক্ষিত হয়। শিরোনামের মূল শব্দটি হলো retention-preserving, অর্থাৎ «ধারণ সংরক্ষণকারী»: সাম্প্রতিক অনুরোধের অবস্থা কোথাও ঠেলে বের করে দেওয়া হয় না।
FP8-এ অ্যাঙ্কর, TQ3-এ আর্কাইভ
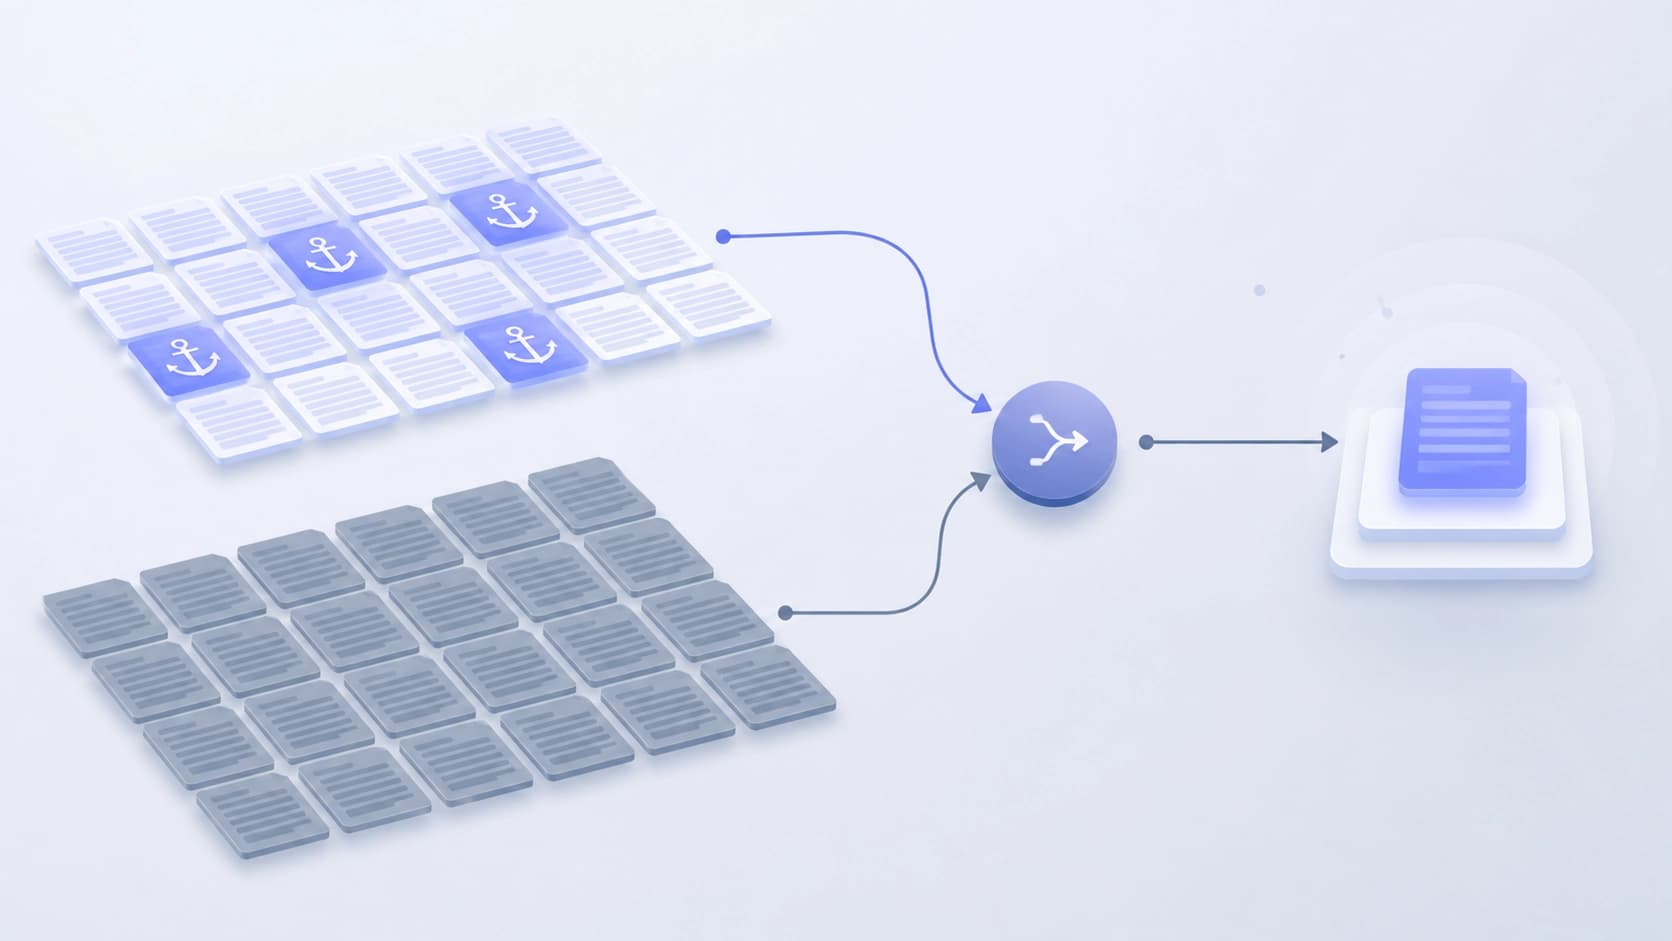
বিভাজনের যুক্তি সরল। যে পৃষ্ঠাগুলো সম্প্রতি ব্যবহৃত হয়েছে এবং সুরক্ষিত (anchor) হিসেবে চিহ্নিত, সেগুলো FP8-এ থাকে। আরও পুরনো, অ্যাঙ্করভুক্ত না হওয়া পৃষ্ঠাগুলো packed TQ3-এ রূপান্তরিত হয় — আরও ঘন প্যাকড ফরম্যাট। তবুও সক্রিয় অনুরোধের প্রতিটি পৃষ্ঠা আগের মতোই সরাসরি অ্যাড্রেস করা যায়: অ্যাড্রেস স্পেস থেকে কিছুই ফেলে দেওয়া হয় না বা আনুমানিক কপি দিয়ে প্রতিস্থাপন করা হয় না।
আংশিক ফলাফল কীভাবে জোড়া লাগে
সবচেয়ে মজার অংশ হলো অ্যারিথমেটিক। প্রতিটি ফরম্যাটের জন্য আলাদা কার্নেল নিজেদের আংশিক অ্যাটেনশন অবস্থা গণনা করে, তারপর সেগুলো একটি বিশ্বব্যাপী স্বাভাবিকীকৃত online-softmax merge-এর মাধ্যমে একত্রিত হয়। সহজ কথায়: গণনার আগে সব পৃষ্ঠাকে একই ধরনে রূপান্তর করার বদলে, সিস্টেম প্রতিটি গোষ্ঠীর অবদান তার নিজস্ব ফরম্যাটে গণনা করে এবং স্বাভাবিকীকৃত ফলাফলগুলো সঠিকভাবে যোগ করে।
এর 덕 덕ে ডিকোডিং সরাসরি অসমসত্ত্ব ক্যাশে জুড়ে চলে, তথাকথিত ঘন ছায়া (dense shadow) ছাড়াই — একক ফরম্যাটে ক্যাশের সম্পূর্ণ কপি, যা মেমোরি সাশ্রয়ের পুরো সুবিধা নষ্ট করে দিত।
পরিমাপ কী দেখায়
মেমোরি ও সংকোচন
পরিমাপগুলো করা হয়েছে Qwen3.6-27B মডেলের একটি নির্দিষ্ট কনফিগারেশনের সাথে সম্পর্কিত প্রোফাইলে, একটি NVIDIA RTX PRO 6000 Blackwell অ্যাক্সিলারেটরে ৯৬ জিবি মেমোরিসহ। ফলাফল — প্রতি সক্রিয় টোকেনে ১৮.৩ কি-বি অ্যাটেনশন KV। এটি BF16-এর তুলনায় ৩.৫০x সংকোচন এবং FP8-এর তুলনায় ১.৭৫x।
দ্বিতীয় সংখ্যাটি প্রথম দর্শনে যতটা মনে হয় তার চেয়ে বেশি গুরুত্বপূর্ণ। FP8-এর সাথে তুলনা দেখায় যে লাভটি কেবল অর্ধ-নির্ভুলতা থেকে আরও সাশ্রয়ী ফরম্যাটে যাওয়ার মাধ্যমেই আসে না, বরং নির্দিষ্টভাবে হাইব্রিড স্টোরেজ স্কিমের মাধ্যমেই আসে।
দীর্ঘ প্রসঙ্গে গুণমান
মেটেরিয়ালাইজিং প্রোফাইল — যেখানে হাইব্রিড পৃষ্ঠাগুলো সত্যিই টেনসরে রূপান্তরিত হয় — 16K-এ RULER needle-in-a-haystack কার্যগুলোতে তার ঘন নিয়ন্ত্রণের সাথে মিলে গেছে। অর্থাৎ খড়ের গাদায় সুচ খোঁজার ক্ষেত্রে কোনো পার্থক্য পাওয়া যায়নি।
এরপর শুরু হয় আপস। LongBench v2-এর ৫০৩টি প্রশ্নের সেটে ডেল্টাগুলো ঋণাত্মক হয়েছে: 16K-এ -০.৮০ শতাংশ পয়েন্ট, 32K-এ -০.৬০ এবং 64K-এ -০.৪০। বক্ররেখার আকারে লক্ষ্য করুন — ক্ষতিগুলো প্রসঙ্গের দৈর্ঘ্যের সাথে রৈখিকভাবে বাড়ে না, বরং সামান্য ওঠানামা করে। লেখকেরা কোনো ব্যাখ্যা দেননি, তবে ব্যাখ্যার সময় এই তথ্যটি মাথায় রাখা উচিত: শতাংশের ভগ্নাংশের এই তারতম্য সহজেই পরিমাপের শব্দের সাথে গুলিয়ে ফেলা যায়।
ক্যানারি পরীক্ষা
আলাদা একটি পরীক্ষা — single-pair canary, যেখানে প্রতিটি ৫৯,০০৮ টোকেনের অনুরোধসহ দুটি সরাসরি ডিকোডিং তুলনা করা হয়েছে। ফলাফল: সক্রিয় KV ৩.৬২৫ গুণ সংকুচিত হয়েছে, থ্রুপুট নিয়ন্ত্রণের তুলনায় ০.৯৮২১x হয়েছে, সম্পূর্ণ অ্যাটেনশনের সব ১৬টি স্তর ঘন মোডে fallback ছাড়াই রাউট হয়েছে, এবং কোনো ঘন ছায়া সংরক্ষিত হয়নি।
থ্রুপুট একের সামান্য কম — এটি মূলত একটি সৎ বিনিময়: দখলকৃত মেমোরির বহুগুণ হ্রাসের বিনিময়ে প্রায় দুই শতাংশ গতি।
সিদ্ধান্ত ও সতর্কতা
লেখকদের ঘোষিত সিদ্ধান্তটি সতর্ক: ফলাফলগুলো দেখায় সক্রিয় অনুরোধের পৃষ্ঠাগুলো ঠেলে না দিয়ে মিশ্র ফরম্যাটে দীর্ঘ-প্রসঙ্গ অবস্থা সংকুচিত করার একটি ব্যবহারিক পথ। পূর্ববর্তী পদ্ধতিগুলোতে ঠিক এটিই অভাব ছিল — এমন সংকোচন, যা পুরনো ডেটার জন্য সাম্প্রতিক ডেটা বিসর্জন দেয় না।
পড়ার সময় যা বিবেচনায় রাখা উচিত:
- পরীক্ষার প্রোফাইলগুলো কনফিগারেশনের সাথে সম্পর্কিত। এখানে নির্দিষ্ট মডেল ও নির্দিষ্ট অ্যাক্সিলারেটরের কথা বলা হচ্ছে; সংখ্যাগুলোর অন্য আর্কিটেকচারে স্থানান্তরযোগ্যতা দেখানো হয়নি।
- ক্যানারি পরীক্ষা সংকীর্ণ। একটি অনুরোধ-জোড়া, সরাসরি ডিকোডিংয়ের একটি দৃশ্যপট — এটি কার্যকারিতার একটি দৃষ্টান্ত, লোডের পরিসংখ্যান নয়।
- LongBench v2-তে পতন শূন্য নয়। শতাংশ পয়েন্টের ভগ্নাংশ — সামান্য, কিন্তু যেসব কার্যে প্রতিটি নির্ভুলতা-একক গুরুত্বপূর্ণ, সেখানে এটি নিজস্ব পরিমাপের কারণ হয়ে দাঁড়ায়।
- প্রোডাকশন পরিস্থিতিতে বিলম্বের কোনো ডেটা নেই। ক্যানারি পরীক্ষায় থ্রুপুট, বর্ণনা অনুযায়ী, সম্পূর্ণভাবে ১৬টি স্তর দিয়ে যায় reserve-পথ ছাড়াই — কৌতূহলজনক, সবচেয়ে খারাপ পরিস্থিতিতে রাউটিং কেমন আচরণ করবে, যখন অ্যাঙ্কর পৃষ্ঠার সংখ্যা স্বাভাবিকের চেয়ে বেশি হয়ে যায়।
কাজটির ব্যবহারিক মূল্য রেকর্ড-ভাঙা সংকোচন সংখ্যায় নয়, বরং অন্য কিছুতে: এটি দেখায় যে ভিন্নধর্মী ক্যাশে সরাসরি পরিবেশন করা সম্ভব, প্রতিটি ধাপের জন্য তার সম্পূর্ণ কপি না জড়ো করেই। যদি এই পদ্ধতি অন্য মডেলেও স্থানান্তরযোগ্য হয়, তবে দীর্ঘ-প্রসঙ্গ দৃশ্যপটে হার্ডওয়্যার স্কেলিংয়ের পাশাপাশি আরেকটি লিভার যুক্ত হয়।


