
কেন "দেখাও কোথায় আছে" — ভুল প্রশ্ন
ক্লাসিক ভিজ্যুয়াল গ্রাউন্ডিং পরীক্ষাটি প্রায় স্কুলের মতোই দেখতে: একটি ছবি দেওয়া হয় এবং "নিচের তাকে নীল ফোল্ডার" এর মতো একটি বাক্য, আর মডেলকে নির্দেশ করতে হয় লক্ষ্য বস্তুটি কোথায় অবস্থিত। একটি প্রশ্ন, একটি উত্তর, মেট্রিক — পেয়েছে কি পায়নি।
স্কিমটি সুবিধাজনক, কিন্তু এটি কথোপকথন নয়, একটি কমান্ড বর্ণনা করে। জীবন্ত যোগাযোগে মানুষ প্রথমবারেই সম্পূর্ণ বর্ণনা দেয় না। সে বলে "ওই জিনিসটা জানালার পাশে" এবং আশা করে যে собеседник হয় অনুমান করবে, নয় আবার জিজ্ঞাসা করবে। পারস্পরিক বোঝাপড়া সংলাপের ধারাবাহিকতায় গড়ে ওঠে — কখনও দুই ধাপে, কখনও পাঁচ ধাপে।
arXiv:2608.23978 গবেষণাপত্রের লেখকরা (Zhengxiang Wang এবং Owen Rambow, নিবন্ধটি EMNLP 2026-এ গৃহীত) এই বাদ পড়া পর্যায়টিকেই পরিমাপের বিষয় হিসেবে বিবেচনা করার প্রস্তাব দেন। তাদের প্রশ্নটি হলো: মডেল কি শুধু দেখতে জানে, নাকি যখন ছবি ও শব্দ স্পষ্ট সিদ্ধান্তের জন্য যথেষ্ট নয় তখন জিজ্ঞাসা করতেও জানে।
পরীক্ষাটি কীভাবে সাজানো
নিয়ন্ত্রিত তথ্যের ঘাটতি
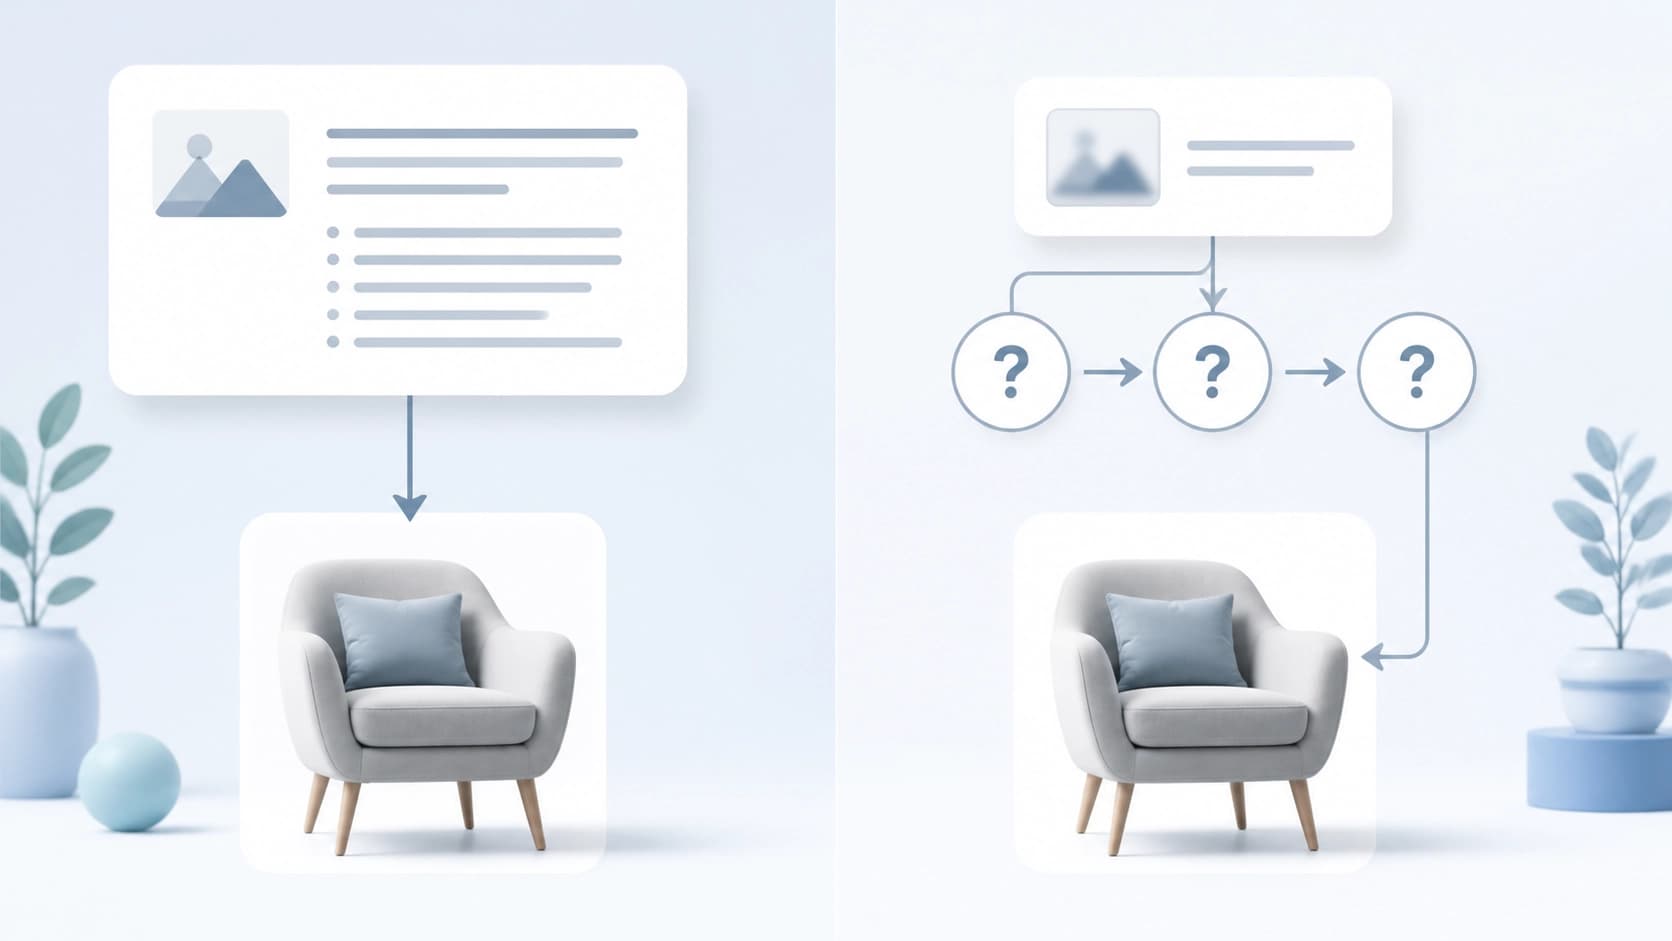
মূল ধারণা হলো "গড়ে" নির্ভুলতা পরিমাপ করা নয়, বরং লক্ষ্য সম্পর্কে আগে থেকে কতটা তথ্য দেওয়া হয়েছে এবং কতটা মডেলকে নিজেই সংগ্রহ করতে হবে তা মসৃণভাবে নিয়ন্ত্রণ করা। স্কেলের এক প্রান্তে কাজটি সাধারণ একধাপের পরীক্ষার থেকে প্রায় আলাদা নয়: বর্ণনা বিস্তারিত, লক্ষ্য স্পষ্ট। অন্য প্রান্তে প্রাথমিক বাক্যটি একেবারেই নেই, এবং লক্ষ্য বস্তু সম্পর্কে মডেল যা জানে তা তার নিজের স্পষ্টীকরণমূলক প্রশ্ন থেকে বের করে আনতে হবে।
এই গঠনটি চেনার দক্ষতাকে সংলাপ পরিচালনার দক্ষতা থেকে আলাদা করতে দেয়। যে মডেল সঠিক সূত্রে বস্তুটি নিখুঁতভাবে খুঁজে পায়, সেটি সম্পূর্ণভাবে ব্যর্থ হতে পারে যখন সূত্রটি টুকরো টুকরো করে জোগাড় করতে হয়।
চারটি প্রসঙ্গ এবং চারটি প্রোটোকল
পরীক্ষামূলক পরিবেশ চারটি ভিজ্যুয়াল প্রসঙ্গের উপর নির্ভর করে, যা মানব পরিস্থিতির কাছাকাছি, এবং চারটি ভিন্ন মিথস্ক্রিয়া প্রোটোকল। এটি গুরুত্বপূর্ণ: ফলাফল একটি সফল বা ব্যর্থ কনফিগারেশনে সীমাবদ্ধ নয়। একই সাথে পরীক্ষা করা হয়েছিল কে বর্ণনাটি তৈরি করে — মানুষ নাকি অন্য একটি মডেল, এবং সেইসাথে যুক্তির পরিমাণ, পুনরায় চেষ্টা এবং বর্ণনা সরবরাহকারী পরিবর্তনের প্রভাব কী। নিচে যে নিয়মিততাগুলোর কথা বলা হয়েছে তা এই সমস্ত বৈচিত্র্যে পুনরুৎপাদিত হয়েছে।
কোথায় ঠিক ভেঙে পড়ে
মানুষের সাথে ব্যবধান সব প্রোটোকলেই টিকে থাকে
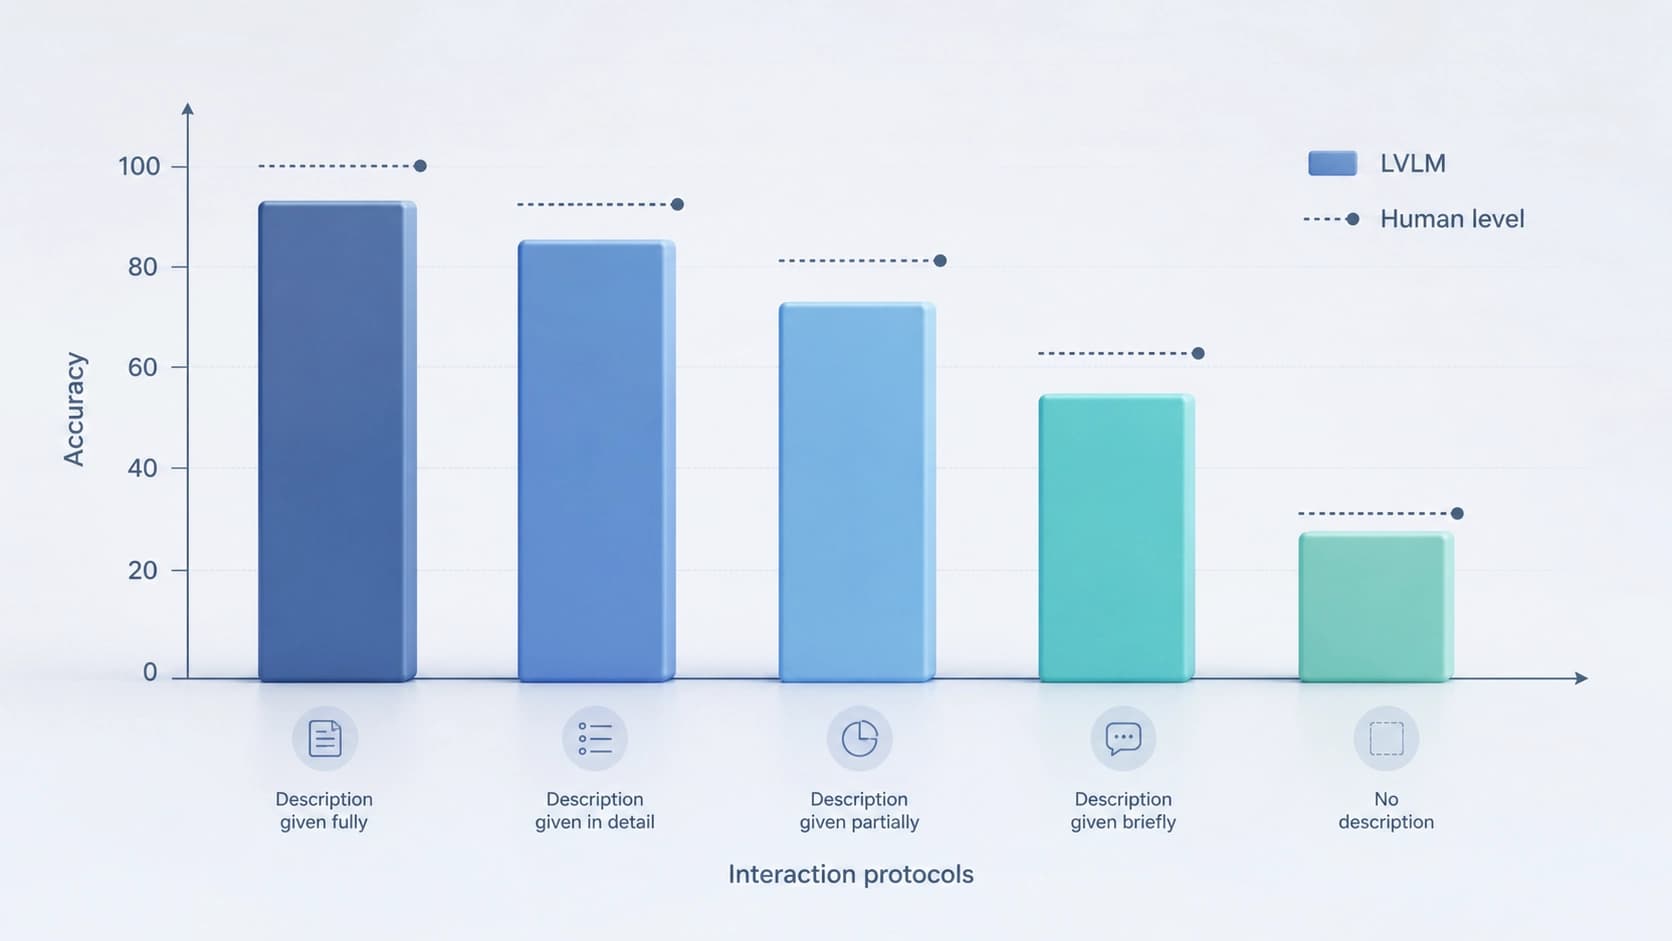
মূল সিদ্ধান্তটি সুখকর নয়: কোনো মোডেই বর্তমান বড় ভিজ্যুয়াল-ভাষা মডেলগুলো মানুষের বেসলাইন স্তরের কাছাকাছি পৌঁছায়নি। ব্যবধানটি তখনও টিকে থাকে যখন কাজটি প্রায় তুচ্ছ মনে হয়, এবং তখনও যখন এটি প্রকৃত সংলাপ দাবি করে। বিষয়টি কয়েক শতাংশ পয়েন্টের নয়, বরং নির্ভরযোগ্যতায় গুণগত পার্থক্যের।
সবচেয়ে খারাপ — যখন বর্ণনা একেবারেই নেই
সবচেয়ে নিম্ন ফলাফল নথিভুক্ত হয়েছে সেই পরিস্থিতিতে যেখানে লক্ষ্যের প্রাথমিক বাক্য অনুপস্থিত। মডেলকে নিজেই অনুমান করতে হয় কী খুঁজবে, প্রশ্ন করতে হয় এবং উত্তর থেকে অনুসন্ধানের পরিধি সংকুচিত করতে হয়। এটি আর চেনার বিষয় নয়, বরং সক্রিয় আচরণের বিষয়: নিজেই সিদ্ধান্ত নিতে হবে যে তথ্যের ঘাটতি আছে, এবং এমন একটি অনুরোধ তৈরি করতে হবে যা সেই ঘাটতি পূরণ করবে।
এখানেই সেই ব্যর্থতা প্রকাশ পায় যা গবেষণাপত্রের শিরোনামে রয়েছে: মডেল দেখতে জানে, কিন্তু জিজ্ঞাসা করতে জানে না। সে হয় অনুমানের উপর ভরসা করে, নয় এমন প্রশ্ন করে যা কিছুই স্পষ্ট করে না।
স্পষ্টীকরণ কাজ করে, কিন্তু সবসময় নয়
মিথস্ক্রিয়া অকেজো নয়। যখন স্পষ্টীকরণমূলক প্রশ্ন প্রাথমিক বর্ণনাকে সংশোধন বা সম্পূরক করে, তখন নির্ভুলতা লক্ষণীয়ভাবে বাড়ে। অর্থাৎ সংলাপের প্রক্রিয়া মডেলে উপস্থিত এবং উপকার আনে — কিন্তু শুধুমাত্র অন্যের বাক্যের সম্পাদকের ভূমিকায়। যেই মাত্র বাক্যটি শূন্য থেকে তৈরি করতে হয়, সুবিধাটি অদৃশ্য হয়ে যায়।
আত্মবিশ্বাস নির্ভুলতার আগে
বিশ্লেষণের একটি পৃথক ধারা — ক্যালিব্রেশন। মডেলগুলো পদ্ধতিগতভাবে তাদের প্রকৃত নির্ভুলতা যা নিশ্চিত করে তার চেয়ে বেশি আত্মবিশ্বাস প্রকাশ করে। বাস্তবে এর অর্থ হলো মডেলের উত্তরের ভিত্তিতে বিচার করা যায় না যে তাকে বিশ্বাস করা উচিত কি না: সঠিক এবং ভুল উভয় পছন্দই সমান উৎসাহী ভঙ্গিতে থাকে।
অ্যাপ্লিকেশনের জন্য এটি কেবল ভুলের চেয়ে বেশি বিপজ্জনক। যদি সিস্টেম ভুল করে কিন্তু অনিশ্চয়তা সম্পর্কে সৎভাবে সংকেত দেয়, তাকে আবার জিজ্ঞাসা করা যায় বা কোনো মানুষকে ডাকা যায়। যদি সে দৃঢ় ভঙ্গিতে ভুল করে — এমন সুরক্ষা তৈরি করা সম্ভব হয় না।
কেন কাজটি যতটা মনে হয় তার চেয়ে কঠিন
ইন্টারঅ্যাক্টিভ ভিজ্যুয়াল গ্রাউন্ডিংয়ের জন্য একসাথে তিনটি প্রক্রিয়ার কাজ প্রয়োজন:
- ভিজ্যুয়াল মিলকরণ — শব্দগুলোকে ছবির বস্তুর সাথে সংযুক্ত করা, স্থানিক সম্পর্ক এবং বৈশিষ্ট্যসহ;
- তথ্য অনুসন্ধান — কোন তথ্যের ঘাটতি আছে তা বোঝা এবং ব্রুট-ফোর্সের বদলে প্রশ্নের মাধ্যমে তা পাওয়া;
- সংশ্লেষণ — বিচ্ছিন্ন উত্তরগুলোকে একটি একক অনুমানে সংহত করা এবং পথে তা হারিয়ে না ফেলা।
আধুনিক মডেলের প্রতিটি দক্ষতা আলাদাভাবে কমবেশি আছে। ভেঙে পড়ে তাদের সংযোগস্থল: যা দেখা হয়েছে তা প্রশ্নে রূপান্তরিত হয় না, আর প্রশ্নের উত্তর বিশ্বদৃষ্টিকে পুনর্গঠিত করে না।
বাস্তবে এর অর্থ কী
যদি আপনি একটি মাল্টিমোডাল মডেলের উপর ভিত্তি করে পণ্য তৈরি করেন — ধরা যাক, GPT-4o বা ছবি সমর্থনকারী যেকোনো অন্য API — তবে গবেষণাপত্রের সিদ্ধান্তগুলো সহজেই ইঞ্জিনিয়ারিং সমাধানে রূপান্তর করা যায়:
- প্রথম বর্ণনার উপর ভরসা করবেন না। যদি ব্যবহারকারী অস্পষ্টভাবে অনুরোধ করেন, তবে একক প্রশ্ন-উত্তরের বদলে স্পষ্টীকরণের একটি চক্র রাখুন।
- ঘোষিত আত্মবিশ্বাসে বিশ্বাস করবেন না। নির্দিষ্ট কাজের জন্য নিজের লেবেলিংয়ের উপর ক্যালিব্রেশন তৈরি করা ভালো, মডেলের আত্মমূল্যায়নের উপর নয়।
- মডেলের হয়ে প্রশ্ন ডিজাইন করুন। যদি সিস্টেম নিজে বুঝতে না পারে তার কী ঘাটতি আছে, তবে জিজ্ঞাসাকারীর ভূমিকা বাইরের লজিক স্তরকে নিতে হবে।
- নিজের তথ্যের ঘাটতিতে পরীক্ষা করুন। পাইপলাইন ঠিক সেই মোডগুলোতে কেমন আচরণ করে তা পরীক্ষা করা উপকারী, যেখানে লেখকদের তথ্য অনুযায়ী নির্ভুলতা ভেঙে পড়ে।
সারসংক্ষেপ
গবেষণাটি সামর্থ্যের অভাব নয়, বরং দক্ষতার অমিল নথিভুক্ত করে। মডেলগুলো ভালোভাবে করা প্রশ্নের উত্তর দেওয়ার জন্য যথেষ্ট দেখে, কিন্তু নিজেরাই প্রশ্ন করার মতো পরিস্থিতি বোঝে না। যতদিন এই ব্যবধান বন্ধ না হবে, ইন্টারঅ্যাক্টিভ ভিজ্যুয়াল গ্রাউন্ডিং এমন একটি কাজ থাকবে যেখানে মানুষ সংলাপের সবচেয়ে নির্ভরযোগ্য সূত্র হয়ে থাকে।


