
CANDOR: এনকোডারের দুর্বলতাকে সাধারণ ক্লাস-অসামঞ্জস্য থেকে আলাদা করার মেট্রিক
ফ্রোজেন এনকোডারগুলোকে সাধারণত তাদের ফিচারগুলোর ওপর হালকা ওভারহেডের গুণমান দিয়ে তুলনা করা হয়, যদিও এতে রিপ্রেজেন্টেশনের জ্যামিতি নিজেই মূল্যায়নের বাইরে থেকে যায়। নতুন মেট্রিক CANDOR প্রতিবেশী ব্যাংকগুলোকে আকারে সমান করে, যার ফলে রেফারেন্স পয়েন্টটি ন্যায্য কয়েন টসের সঙ্গে মিলে যায়, এবং তখন চিত্রটি বদলে যায়: অন্ধ মডেল নেই, তবে স্পষ্টভাবে দুর্বল মডেল প্রায় সর্বত্রই আছে।
এনকোডার নির্বাচনের মাপকাঠি ভুল জায়গায় খোঁজা হচ্ছে
ফ্রোজেন এনকোডার সাধারণত প্রকল্পে নেওয়া হয় একটি বিষয় দেখে: তার রিপ্রেজেন্টেশনের উপরে একটি হালকা হেড — লিনিয়ার লেয়ার, ছোট MLP, বা এই ধরনের কিছু — কতটা ভালোভাবে শিখতে পারে। যদি সাধারণ হেড প্রয়োজনীয় ফিচার বের করে আনতে পারে, তবে এনকোডারকে সফল ধরা হয়। কিন্তু এই মূল্যায়ন উত্তর দেয় "এই এমবেডিং থেকে কিছু পড়া সুবিধাজনক কি না" — এই প্রশ্নের, "স্পেসের জ্যামিতি নিজেই কি ফিচারটিকে আলাদা করে" — সেই প্রশ্নের নয়। এরা দুটি ভিন্ন প্রশ্ন, এবং এদের গুলিয়ে ফেলা ব্যয়বহুল: যতক্ষণ কাজগুলো সহজ এবং ক্লাস সংখ্যা কম, ততক্ষণ হেড রিপ্রেজেন্টেশনের দুর্বলতাকে ঢেকে রাখে।
আলাদাভাবে ভারসাম্যের সমস্যাটি রয়েছে। যতক্ষণ ক্লাসগুলো মোটামুটি সমান, ততক্ষণ "এনকোডার পারে" এবং "হেড বের করে আনে"-এর মধ্যে পার্থক্য প্রায় দেখা যায় না। কিন্তু একটি ক্লাস বিরল হয়ে গেলেই নিকটতম প্রতিবেশী-ভিত্তিক মেট্রিকগুলো systematically মিথ্যা বলতে শুরু করে।
নিকটতম প্রতিবেশী-ভিত্তিক ডিসকর্ড্যান্স কেন মিথ্যা বলে
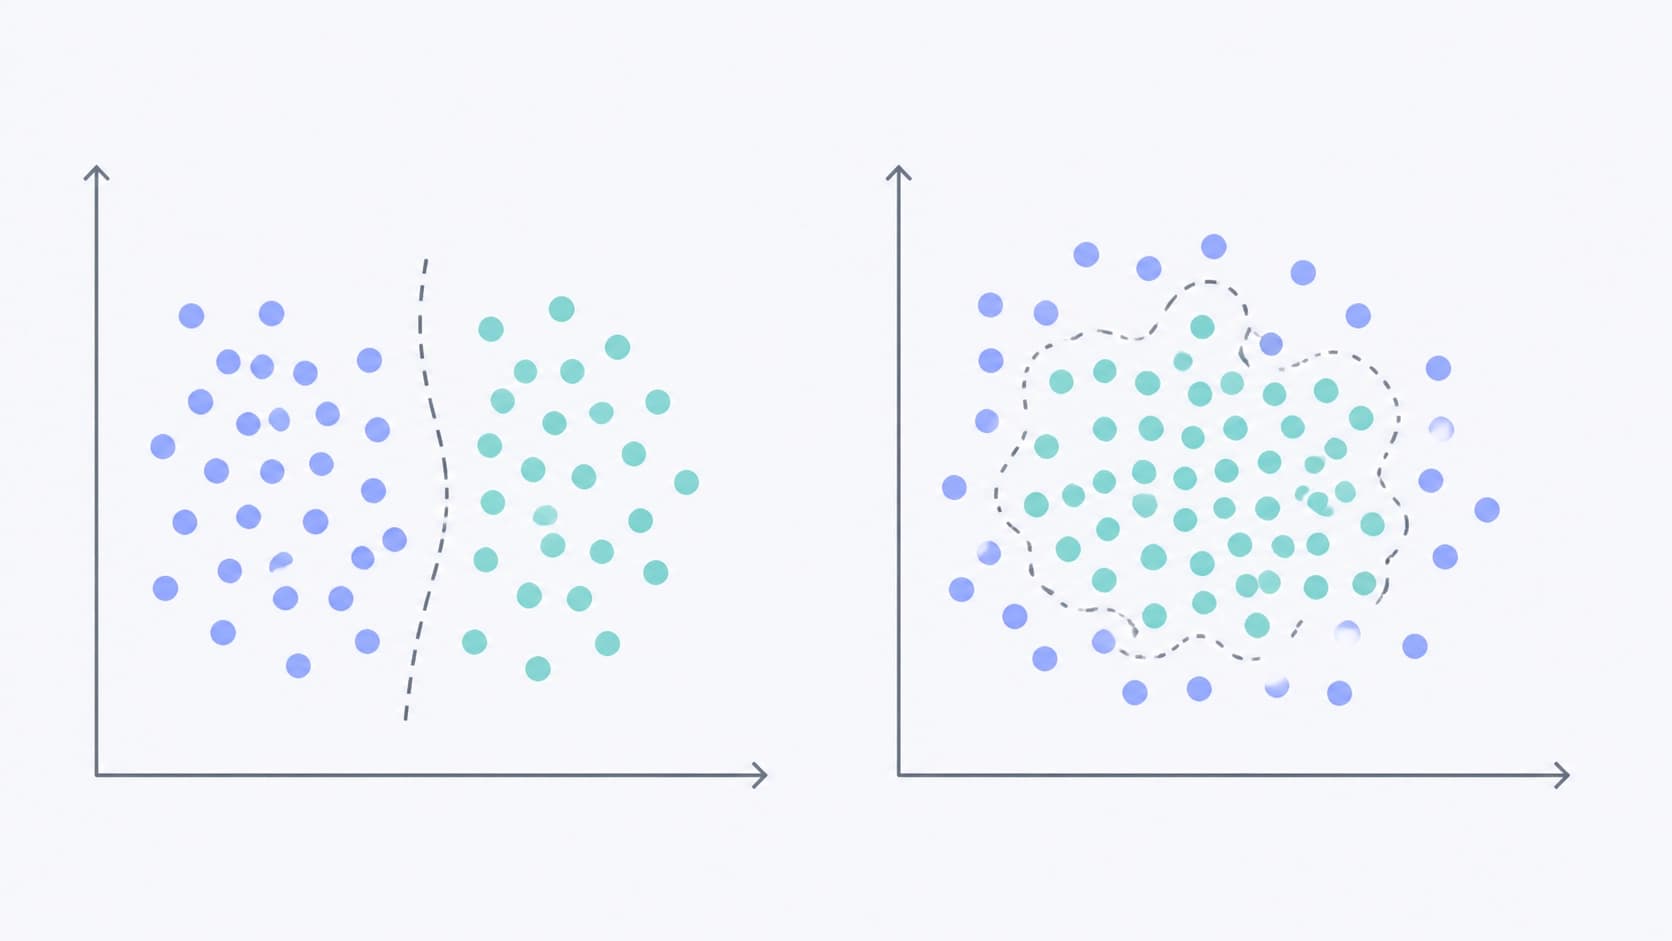
ক্লাসিক ডিসকর্ড্যান্স মেট্রিক সহজভাবে গঠিত: প্রতিটি পয়েন্টের জন্য এমবেডিং স্পেসে প্রতিবেশী খোঁজা হয়, এবং যদি নিকটতম প্রতিবেশীর লেবেল বিপরীত হয় — ঘটনাটিকে ডিসকর্ড্যান্ট হিসেবে লিপিবদ্ধ করা হয়। একই ক্লাসের ভেতরে জ্যামিতি দুর্দান্ত কাজ করে, প্রতিবেশীদের নিয়ে কোনো অভিযোগ নেই।
সমস্যাটি পদ্ধতির অসমতায়। যখন পজিটিভ ও নেগেটিভ উদাহরণের জন্য প্রতিবেশী ভিন্ন আকারের সেট থেকে সংগ্রহ করা হয়, তখন বিপরীত লেবেলের নিকটতম প্রতিবেশী জিতে যায় এই কারণে নয় যে জ্যামিতি এমন, বরং এই কারণে যে তার ক্লাসটি আশপাশে বেশি ঘনভাবে অবস্থান করে। অন্য কথায়, ফলাফলে ক্লাসের প্র prevalens (prevalence) — ডেটাসেটের পরিসংখ্যান, রিপ্রেজেন্টেশনের বৈশিষ্ট্য নয় — চুপিসারে ঢুকে পড়ে। প্রভাবটি অপ্রীতিকর: সম্পূর্ণ অ-সচেতন এনকোডার অন্ধ বলে দেখাতে শুরু করে, যদিও বাস্তবে এটি ঠিক ততটাই অকেজো যতটা একটি সৎ মুদ্রা, এবং তার চেয়ে খারাপ নয়।
CANDOR ঠিক কী বদলায়
CANDOR — Chance-Calibrated Discordance in Frozen Foundation Encoders — গণনার পদ্ধতিটিকেই নতুন করে সংজ্ঞায়িত করে। এখানে প্রতিবেশী ব্যাংক সমান আকারে সংগ্রহ করা হয়, এবং মেট্রিকের গঠন লেবেলের স্থানবিনিময়ের সাপেক্ষে প্রতিসম: পজিটিভ ও নেগেটিভের স্থান বদলান, মান বদলাবে না। ফলস্বরূপ, এলোমেলো অনুমানের স্তর ঠিক এক-দ্বিতীয়াংশে — 50%-এ — স্থির। "প্রায় অর্ধেকের কাছাকাছি, ডেটাসেটের উপর নির্ভর করে" নয়, বরং 1/2-এ একটি কঠোর সূচনা বিন্দু।
এটি কোনো প্রসাধনী সংশোধন নয়। ঠিক এই ভাসমান সূচনা বিন্দুই এনকোডারগুলোকে পরস্পরের সাথে এবং ডেটাসেটগুলোর মধ্যে তুলনা করতে বাধা দিচ্ছিল: যেখানে ভারসাম্যহীনতা বেশি, সেখানে এলোমেলো অনুমান আসলে যতটা খারাপ তার চেয়ে আরও খারাপ দেখাচ্ছিল, এবং মডেল অযোগ্য আস্থার ক্রেডিট পাচ্ছিল। যখন সূচনা বিন্দু স্থির হয়, তুলনা সৎ হয়ে ওঠে।
আরও একটি বিষয় ব্যবহারিক দৃষ্টিতে গুরুত্বপূর্ণ: যেহেতু সূচনা বিন্দু স্থির, CANDOR যেকোনো হেড প্রশিক্ষণের আগেই গণনা করা যায়। কোনো ফাইনটিউনিং নেই, কোনো হাইপারপ্যারামিটার টিউনিং নেই — মেট্রিকটি রিপ্রেজেন্টেশনগুলোকে নিজেদেরই বর্ণনা করে এবং আগেই ইঙ্গিত দেয় কোন নির্দিষ্ট ফ্রোজেন এনকোডার কোন আবিষ্কারগুলো খারাপভাবে সমর্থন করে।
স্কেলে যাচাই
লেখকরা মূল্যায়ন চালিয়েছেন ব্যাপকভাবে: ২২টি এনকোডার, ৭টি বিষয়ভিত্তিক ডোমেইনের ২০টি ডেটাসেট, মোট ৬০৫,৪৪৩টি ছবি। এই বিশাল পরিসর ঠিক এই কারণেই প্রয়োজন ছিল — মেট্রিকের প্রভাবকে একটি কাজের বিশেষত্ব থেকে আলাদা করার জন্য।
ফলাফলটি পুরনো পদ্ধতি যে সিদ্ধান্তে পৌঁছাত, তা উল্টে দেয়। সংশোধনের পর রিপ্রেজেন্টেশনের কোলাপ্স প্রায় সর্বত্র এলোমেলো অনুমানের স্তরের নিচে থাকে। এর অর্থ দাঁড়ায়: পরীক্ষিত এনকোডারগুলোর একটিও অন্ধ নয় — রিপ্রেজেন্টেশনে ফিচারের তথ্য আছে — কিন্তু সবগুলোই দুর্বল। "সবাই দুর্বল, কেউ অন্ধ নয়" — এই বাক্যটি আগেরটির চেয়ে কোমল শোনায়, এবং একইসাথে বাস্তবতাকে অনেক বেশি নিখুঁতভাবে বর্ণনা করে।
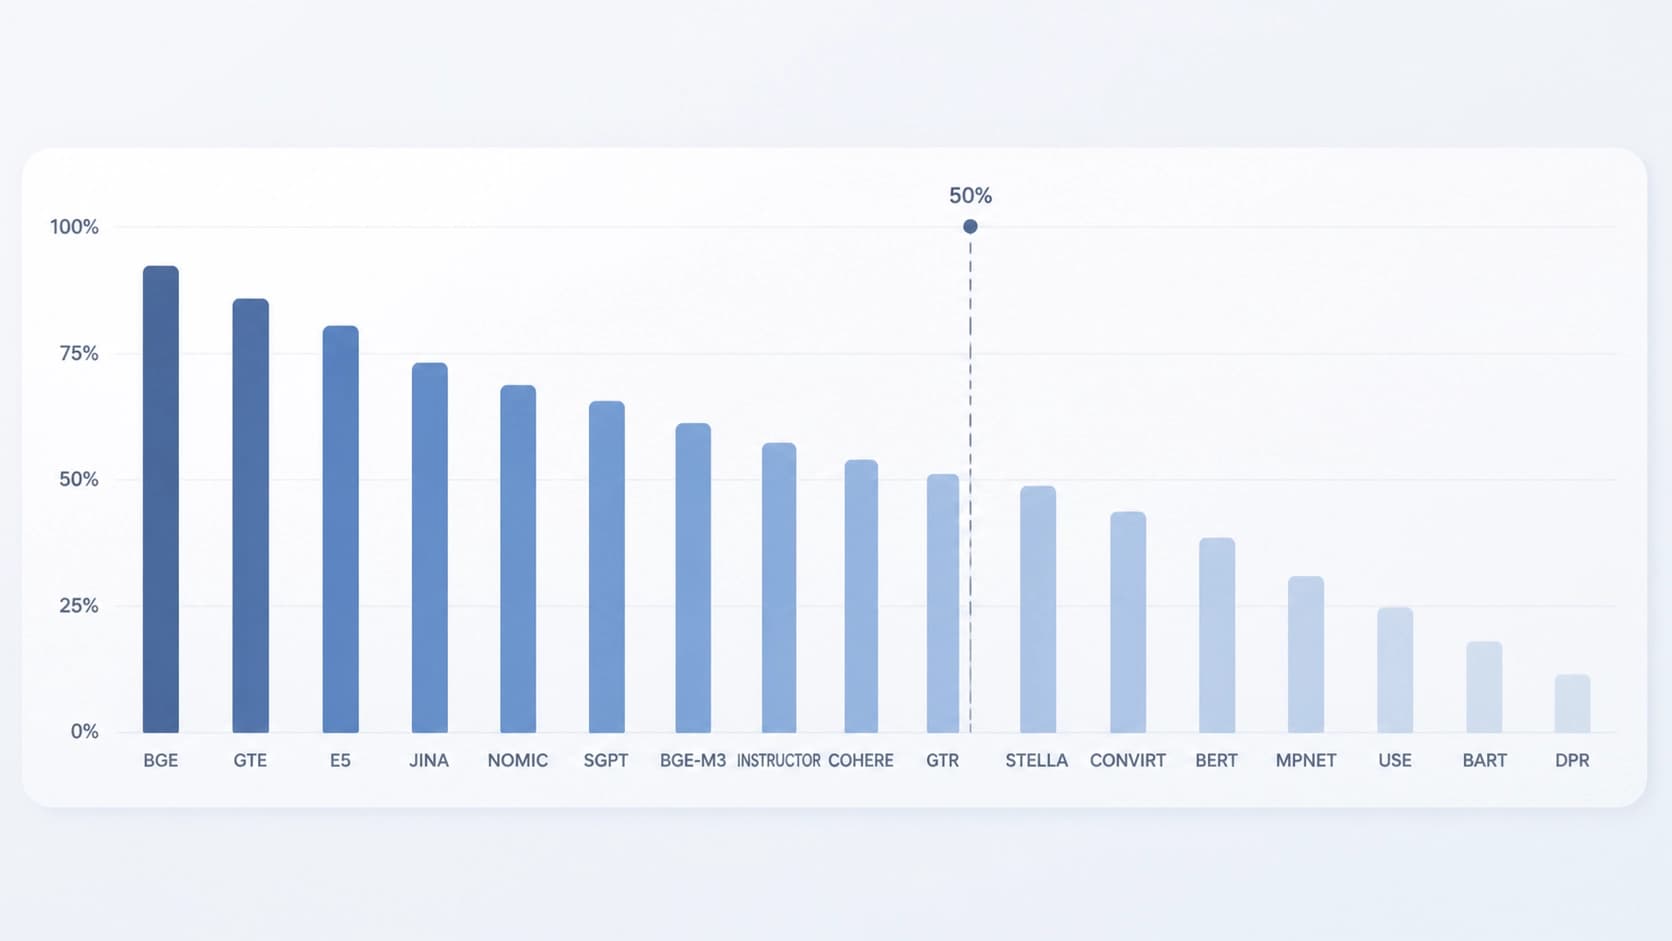
ক্লিনিক্যাল উদাহরণ: দুর্বল জ্যামিতিতে শক্তিশালী হেড
সবচেয়ে স্পষ্ট দৃষ্টান্ত — মেডিকেল ইমেজিং। বুকের জন্য সেরা মডেল নিউমোথোরাক্স পড়ে AUROC ৮৪.৫ দিয়ে। সংখ্যাটি যথেষ্ট শক্ত, এবং মডেল নির্বাচনের সময় সাধারণত এটিই দেখা হয়। কিন্তু একই মডেল ১৮.৪% পজিটিভ কেসকে বিপরীত লেবেলের ছবির নিকটবর্তী স্থানে রাখে, একই ফাইন্ডিংযুক্ত নিজের ছবির চেয়ে — একই হাসপাতালের মধ্যে, অর্থাৎ ব্যাখ্যা হিসেবে ডোমেইন শিফট ছাড়াই।
"হেড ভালোভাবে কাজ সমাধান করে" এবং "জ্যামিতি পজিটিভ ও নেগেটিভকে গুলিয়ে ফেলে"-এর মধ্যেকার ফাঁকটিই হলো সেই বিচ্যুতি। হেড দুর্বল রিপ্রেজেন্টেশন পুষিয়ে দেয়; CANDOR মেট্রিক দেখায় যে পুষিয়ে দিতে হয় অনেকটাই।
এরপর — ডোমেইনগুলোর মধ্যে তুলনা। একই এনকোডার পাখির প্রজাতি আলাদা করে ৪.৫ স্তরে (অর্থাৎ প্রায় নিখুঁতভাবে), কিন্তু বুকের ফাইন্ডিংগুলো ৪২.৮-এ, গ্লুকোমা ৪৯.৮-এ রেখে দেয়। শেষ সংখ্যাটি এলোমেলো অনুমানের স্তরে দাঁড়িয়ে, এবং আসলে — এলোমেলো ওজনের চেয়েও খারাপ। এক এনকোডার, এক প্রশিক্ষণ, তিনটি সম্পূর্ণ ভিন্ন মানের জ্যামিতি।
তথ্যের নয়, নির্বাচনের ঘাটতি
এখান থেকে স্বাভাবিক প্রশ্ন ওঠে: তাহলে রিপ্রেজেন্টেশনগুলো কি আশাহীন? তেমন নয়। কেসটি যেকোনো লিপশিৎজ হেডের নরমালাইজড মার্জিন (normalized margin) সীমাবদ্ধ করে — অর্থাৎ এমন হেড যার ইনপুটের সরণের প্রতি সংবেদনশীলতা সীমিত। তবে এগারোটি হেডের সেটের মধ্যে এমন একটি আছে যা ২.৮% ছাড়া সব ক্ষেত্রেই সঠিক, অথচ আলাদাভাবে নেওয়া একটি হেড ৩৫.৯%-এ ভুল করে। রিপ্রেজেন্টেশনে ফিচারের তথ্য আছে — এটি কেবল বিভিন্ন পাঠক-যন্ত্রের কাছে অসমভাবে доступ্য। অর্থাৎ ঘাটতিটি নির্বাচনের (selection) সাথে সম্পর্কিত, তথ্যের অভাবের সাথে নয়।
আকর্ষণীয় একটি সংযোগ অন্য জায়গাতেও পাওয়া গেছে: মুছে ফেলার সময় সংরক্ষণ (erasure retention) কোলাপ্সের সাথে সম্পর্কিত। কিন্তু প্রশিক্ষণের উদ্দেশ্য, মডেলের স্কেল, প্রকাশের সময়কাল বা ফাইন্ডিংয়ের আকারের সাথে কোনো সম্পর্ক পাওয়া যায়নি। সহজ কথায়, "বড় ও নতুন মডেল নিন" সমস্যাটি সমাধান করে না — এটি আকার বা বয়স নিয়ে নয়।
এর থেকে বাস্তবে কী দাঁড়ায়
তিনটি ব্যবহারিক সিদ্ধান্ত।
- হেড প্রশিক্ষণের আগেই CANDOR গণনা করুন। এটি একটি সস্তা যাচাই, যা দেখায় এনকোডার কোনো নির্দিষ্ট বিরল ফাইন্ডিং সমর্থন করে কি না, এবং টিউনিংয়ে সময় ব্যয় করার আগেই অনুপযুক্ত ব্যাকবোন বাদ দিতে দেয়।
- হেডের AUROC-কে রিপ্রেজেন্টেশনের গুণমানের সাথে গুলিয়ে ফেলবেন না। ১৮.৪% ডিসকর্ড্যান্ট পজিটিভের সাথে ৮৪.৫ — এটি স্বাভাবিক, বিরল নয় এমন পরিস্থিতি, এবং এটি আলাদাভাবে মাপার যোগ্য।
- স্কেল ও নতুনত্ব সবকিছু ঠিক করে দেবে বলে আশা করবেন না। আকার, প্রশিক্ষণের উদ্দেশ্য ও প্রকাশের সময়কালের সাথে কোনো সম্পর্ক পাওয়া যায়নি; ফ্রোজেন এনকোডারগুলোর দুর্বলতা সিস্টেমিক বলে মনে হচ্ছে।
এই গল্পের মূল মূল্য মেট্রিকটির মধ্যেই নয়, বরং উল্টে যাওয়া সিদ্ধান্তটির মধ্যে। আগে মনে হতো এনকোডারগুলো নির্দিষ্ট কিছু ক্লাসের প্রতি "অন্ধ"। শ্যান্স অনুযায়ী ক্যালিব্রেশনের পর অন্য কিছু স্পষ্ট হয়: তারা প্রায় সর্বত্র দেখে, কিন্তু সর্বত্র দুর্বলভাবে। এটি অনেক কম নাটকীয় এবং অনেক বেশি কার্যকর চিত্র — এটি দিয়ে বোঝা যায় কী মেরামত করতে হবে এবং কোন ক্রমে।
সাধারণ প্রশ্নোত্তর
বিভিন্ন উপাদান
সব উপাদান
MathAdv: মেশিন-উৎপন্ন প্রমাণের চূড়ান্ত নির্ভুলতার আড়ালে কী লুকিয়ে আছে
গণিতের ১৩টি বিশ্ববিদ্যালয় ও স্নাতকোত্তর শাখার কাজ নিয়ে তৈরি এই ডায়াগনস্টিক সেটটি Lean 4-এ মেশিন প্রুফ সিস্টেমকে শুধু চূড়ান্ত ফলাফলের ভিত্তিতে নয়, বিষয়জ্ঞান, অনানুষ্ঠানিক যুক্তির গুণমান এবং শর্তাবলি নতুনভাবে উপস্থাপন করা হলে তা সামাল দেওয়ার সক্ষমতার ভিত্তিতেও মূল্যায়ন করে। উপাদানভিত্তিক বিশ্লেষণে দেখা যায়, কোনো সমস্যাকে আনুষ্ঠানিক রূপে রূপান্তর করা এখনও প্রধান বাধা; আর সাফল্য গণিতের শাখা ও সমস্যা উপস্থাপনের পদ্ধতির ওপর অনেকটাই নির্ভর করে।
9 নভেম্বর 2026
AffordanceWAM: দৃশ্য পূর্বাভাস ও ম্যানিপুলেটর নিয়ন্ত্রণের মধ্যস্থতাকারী হিসেবে অ্যাফোর্ড্যান্সগুলি
এই কাজটিতে এমন একটি জেনারেটিভ মডেলের বর্ণনা দেওয়া হয়েছে, যা একই সঙ্গে ভবিষ্যতের RGB পর্যবেক্ষণ, স্কেলার ফিল্ড ও অ্যাফোর্ড্যান্সের হিটম্যাপ এবং রোবটের অবিচ্ছিন্ন কমান্ড পূর্বাভাস দেয়। অ্যাকশন অ্যানোটেশন ও রিটার্গেটিং ছাড়াই মানুষের ভিডিও ব্যবহার করে এটি পারস্পরিক ক্রিয়ার বৈচিত্র্য বাড়ায়। RoboCasa, CALVIN ABC→D এবং বাস্তব কাজগুলোতে, শুধু RGB ও শুধু রোবটের ডেটার ওপর ভিত্তি করে তৈরি বেসলাইনগুলোর তুলনায় এই পদ্ধতি ধারাবাহিকভাবে ভালো ফল দেয়।
9 নভেম্বর 2026
নিয়ন্ত্রিত অপারেশন হিসেবে প্রেজেন্টেশন সম্পাদনা: EditPPT ফ্রেমওয়ার্ক এবং DeckEdit-Bench বেঞ্চমার্ক
লেখকেরা কোডের অবাধ জেনারেশনের বদলে স্লাইড সম্পাদনাকে নির্দিষ্ট অবজেক্ট, অনুমোদিত কার্যকলাপ এবং বাইরের বিষয়বস্তু অপরিবর্তিত রয়েছে কি না তা যাচাই করার ভিত্তিতে বিশ্লেষণ করেছেন। গুণমান পরিমাপের জন্য তৈরি করা হয়েছে DeckEdit-Bench (মানুষের তৈরি 28টি প্রেজেন্টেশনে 183টি কাজ), আর পাঁচটি বেস মডেলে মাল্টি-এজেন্ট পদ্ধতি EditPPT 97%-এর বেশি বিষয়বস্তু অক্ষত রেখে 66,7–74,9% কাজ সফলভাবে সম্পন্ন করে।
8 নভেম্বর 2026