
Проблема одинакового бюджета экспертов
Разреженно-активируемые MoE-трансформеры фиксируют одинаковое число маршрутизируемых экспертов во всех слоях. Это игнорирует документированную гетерогенность избыточности между слоями.
MAPLE — plug-and-play-фреймворк. Он перераспределяет бюджет маршрутизируемых экспертов между слоями любой предобученной MoE LLM. Метод не меняет веса и не требует переобучения.
Ключевые свойства:
- Гетерогенное распределение бюджета по слоям.
- Отсутствие правки весов модели.
- Отсутствие переобучения.
- Применимость к предобученной MoE LLM.
Практический критерий: подход нужен, когда требуется изменить распределение экспертов без правки весов и переобучения.
Чувствительность слоев и закрытая формула
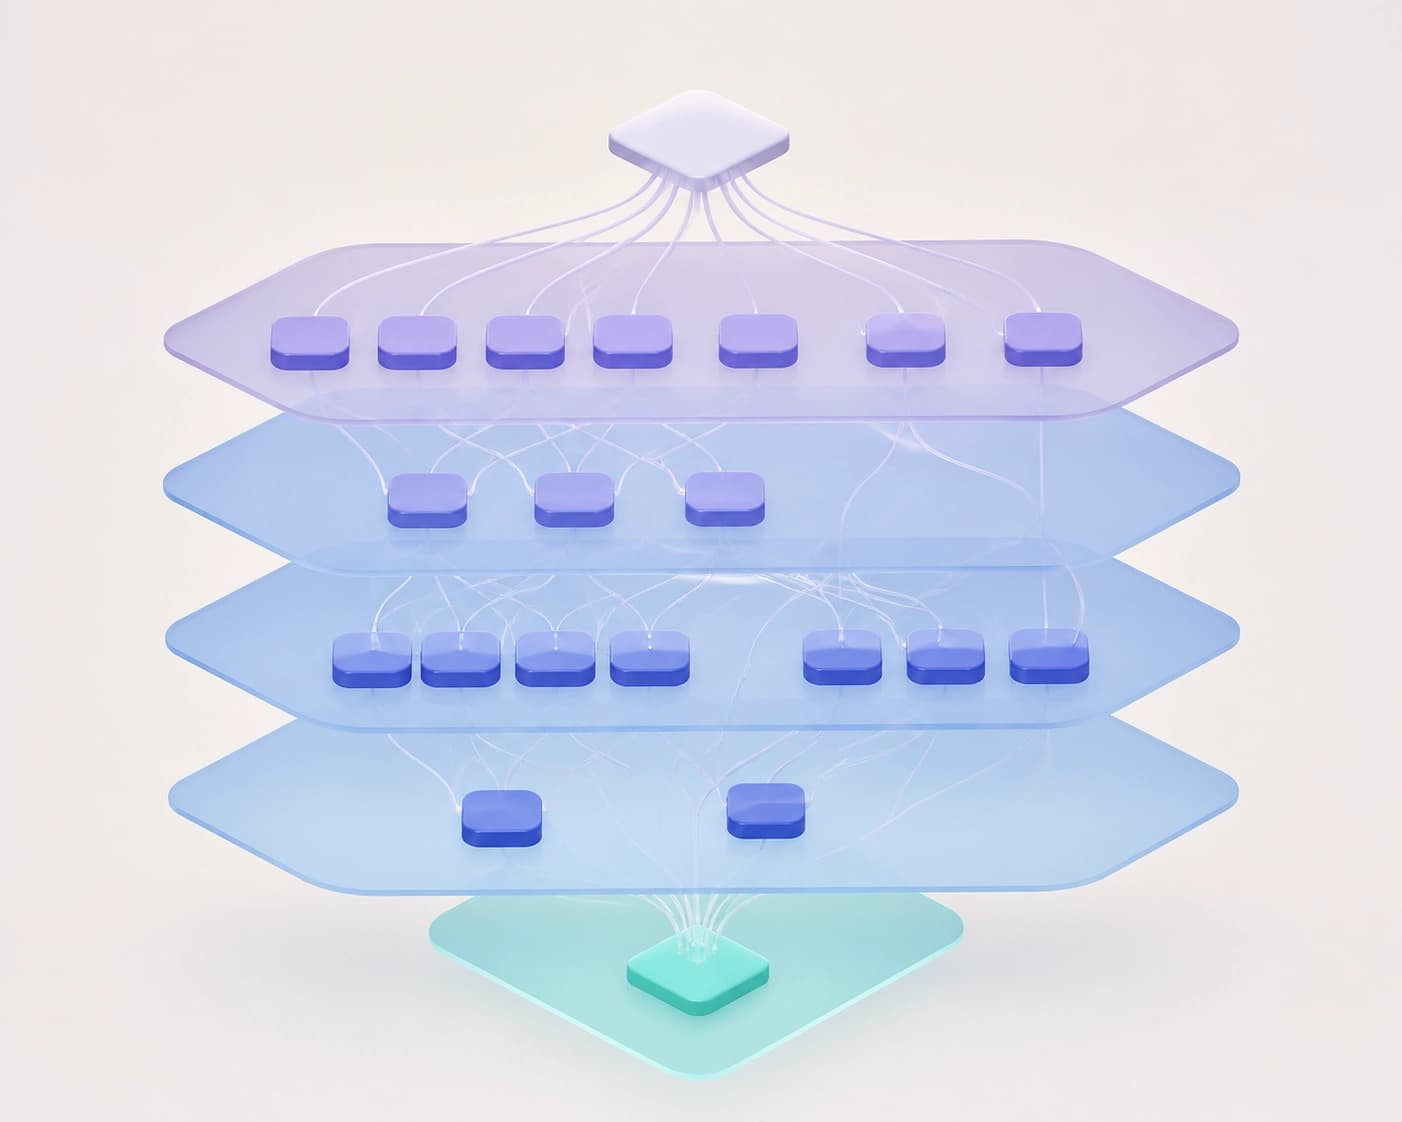
MAPLE зондирует каждый слой. Метод проверяет реакцию слоя на изменение числа экспертов. Чувствительность количественно оценивают тремя мерами.
Этапы переноса бюджета:
- Зондирование каждого слоя.
- Оценка реакции на изменение числа экспертов.
- Количественная оценка чувствительности тремя мерами.
- Вывод аналитически оптимального распределения бюджета.
- Уточнение генетическим поиском с ограничением по чувствительности.
Аналитическое распределение направляет емкость в чувствительные слои. В избыточных слоях сокращение бюджета поглощается. Генетический поиск использует послойную чувствительность как приору. Это дает более быструю сходимость и лучшее качество распределения.
Вывод: перенос бюджета опирается на измеряемую чувствительность, а не на равномерное правило.
Сравнение с равномерным и pruning-подходами
MAPLE превосходит равномерный и pruning-based baselines на четырех MoE-моделях разного масштаба и архитектуры. Сравнение идет при 75% бюджете маршрутизируемых экспертов.
| Вариант | Бюджет маршрутизируемых экспертов | Результат |
|---|---|---|
| Равномерный baseline | 75% | Уступает MAPLE |
| Pruning-based baseline | 75% | Уступает MAPLE |
| MAPLE | 75% | Превосходит оба baseline |
| Равномерный baseline | 100% | Уступает MAPLE с 75% на DeepSeek-MoE-16B по ARC-E, ARC-C и BoolQ |
На DeepSeek-MoE-16B MAPLE использует только 75% экспертов. При этом он обходит исходный 100%-равномерный baseline на ARC-E, ARC-C и BoolQ.
Рост точности:
- ARC-E: с 65,09 до 71,40.
- ARC-C: с 48,49 до 51,50.
- BoolQ: с 80,03 до 82,38.
Вывод: гетерогенное распределение может быть эффективнее простого включения большего числа экспертов.
Эффективность при обслуживании в SGLang
Реализация MAPLE в SGLang снижает end-to-end задержку обслуживания на одной GPU на 32,2%. Пропускная способность растет на 47,4%.
Метод не меняет веса. Поэтому его можно встроить в существующий стек обслуживания MoE. Это делает перенос бюджета практическим рычагом для инференса.
Практический критерий: для single-GPU обслуживания через SGLang метод дает снижение задержки и рост пропускной способности.
Критерии выбора
MAPLE стоит рассматривать в нескольких случаях:
- Нужно сократить бюджет маршрутизируемых экспертов без переобучения.
- Модель — предобученная MoE LLM.
- Требуется учитывать послойную неоднородность, а не равномерное правило.
- Нужно повысить эффективность инференса MoE.
Вывод: гетерогенное распределение экспертов становится принципиальной и практической осью повышения эффективности MoE.


