
Мультимодальные многоагентные LLM в математике: как проверять ход решения и устойчивость к искажениям
Представлен MAMath-Bench — набор из 1003 задач по 11 математическим разделам с текстовыми, графическими и аудиоматериалами; помимо итогового ответа он фиксирует контрольные шаги и реакцию системы на состязательные изменения хода рассуждения. Результаты показывают, что кооперация нескольких LLM не обязательно повышает точность, может усиливать избыточность обоснований, а тонкие структурные возмущения остаются серьёзным источником уязвимости.
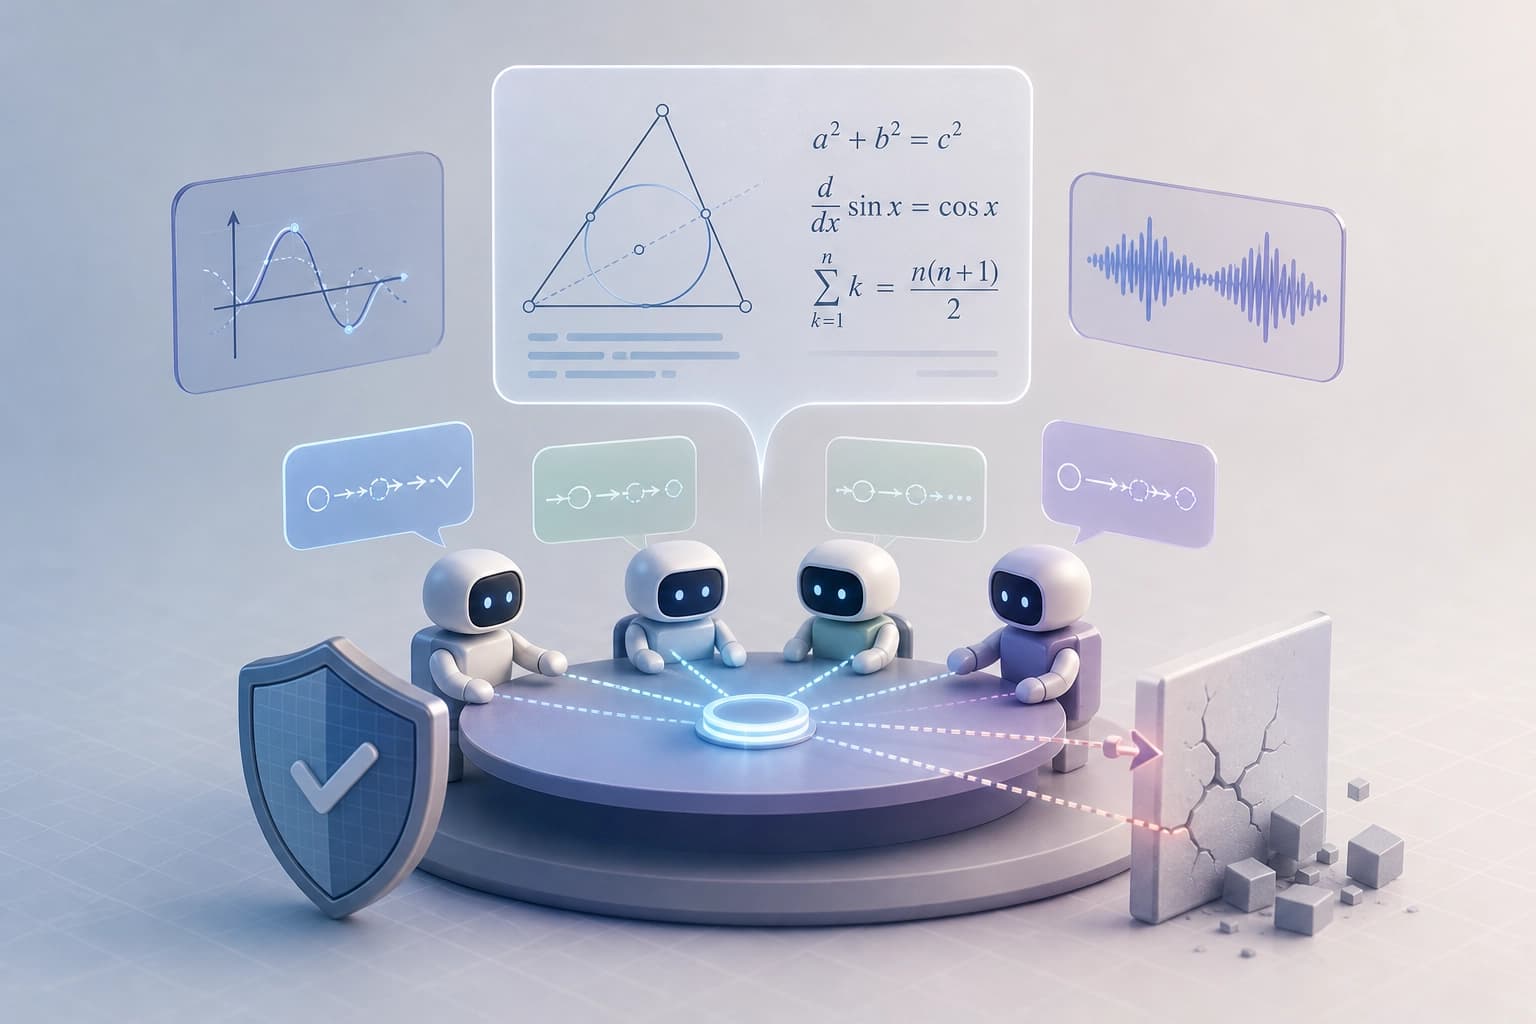
Что оценивает бенчмарк
MAMath-Bench — бенчмарк для оценки мультимодальных математических рассуждений систем с несколькими агентами. Он включает 1 003 задачи из 11 математических категорий. Задачи охватывают несколько уровней сложности и три модальности: текст, изображения и аудио.
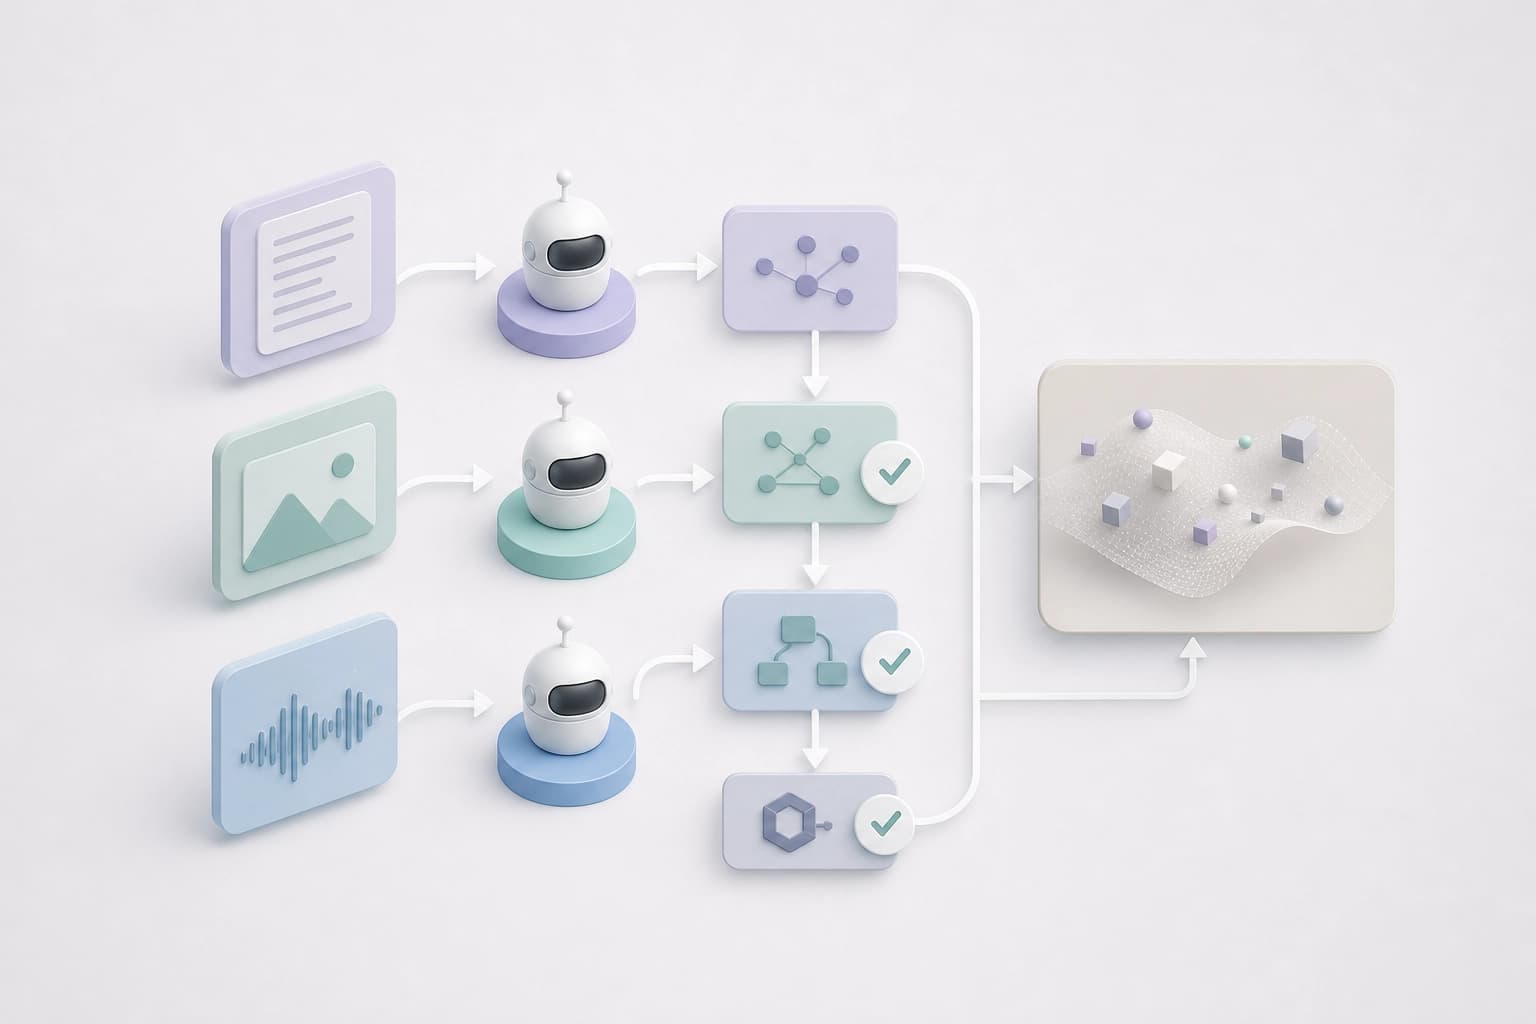
Бенчмарк содержит детальные аннотации контрольных этапов. Оценка идёт по трём измерениям:
- правильность решения задачи;
- надёжность процесса рассуждения;
- устойчивость к состязательным возмущениям цепочки рассуждений.
Практический критерий: выбирать оценку, которая разделяет правильность ответа, надёжность процесса и устойчивость к возмущениям. Финального ответа для такой проверки недостаточно.
Проверка хода решения
Аннотации контрольных этапов дают опору для проверки промежуточных шагов. Оценка надёжности процесса рассуждения отделена от правильности финального ответа. Это позволяет сравнивать системы не только по результату.
Что проверять в ходе решения:
- наличие контрольных этапов, отмеченных в аннотациях;
- соответствие промежуточных шагов этим этапам;
- надёжность процесса рассуждения как отдельное измерение.
Критерий проверки: фиксировать, где именно решение отклоняется от контрольных этапов. Финальный ответ сам по себе не показывает качество хода решения.
Многоагентность: точность, охват и избыточность
Оценка показывает три разных эффекта сотрудничества нескольких агентов. Точность окончательного ответа не всегда растёт по сравнению с сильными одиночными LLM. Охват промежуточных рассуждений может существенно улучшиться. Рост охвата может сопровождаться ростом избыточности рассуждений.
| Что сравнивать | Что показывает оценка | Практический вывод |
|---|---|---|
| Точность окончательного ответа | Сотрудничество нескольких агентов не всегда повышает точность по сравнению с сильными одиночными LLM | Не считать многоагентную схему гарантией правильного ответа |
| Охват промежуточных рассуждений | Сотрудничество может существенно улучшить охват | Сопоставлять выигрыш в охвате с другими измерениями |
| Избыточность рассуждений | Рост охвата может сопровождаться ростом избыточности | Учитывать рост избыточности при оценке охвата |
Критерий выбора: не считать многоагентную схему гарантией точности. Сравнивать её с сильной одиночной LLM по финальному ответу, охвату и избыточности.
Устойчивость к состязательным искажениям
Оценка включает устойчивость к состязательным возмущениям цепочки рассуждений. Современные системы остаются уязвимыми к состязательным ошибкам рассуждения, особенно к связанным с тонкими структурными возмущениями.
Что проверять:
- реакцию системы на состязательные возмущения цепочки рассуждений;
- ошибки рассуждения при тонких структурных возмущениях;
- сохранение надёжности процесса, а не только финального ответа.
Критерий устойчивости: проверять систему на состязательных возмущениях цепочки рассуждений. Устойчивость к ним входит в оценку наряду с правильностью ответа.
Часто задаваемые вопросы
Похожие материалы
Все материалы
Проверяемые задания и дообучение на длинных траекториях: как Navalia усиливает кооперативных LLM-агентов
Работа описывает фреймворк, который на материале корпоративной финансовой отчётности строит вычислительные цепочки с прослеживаемыми свидетельствами, независимо их валидирует и затем применяет для SFT и RL. На базе Qwen3.6-35B-A3B такой конвейер даёт прирост на пяти бенчмарках и, по данным авторов, улучшает связывание свидетельств, применение инструментов и выполнение длинных задач, включая офисные сценарии.
18 ноября 2026
Физический ИИ: границы понятия, инструментарий и трудные места
Монография объёмом 388 страниц собирает в единую рамку определения физического ИИ, его отличия от смежных областей и основные методы — от восприятия и симуляции до управления и координированных многоагентных систем. Из неё можно получить карту исследовательских задач и ограничений, которые мешают перейти от специализированных решений к системам с широкой обобщаемостью.
17 ноября 2026
LLM-агенты на производстве: таксономия, архитектура и ограничения внедрения
Статья систематизирует исследования о применении больших языковых моделей в производственных агентах: выделяет препятствия, уровни возможностей и четырёхслойную архитектуру. Из неё можно понять, какие сценарии жизненного цикла уже рассматриваются и где сохраняются разрывы для надёжного автономного планирования.
17 ноября 2026