
Метод Genesis Steering: активационное управление на данных, использованных при дообучении
Метод выводит вектор управления из контрастных примеров, присутствовавших в данных дообучения, а при их недоступности отбирает вероятные обучающие образцы через membership inference и формирует прокси-набор. Теоретическая часть описывает оптимальное смещение к границе решения и оценку по прокси-данным; эмпирически внутренние данные Tülu-3-8B дают более выраженный эффект, чем внешние наборы, тогда как полезность MIA-прокси на Llama-3.1-8B-Instruct ограничена соотношением сдвигов направления.
Что такое Genesis Steering
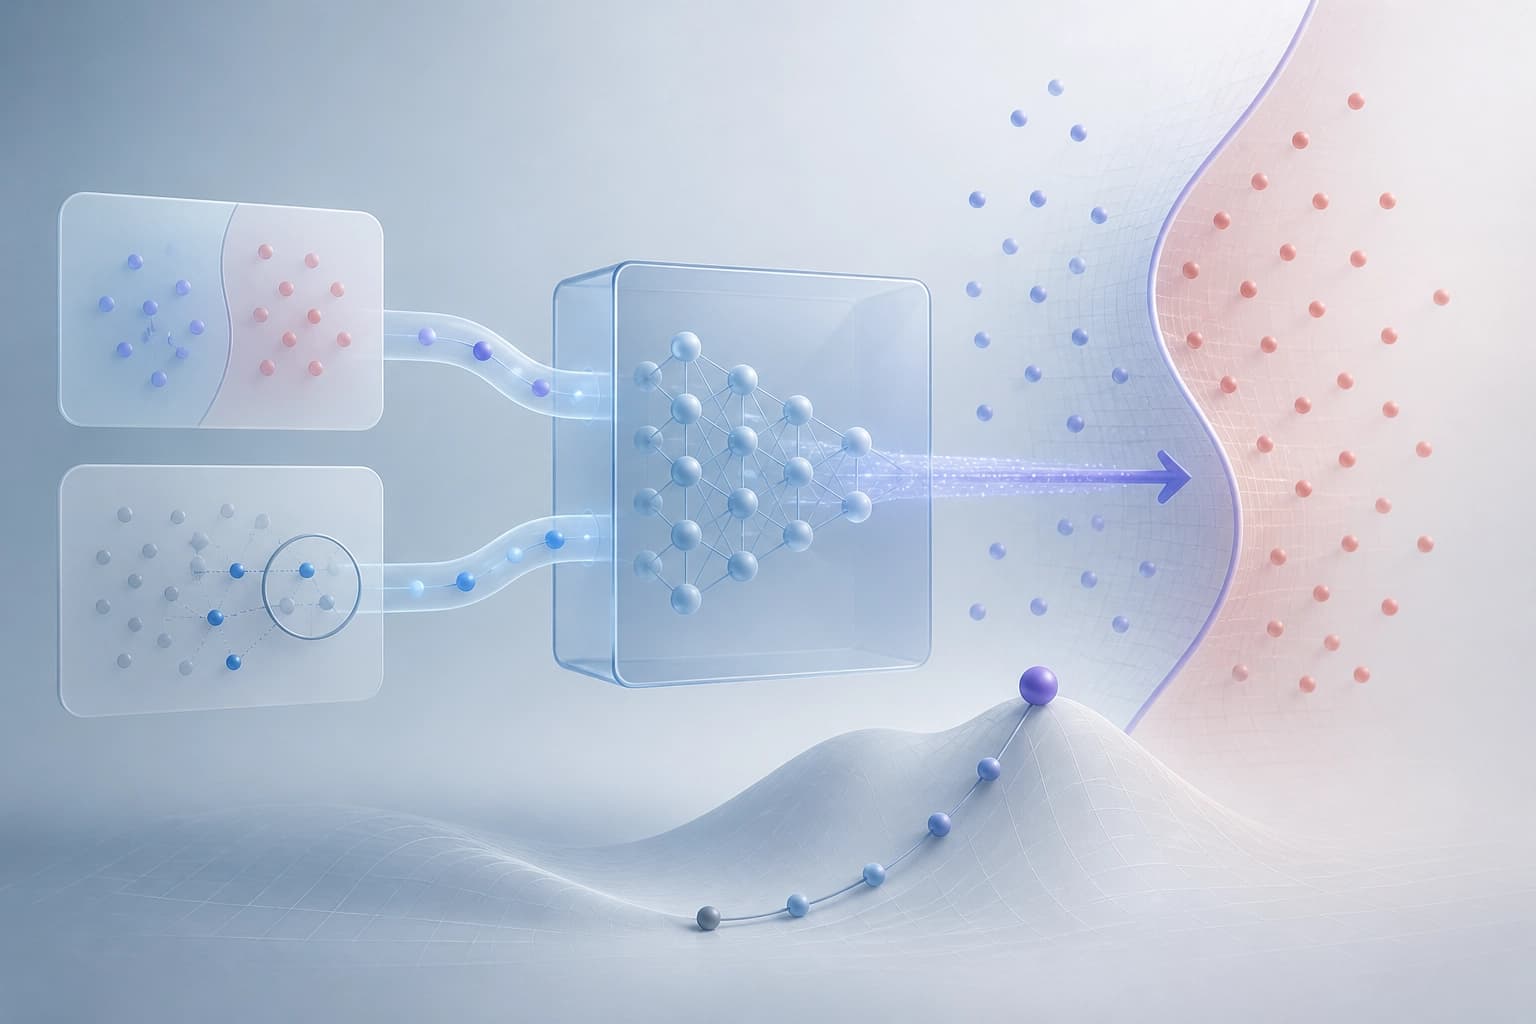
Activation steering управляет большими языковыми моделями во время инференса. Эффективность метода зависит от выбора референсных данных. Genesis steering строит genesis vector на контрастных примерах из собственных данных дообучения модели.
Если эти данные недоступны, метод использует подходы из литературы по membership inference. Подходы находят вероятные обучающие примеры и составляют прокси-датасет.
Статья «Genesis Steering: Better Activation Steering Through Training Data» подана 13 Oct 2026 (v1). Обновление — 19 Oct 2026 (v2). Авторы: Tora Bodin, Eric Aubinais, Ilaria Torre, Chih-Hong Cheng.
Вывод: Genesis steering привязывает steering к данным дообучения. Ключевой параметр — источник контрастных примеров.
Как строится genesis vector
Метод берёт контрастные примеры из данных дообучения. На их основе строится вектор направления. Этот вектор применяют к модели во время инференса.
Авторы устанавливают два теоретических результата. Первый — об оптимальном смещении к границе принятия решения. Второй — о снижении смещения при оценке по прокси-данным.
Вывод: теория задаёт ориентиры для смещения. Качество вектора зависит от выбора контрастных примеров.
Прокси-данные через membership inference
Когда данные дообучения недоступны, метод обращается к membership inference. Этот подход ищет вероятные обучающие примеры. Из найденных примеров составляют прокси-датасет.
Прокси-датасет служит заменой исходных данных при построении genesis vector. Метод использует найденные примеры как референсные. Отличие — источник примеров.
Вывод: прокси-датасет расширяет применимость метода. Критерий применения — отсутствие доступа к данным дообучения.
Что показали оценки на моделях
Оценки провели на Tülu-3-8B и Llama-3.1-8B-Instruct. Для Tülu-3-8B данные дообучения доступны публично. Llama-3.1-8B-Instruct использовали как контрольную модель.
Данные по безопасности из обучающей смеси Tülu-3-8B обеспечили более сильное steering, чем внешние датасеты. Это верно для обеих моделей.
На Tülu-3-8B оценки membership в значительной степени совпадали при определении обучающих примеров. Векторы по примерам с наивысшими оценками дали результаты, сопоставимые со случайными подвыборками того же размера.
Результаты на Llama-3.1-8B-Instruct задают условие для MIA. Метод даст положительный эффект, только если средний сдвиг направления для отфильтрованных MIA внутридоменных данных значительно меньше сдвига для OoD-данных.
Вывод: собственные данные дообучения дают более сильное steering, чем внешние датасеты. MIA требует проверки условия по сдвигу направления.
Практические критерии выбора
Выбор метода зависит от доступа к данным дообучения. Таблица ниже связывает ситуацию, действие и проверку.
| Ситуация | Действие | Проверка |
|---|---|---|
| Данные дообучения доступны | Построение genesis vector на контрастных примерах из этих данных | Сравнение с внешними датасетами |
| Данные недоступны | Поиск вероятных обучающих примеров через membership inference и сбор прокси-датасета | Проверка условия по среднему сдвигу направления |
| Прокси-датасет собран | Построение векторов по примерам с наивысшими оценками | Сравнение со случайными подвыборками того же размера |
Вывод: Genesis steering выбирают по доступности данных дообучения. Для прокси-датасета проверяют условие по сдвигу и сравнивают с случайными подвыборками.
Часто задаваемые вопросы
Похожие материалы
Все материалы
Табличное обучение в контексте на разреженных экспертах: компактная OrionMoE-Small-v1.0
Представлена компактная базовая модель для табличных задач, предсказывающая новые наблюдения по размеченной опорной таблице без дообучения параметров. Адаптивный выбор экспертов с учётом набора данных и признаковых представлений даёт конкурентоспособные результаты, особенно при малом контексте и высокой размерности.
15 ноября 2026
Локальный поиск ковариатных сдвигов для профилей с ненадёжными прогнозами
Статья описывает диагностический конвейер, который сначала выделяет интерпретируемые группы пациентов с пониженной уверенностью модели, а затем проверяет внутри этих групп наличие вредного ковариатного сдвига. В экспериментах на MIMIC-IV с тремя клиническими задачами и тремя искусственными подгрупповыми сдвигами подход помог локализовать возрастной сдвиг, слабо заметный при агрегированной оценке.
15 ноября 2026
FedPix: передача сжатых изображений с клиента для уменьшения утечки в федеративном обучении
Статья рассматривает, какую информацию клиенту разрешать отправлять на сервер, и предлагает обучать передачу компактных визуально проверяемых изображений вместо модельных весов или промежуточных представлений. На BloodMNIST, CIFAR-10, FashionMNIST и MNIST подход показывает низкий PSNR при реконструкции и сокращает клиентское время до 96,0% при точности 65,63–99,18%.
15 ноября 2026