
CaLR:用于扩散模型稳健推理的因果约束潜在优化
这项工作提出了 CaLR,这是一种将推理归结为潜在空间中约束优化的方法;其结构来源于专家模型中的因果拓扑矩阵,训练则基于隐式微分。该方法提升了一致性,并能在并行生成过程中调整中间结果,因此在复杂数据集和具有严格约束的任务(包括数独)上表现更佳。
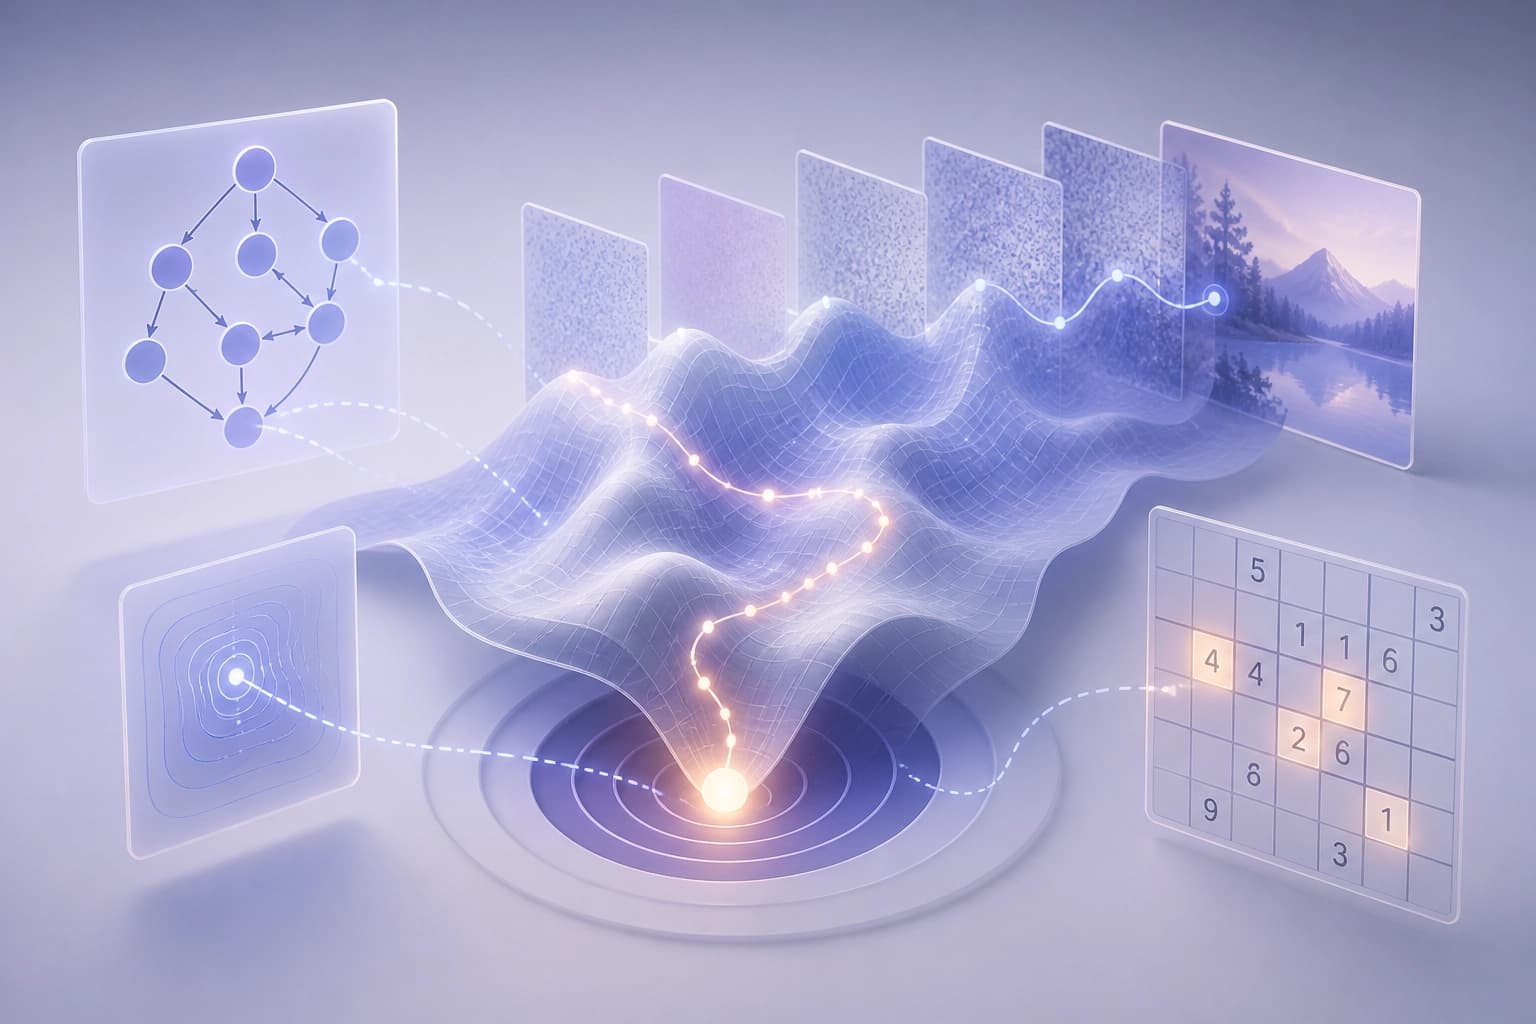
问题:AR 的局部贪心与 DLM 因果性不足
自回归模型容易陷入局部贪心。扩散语言模型往往缺乏用于推理的严格因果结构。
| 模型类型 | 局限性 |
|---|---|
| AR | 局部贪心 |
| DLM | 缺乏用于推理的严格因果结构 |
结论:推理需要一种将生成与因果约束相结合的机制。实践标准:检查模型在中间步骤中如何保持逻辑结构。
框架及其任务
CaLR 是一个用于实现扩散模型稳健推理的框架。它将推理表述为受约束的潜在优化。全称:“CaLR: Causal Latent Revision for Robust Diffusion Reasoning”。作者:Wei Cai, Jian Zhao, Yuchen Yuan, Xuelong Li。提交日期:2026年9月17日。
结论:CaLR 将稳健推理与潜在表示优化相结合。实践标准:如果任务需要推理中的因果结构,就选择该方法。
方法组成部分
CaLR 使用三个要素。第一是因果拓扑矩阵(CTM)。该矩阵由专家模型提供。第二是隐式微分。第三是梯度引导的“思维修订”。
因果拓扑矩阵(CTM)
CTM 是因果拓扑矩阵。它由专家模型提供。
隐式微分
CaLR 使用隐式微分。
梯度引导的“思维修订”
此操作旨在确保逻辑一致性。它还旨在并行生成期间动态自我修正中间步骤。
结论:CTM 提供因果结构,隐式微分参与优化,思维修订则修正步骤。实践标准:检查因果结构的来源和修正机制是否具备。
所声称的结果
CaLR 在复杂基准测试中实现了 DLM 的 SOTA 性能。该框架优于强大的 AR 基线。在 Sudoku 等带约束的任务中,它展现出更强的稳健性。
| 属性 | 结果 |
|---|---|
| DLM 性能 | 在复杂基准测试中达到 SOTA |
| 与 AR 的比较 | 优于强大的 AR 基线 |
| 稳健性 | 在带约束的任务中稳健性更强,例如 Sudoku |
结论:所声称的优势涉及复杂基准测试和带约束的任务。实践标准:根据带约束任务中的稳健性来匹配任务需求。对于其他场景,数据摘要中没有相关信息。
常问问题
相关材料
所有材料
RL 模拟器故障诊断中的规范多项式不变量:它们究竟在何处发挥作用
这项研究检验了将物理定律纳入可训练动力学模型是否合理:从轨迹中提取并通过 Gröbner 基化为规范形式的不变量,虽能小幅提升预测效果,却在诊断方面表现出色——它们能够定位被违反的约束,并找出具体的错误参数。
10 十一月 2026
AURA-Eval:如何验证 LLM 智能体识别了风险并调整了下一步行动
该框架评估 LLM 智能体在关键节点面对风险时的反应,而非最终判断:工具调用轨迹会被中断,随后模型必须继续推理并采取行动,LLM 评审团则分析其风险识别、行动性质与安全性。在从 157 条 R-Judge 轨迹中整理出的 1249 项任务上,对 20 个模型的评估显示,缺少安全路径时,不安全行为会增多;在执行前撤除监督,会使 52.3% 原本安全的案例转为不安全。
10 十一月 2026
陈-西蒙斯储层记忆:连通性的自主动力学与密度输运
本文探讨了储层如何同时在密度分布和几何自由度中保留输入信号的历史。对四种机制的比较表明,电流会形成一个独立的连通分量,改变密度的后续响应;而纳入所有测得的特征,则能在脉冲顺序解码方面带来小幅提升。
10 十一月 2026