
المشكلة: الاختبارات قليلة، والمكافأة عليها كاملة
أصبح التعلم المعزز بالمكافآت القابلة للتحقق (RLVR) الطريقة الرئيسية للارتقاء بالنماذج اللغوية إلى مستوى مقبول في توليد الشيفرة. الفكرة بسيطة: يكتب النموذج حلًا، ويشغّله فحص خاص عبر الاختبارات، وبناءً على النتيجة تُمنح المكافأة للنموذج. كل شيء يقوم على افتراض واحد — أن الاختبارات تصف المهمة فعلًا بالكامل.
على أرض الواقع، هذا الافتراض مُنتقَض في الغالبية العظمى من الحالات. مجموعة حالات الاختبار ضيقة، والتغطية مثقوبة، والنموذج يكتشف بسرعة كبيرة لا المهمة بل الثغرة: يلائم الشيفرة مع الفحوصات المحددة بدلًا من أن يتعلم حل فئة من المهام المتشابهة. ثم تبدأ الحلزونية المألوفة — reward hacking، يتبعه تدهور السياسة. يفقد النموذج من مهاراته العامة بقدر ما ينجح في الحيلة الضيقة.
تشبيه تقريبي: امتحان يتكوّن من سؤالين. الطالب الذي حفظ إجابات هذين السؤالين ينال الدرجة الكاملة، لكنه لا يعرف المادة. وكلما طال هذا التعلم، ازداد سوءًا في كل ما عدا ذلك.
فكرة RobustTests: الأخطاء كمولّد للاختبارات
عادةً تُبتكر الاختبارات انطلاقًا من نص المهمة: ما أنواع المدخلات، وأين حدود النطاقات، وما الذي سيحدث عند إدخال فارغ. منطقي، لكن هذا المسار تحديدًا هو ما ينتج تغطية ضيقة — فمؤلف الاختبارات ومؤلف الحل ينظران إلى المهمة من الجهة نفسها، وكلاهما أعمى بالقدر نفسه عن المواضع نفسها.
RobustTests يقلب العملية رأسًا على عقب. يقوم الإطار على تخليق حالات اختبار موجَّه بالشيفرة المعيبة (faulty-code-driven test case synthesis). والحديث ليس عن شيفرة مكسورة عشوائية، بل عن حلول «شبه صحيحة»: تلك التي تختلف عن الصحيح بتغيير طفيف في المنطق — إشارة مقارنة مقلوبة، حد حلقة خاطئ، فرع مفقود. كل حل من هذا القبيل يعمل تقريبًا، ولهذا بالضبط هو ذو قيمة.
بعد ذلك يُبحث عن مدخل يختلف عنده الكود شبه الصحيح عن المرجعي. المدخل الذي يُعثر عليه يصبح اختبارًا. ولهذا الاختبار قوة تشخيصية عالية: فهو لا «يفحص شيئًا ما» فحسب، بل يميّز بين سلوكين متقاربين — ذاك الذي نريده من النموذج، وذاك الذي يبدو معقولًا لكنه خاطئ.
العمل موصوف في مسودة arXiv:2608.24135 (Yiwen Zhang وثمانية مؤلفين آخرين، من بينهم Xiaodong Yan وZhenyu Huang وDeng Zhao وآخرون؛ v1 — 25 أغسطس 2026، v2 — 27 أغسطس 2026، DOI 10.48550/arXiv.2608.24135، مقبول في EMNLP 2026). يصنّف المؤلفون المادة في قسمين معًا — cs.AI وcs.SE، وهو منطقي: فهي تتعلق بتدريب النماذج وهندسة الاختبار معًا.
الترشيح: وكلاء التحقق والتجميع العنقودي
أي تخليق آلي للاختبارات يتحول بسهولة إلى مولّد نفايات. بعض المدخلات المبتكرة ستكون غير صالحة، وبعضها سيكرر بعضه، وبعضها سيفحص السلوك نفسه من زوايا مختلفة. الإشارة المفيدة من مجموعة كهذه قليلة، والضجيج كثير.
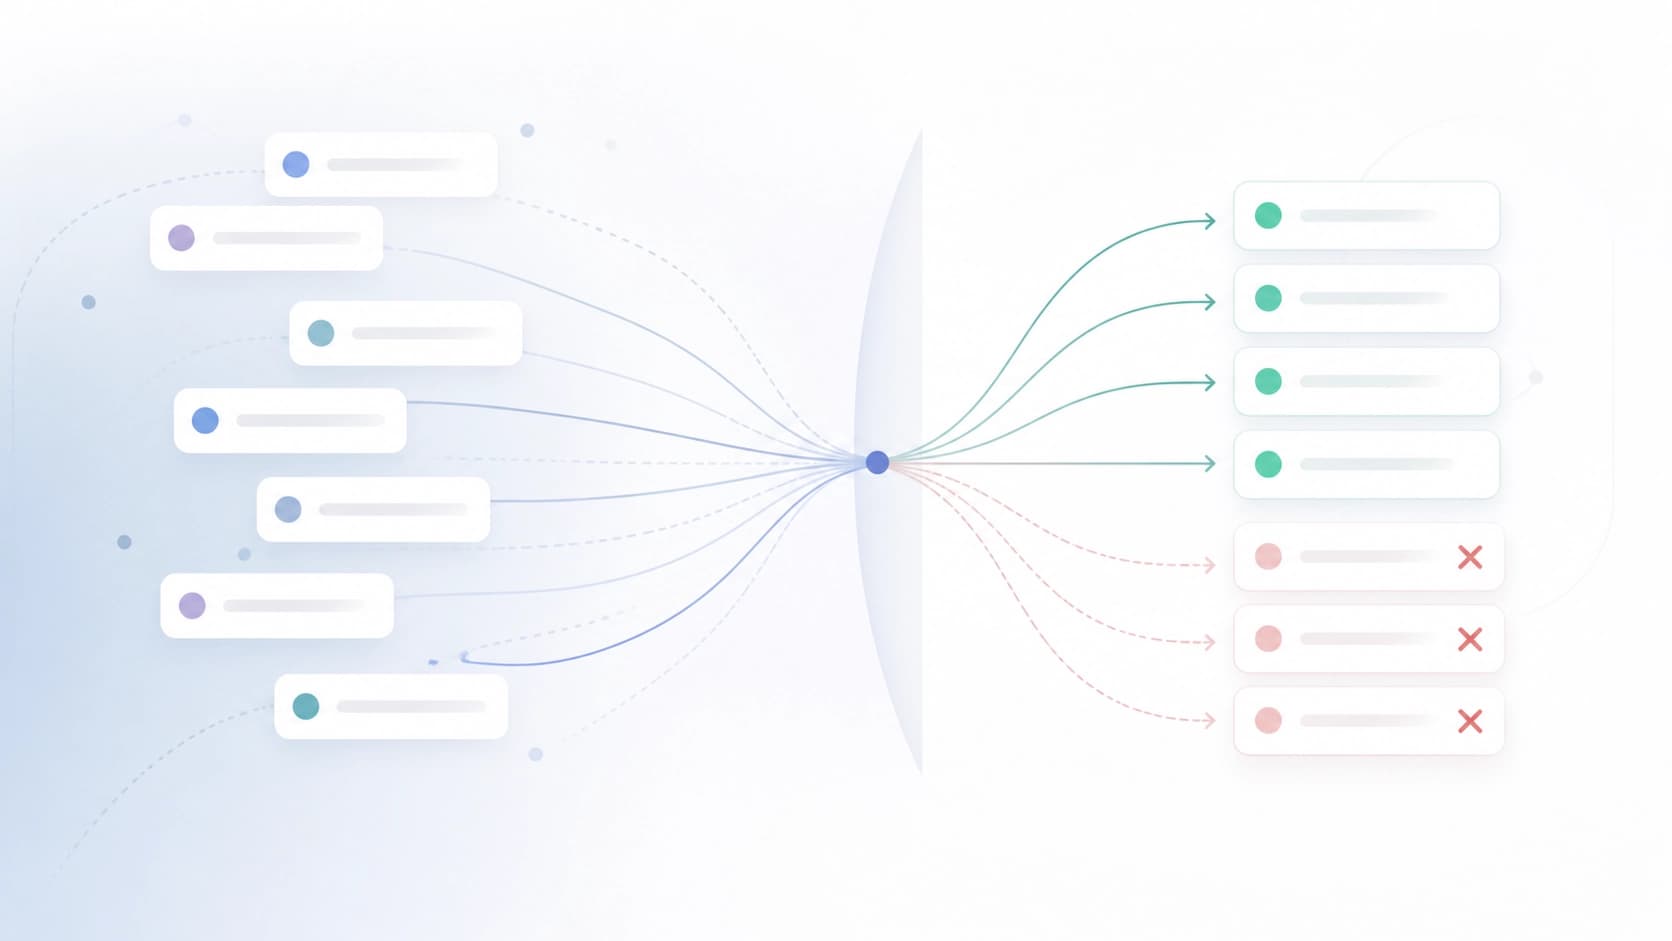
لذلك يتضمن خط المعالجة طبقة ثانية — وكلاء تحقق يغربلون حالات الاختبار غير الصحيحة والزائدة. ويُضاف إليهم تجميع عنقودي حسب السمات السلوكية: تُجمَّع الاختبارات حسب السلوك الذي تميّزه بالضبط، وتُدمج التكرارات داخل المجموعة. في النهاية تبقى مجموعة مدمجة، يضيف فيها كل عنصر معلومة جديدة بدلًا من تكرار جاره.
مكافأة كثيفة بدلًا من إشارة نادرة
المكوّن الثاني للإطار لا يتعلق بالاختبارات، بل بكيفية حساب المكافأة منها. المقاربة الثنائية الكلاسيكية — «نجح كل شيء أو لم ينجح شيء» — تعمل بشكل سيئ عندما تكثر الاختبارات وتتفاوت صعوبتها: يحل النموذج كل شيء تقريبًا، ويتعثر في حالة حدية واحدة، فينال الصفر نفسه الذي يناله حل مكسور تمامًا. تنقطع إشارة التعلم، ولا يبقى تقريبًا ما يُتعلم منه.
يقدّم RobustTests دالة مكافأة كثيفة تدريجية (stepwise dense reward) تستند إلى نسبة الفحوصات المجتازة — pass rate. يحصل النموذج على إشارة جزئية ويفهم اتجاه الحركة: ليس «فشل»، بل «بقي اختباران من ثلاثين». هذا يحل مشكلتين دفعة واحدة. أولًا، يقلل عدد الإيجابيات الكاذبة (false negatives)، حين يُرفض حل صحيح بسبب اختبار صارم أكثر من اللازم أو خاطئ ببساطة. ثانيًا، يجعل التعلم أكثر استقرارًا: تتوقف المكافأة عن كونها حدثًا نادرًا وتتحول إلى مقياس.
يجدر التشديد بشكل منفصل على اقتران هاتين الفكرتين. المكافأة الكثيفة لا معنى لها إلا عندما تميّز الاختبارات فعلًا بين أنواع الأخطاء المختلفة، وإلا فأنت تكتفي بحساب متوسط الضجيج. أما تخليق الاختبارات من حلول شبه صحيحة دون مكافأة كثيفة فسيتركك مع انقطاع الإشارة نفسه. المكوّنان يعملان معًا.
مجموعة البيانات والنتائج
على خط المعالجة هذا جمع المؤلفون نسخة موسّعة من مجموعة بيانات CodeContests+ — بفائدة تشخيصية أعلى بوضوح: أصبحت مجموعات الاختبار تشير بدقة أكبر إلى الخطوة التي يخطئ فيها النموذج بالضبط.
القياس الأهم ليس حجم مجموعة البيانات، بل سلوك النموذج بعد الضبط الدقيق. تدريب RL لـ Qwen3-32B باستخدام RobustTests يعطي زيادة مطلقة بنسبة 3% على LiveCodeBench. وقد نشر المؤلفون الشيفرة والبيانات في الوصول المفتوح.
يجدر هنا التزام الموضوعية. ثلاث نقاط مئوية على معيار واحد عند ضبط دقيق لنموذج واحد — هذا ليس انقلابًا في المجال، بل تحسين متقن بآلية واضحة. تكمن قيمة العمل بالأحرى في المنهجية: فهي تقدّم وصفة قابلة للتكرار لاستخلاص إشارة أكبر من الاختبارات دون توسيعها يدويًا. والقيود واضحة أيضًا — نقل النتيجة إلى نماذج ولغات وأنواع مهام أخرى لا يزال بحاجة إلى التحقق.
ما الذي يستحق أن تأخذه إلى ممارستك
حتى إن كنت لا تبني خط تعلم معزز وتكتفي بتقييم جودة توليد الشيفرة، فإن المنطق ينتقل دون تغيير تقريبًا:
- اكتب الاختبارات انطلاقًا من الأخطاء، لا من نص المهمة فقط. خذ حلًا يعمل تقريبًا وابحث عن مدخل ينكسر عنده. اختبار كهذا أكثر إفادة في الغالب من عشرة اختبارات مبتكرة «مباشرة».
- احسب نسبة الفحوصات المجتازة، لا مجرد حقيقة الاجتياز. الدرجة الجزئية تمنح تدرجًا في التعلم وفي تحليل الجودة معًا — فيظهر أين يفشل النموذج بالضبط.
- رشّح الاختبارات المخلّقة. بدون تحقق وإزالة تكرار، تتحول المجموعة المولّدة آليًا بسرعة إلى مكبّ لفحوصات متشابهة.
- راقب ما الذي تشجّعه المكافأة فعليًا. المقياس الكثيف يقلل الميل إلى الطرق الالتفافية، لكنه لا يلغيه: إذا لم تميّز الاختبارات السلوك، فستُخترق أي مكافأة عاجلًا أو آجلًا.
الفكرة التي يحملها RobustTests بسيطة إنسانيًا: أفضل مصدر للاختبارات الصعبة ليس خيال المؤلف، بل أخطاء النظام شبه-المرتكبة. ما كاد النموذج يفعله بشكل صحيح هو المؤشر الأصدق على الحد الفاصل بين «يشبه الحل» و«الحل».


