
بيانات خام بدلًا من جداول جاهزة
تؤدي النماذج دور وكلاء برمجيين على نحو متزايد: يُوكل إليها كتابة نصوص برمجية لمعالجة البيانات، وبناء الرسوم البيانية، وحساب المقاييس، وتحليل المخرجات الهندسية. لكن هناك فئة من المهام لم تُختبر إلا قليلًا حتى الآن — التعامل مع «المواد الخام» على المستوى الفيزيائي. وهذه الفجوة تحديدًا يسدّها معيار EMRB (Electromagnetic Reasoning Benchmark)، الموصوف في المسودة الأولية arXiv:2608.24086 (أقسام cs.AI وcs.CE وcs.SE).
الفكرة الجوهرية بسيطة، ولهذا فهي مقنعة. المدخلات ليست سوى تسجيلات I/Q خام، أي عينات تربيعية للإشارة كما تصل من المستقبل. لا سمات مُعالجة مسبقًا، ولا مخططات طيفية موسومة، وبالتأكيد لا جداول بقيم جاهزة. على النموذج أولًا أن يكتشف المقدار الذي يتعلق به السؤال في البيانات — عبر نص برمجي يكتبه ويشغّله بنفسه.
كيف يختلف هذا عن القياسات المعتادة
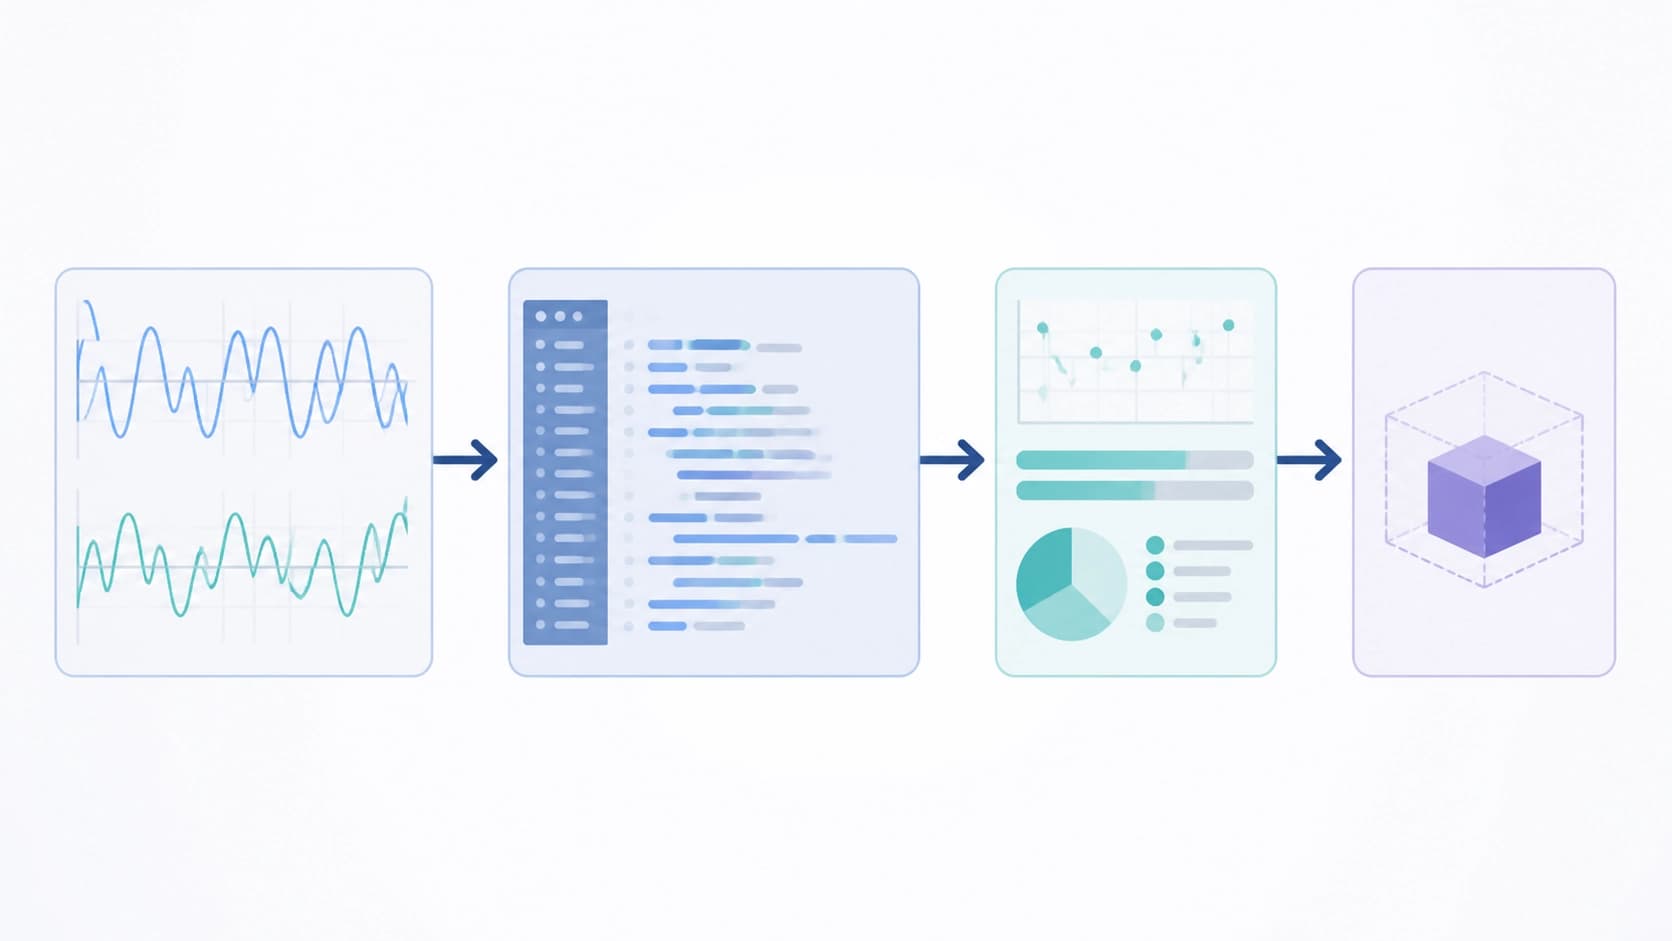
ظهرت في السنوات الأخيرة مجموعات مهام كثيرة يُطلب فيها من النماذج التفكير في الإشارات الراديوية. لكن العمل غالبًا ما يكون منجزًا مسبقًا بدلًا عنها: استُخرجت السمات من التسجيل، وحُسب الطيف، وقُدّر مستوى الضوضاء، وجُمّع كل ذلك في جدول منظّم. في هذه الصيغة لا يبقى سوى الحساب ومقارنة الأرقام — مهارات مفيدة، لكنها لا علاقة لها بالفيزياء الراديوية.
الفرق جوهري. عندما تكون المقادير معطاة مسبقًا، لا يظهر خطأ النموذج في الخطوة المبكرة: فالتقدير الخاطئ للنطاق الترددي أو التردد لا ينشأ أصلًا، لأن هذه القيم مُعطاة في نص المسألة. أما عندما تكون البيانات غير معالجة، فإن أي خطأ في مرحلة استكشاف الإشارة يجرّ معه الحساب كله لاحقًا. لذلك لا يختبر EMRB معرفة المصطلحات، بل القدرة على بناء سلسلة متكاملة: النظر إلى العينات، وفهم نوع الإشارة، واستخلاص الخاصية المطلوبة، وحسابها بشكل صحيح، وعدم فقدان الأبعاد.
كيف صُمّم المعيار
جمع المؤلفون — Mingxu Zhang وYing Sun وYuhan Li وYang Ji وDazhong Shen وKe Zhang وShan Huang — 200 مهمة. وُزّعت المهام على خمسة مستويات صعوبة و27 نوعًا من الأسئلة: من الكشف البديهي عن الإشارة إلى تصميم نظام OFDM. ومصدر المادة 11 نوعًا من الإشارات، أُعدّ لكل منها مرجع صحيح موثّق.
خمسة مستويات
رُتّبت المستويات تصاعديًا وفق استقلالية النموذج. في الأسفل قياسات المعاملات الأساسية: العثور على الإشارة وتقدير خصائصها. وفي الأعلى التفسير والمقارنة، ثم التحليل متعدد الخطوات، ثم التشخيص، وأخيرًا التصميم المنظومي، حيث يُطلب من النموذج ألا يقيس بل يصمّم حلًا وفق متطلبات محددة.
27 نوعًا من الأسئلة و11 نوعًا من الإشارات
هذا التنوع ضروري كي لا تعتمد النتيجة على صياغة موفقة أو سيئة واحدة. أنواع الإشارات المختلفة تضع فخاخًا مختلفة: ففي موضع يعيق الضوضاء، وفي آخر يعيق التداخل الطيفي، وفي ثالث يجب التعامل بحذر مع التكميم. ويشكّل عدد أنواع الأسئلة والإشارات معًا فضاءً يصعب فيه التخمين العشوائي.
بيانات مفتوحة
نُشرت جميع المواد والنصوص البرمجية في مستودع GitHub عام، بحيث يمكن التحقق من النتيجة بشكل مستقل. وهذا أهم من المعتاد بالنسبة لمعيار كهذا: فإذا كانت المهام مولّدة بدلًا من جمعها يدويًا من تسجيلات ميدانية، يصبح سؤال صحة المراجع مسألة مركزية — والانفتاح هنا هو الجواب الوحيد الفعّال.
ما أظهرته النماذج
اختُبرت 14 نموذجًا لغويًا: نماذج مملوكة، وأخرى مفتوحة الأوزان، ونماذج موجّهة للاستدلال بشكل منفصل. وتراوحت النتيجة الإجمالية بين 24.1% و78.9%. هذا النطاق وحده يقول الكثير: الفرق بين أفضل نموذج وأسوئه هنا يُقاس بالأضعاف لا بالنسب المئوية.
لكن الأكثر إثارة للاهتمام شيء آخر. تنهار النتيجة المتوسطة بحدّة مع تصاعد مستوى الصعوبة: من 84.9% في القياسات الأساسية إلى 21.2% في التصميم المنظومي. أي أن النماذج تبلي بلاءً حسنًا عندما يتعين حساب مقدار قابل للقياس، وتنهار تقريبًا عندما يُطلب منها تجميع حل عامل من هذه المقادير.
ينبغي قراءة هذا كتشخيص لا كتصنيف. نقطة قوة النماذج الحالية هي تنفيذ النصوص البرمجية والحساب فوق صيغة معروفة. ونقطة ضعفها هي ترجمة مهمة هندسية إلى لغة خطوات قابلة للقياس: فهم المقادير المطلوبة أصلًا، وبأي ترتيب يُبحث عنها، وكيف يُتحقق من أن ما وُجد يشبه الصواب فعلًا. وهذه الفجوة تحديدًا هي ما يجعل المعيار مفيدًا.
ReconPilot: استكشاف، تحليل، تحقق
لم يكتفِ المؤلفون بالقياس. فقد اقترحوا ReconPilot — نهجًا منظّمًا تُقسَّم فيه المهمة إلى ثلاث مراحل: استكشاف الإشارة، والتحليل الموجّه، والتحقق الذاتي. أولًا يدرس النموذج التسجيل ويكوّن تصورًا عمّا يتعامل معه. ثم يحل المهمة المحددة. ثم يعود إلى نتيجته ويتحقق من اتساقها.
وعلى ثلاثة نماذج أساسية، يضيف الأسلوب إلى النتيجة الإجمالية ما بين 3.8 و17.6 نقطة. وتحقق التحسن في 13 من أصل 15 تركيبة مُختبرة من «العمود الفقري + المستوى». انتبه إلى الصياغة: المكسب غير متساوٍ، وفي حالتين لا يوجد إطلاقًا. وهذه علامة طبيعية على تجربة نزيهة — لم يُوجد حل سحري شامل، لكن الاتجاه مستقر.
والدلالة أن ما يساعد فعلًا هو الفصل الصريح بين المراحل. فالنموذج الذي يُطلب منه ببساطة «تحليل الإشارة» يميل إلى القفز مباشرة إلى الحسابات دون التأكد من فهمه للبيانات. أما الاستكشاف كخطوة إلزامية منفصلة فيفرض عليه أن ينظر أولًا ثم يحسب.
ما الذي يترتب على ذلك
بالنسبة للممارسة الهندسية، الاستنتاج مباشر إلى حد كبير: قبل الوثوق بوكيل في إجراء حسابات على قياسات حقيقية، يجدر اختباره على بيانات بلا تلميحات. فواجهة مريحة وإجابة سلسة في المحادثة لا تقولان شيئًا عن مدى صمود النموذج أمام مخرجات غير مهيأة من المستقبل.
وهناك فكرة أعم تتجاوز حدود الراديو. في أي مجال يستند فيه الاستدلال إلى قياسات خام — الصوتيات المائية، والاهتزازات، والقياس عن بُعد — يجب أن يكون الوكيل قادرًا أولًا على إيجاد المقدار في البيانات، ثم العمل به. وجداول السمات تخفي هذا الجزء من العمل، وتخفي معه الأخطاء.
القيود وما التالي
لا يمكن وصف المسألة بأنها مغلقة تمامًا. فـ200 مهمة حجم معقول، لكنه ليس بلا حدود، والتوليد انطلاقًا من 11 نوعًا من الإشارات يعني أن التسجيلات الميدانية الحقيقية بكل تشوهاتها غير ممثلة فيه. وتقييم 14 نموذجًا هو لقطة لحظية لا حكم نهائي: فتشكيلة المتصدرين في هذا المجال تتغير بسرعة.
ومع ذلك تبدو صياغة المهمة سليمة. إذا أردنا أن تعمل النماذج اللغوية الكبيرة مع البيانات نفسها لا مع إعادة سردها، فعلينا اختبارها تحديدًا حيث تنتهي التلميحات. وهذا بالضبط ما يفعله EMRB — ويُظهر أن مجال النمو في استكشاف الإشارة لدى النماذج لا يزال واسعًا جدًا.


