
القاضي الذي يسهل تصديقه أكثر من اللازم
في كثير من الأحيان، تؤدي النماذج متعددة الوسائط دور الحكّم: تنظر إلى صورة أو فيديو أو تستمع إلى صوت، ثم تصدر حكمها — هل تتوافق النتيجة مع الطلب النصي أم لا. ويُستخدم هؤلاء الحكّام «الذين يأكلون كل شيء» في تقييم الأنظمة التوليدية، وفي الوسم التلقائي للبيانات عندما لا يكفي الخبراء البشريون لتغطية كل شيء.
المنطق واضح: إذا كانت النموذج قادرًا على فهم عدة وسائط دفعة واحدة، فلماذا لا نوكّل إليه التحقق من text-to-image وtext-to-video وtext-to-speech؟ لكن هنا يكمن سؤال غير مريح. فالدقة الإجمالية الجيدة لمثل هذا الحكّم لا تعني بالضرورة أنه يرى فعلًا ما يقيّمه. فمجموعات الاختبار ومجموعات التدريب الحالية عادةً ما تكون منحازة نحو الأمثلة الناجحة، كما أن أنواع الإخفاق المختلفة مركومة فيها معًا في كومة واحدة.
والنتيجة هي صورة مشوّهة. يُظهر الحكّم أرقامًا محترمة لأنه تعلّم أن يقول «نعم»، بينما تبقى نقاطه العمياء الحقيقية دون أن يلاحظها أحد. وهذه المشكلة بالتحديد هي ما يتناولها عمل جديد من arXiv.
ما الذي يقترحه المؤلفون: D3-Omni
صدر البحث تحت عنوان بناه المؤلفون أنفسهم على التضاد: «OmniJudge or OmniBias?». فبدلًا من تصنيف آخر للترتيب، جمعوا أداة تشخيصية — D3-Omni، وهو معيار مُصمَّم بحيث لا يسمح للحكّم بالاختباء خلف الإحصاءات العامة. ويتكوّن الاسم من ثلاثة مبادئ، وكل مبدأ منها يضرب ضعفًا محددًا في الاختبارات المعتادة.
Dual-balanced: إزالة الانحياز نحو «كل شيء على ما يرام»
المبدأ الأول مسؤول عن التوازن. فبدلًا من جمع الأمثلة كيفما اتفق، تُوازَن المجموعة: يجب أن يكون لكل خاصية مُختبَرة عدد متقارب من الحالات الناجحة والفاشلة. وهكذا تختفي الحالة التي يجمع فيها النموذج نقاطًا لمجرد أن الإجابة الصحيحة هي «نعم» في أغلب الأحيان.
Decoupled: خطأ واحد — سبب واحد
المبدأ الثاني هو الفصل. فكل عيب في الاختبار مرتبط بقدرة واحدة بالضبط. وإذا أخطأ الحكّم، يصبح واضحًا ما الذي نقصه تحديدًا: فهم التكوين، أو اللون، أو تزامن الصوت، أو شيء آخر. لا أمثلة مركّبة لا يُعرف فيها أي من الانتهاكات الثلاثة هو الذي أربك النموذج.
Dynamic: الاختبار يتكيّف مع تقدّم النماذج التوليدية
المبدأ الثالث هو الديناميكية. يُوجَّه تصميم الاختبار نحو المجالات التي لا تكفي فيها تمثيلات الأمثلة بعد، مع تعلّم النماذج التوليدية مجالات جديدة. والهدف هو الحفاظ على تكافؤ يقارب واحدًا إلى واحد في كل خاصية، وتوزيع متساوٍ على جميع مستويات الدرجة النهائية.
كيف تتكوّن مجموعة البيانات
حجم D3-Omni معتبر: 53 خاصية ثنائية موزّعة على ثلاث مهام (17 و22 و14 لكل مهمة)، و10,671 مثالًا (3,526 و1,998 و5,147 على التوالي). وقد اختيرت الخصائص بشكل متعامد — فهي لا تكرّر بعضها بعضًا.
وثمة تفصيل هندسي منفصل — كيف تُستخرج الأمثلة السلبية. فقد رفض المؤلفون من حيث المبدأ إعادة توليد المخرجات: فهذا المسار يؤدي إلى تسرّب المعلومات بين الخصائص، ويفقد الاختبار نقاءه. وبدلًا من ذلك يأخذون «بذورًا» إيجابية بالكامل ومتحقَّقًا منها، ثم يُدخلون الانتهاكات بشكل مضبوط — بإعادة كتابة الطلب النصي وإضافة اضطرابات دقيقة تعزل خاصية واحدة.
ما الذي اتضح: الحكّام يمدحون بثقة ويصطادون العيوب بضعف
أكثر ما يثير الاهتمام في العمل ليس بنية المعيار، بل ما أظهره. فحتى الحكّام متعددو الوسائط الأقوياء يتعثرون في الخصائص المرتبطة مباشرة بالوسيط. وبعبارة أبسط، ما يصعب عليهم هو بالتحديد ما يُستدعون من أجله كمقيّمين.
والملاحظة الثانية أكثر إزعاجًا. فالنماذج تؤكّد المتطلبات المنجزة بموثوقية أكبر بكثير مما تكتشف المتطلبات المنتهَكة. والتباين مستقر: فقول «هنا كل شيء مطابق للطلب» أسهل بكثير على الحكّم من التقاط عدم تطابق محدد.
والثالث — أن النموذج يميل إلى إدراك سمات مختلفة اسميًا كقرار واحد متكامل. فتتلاشى الفروق بين الخصائص، ويصدر الحكّم حكمًا معمّمًا بدلًا من التحليل بندًا بندًا.
لماذا تخدع النسبة المجمّعة
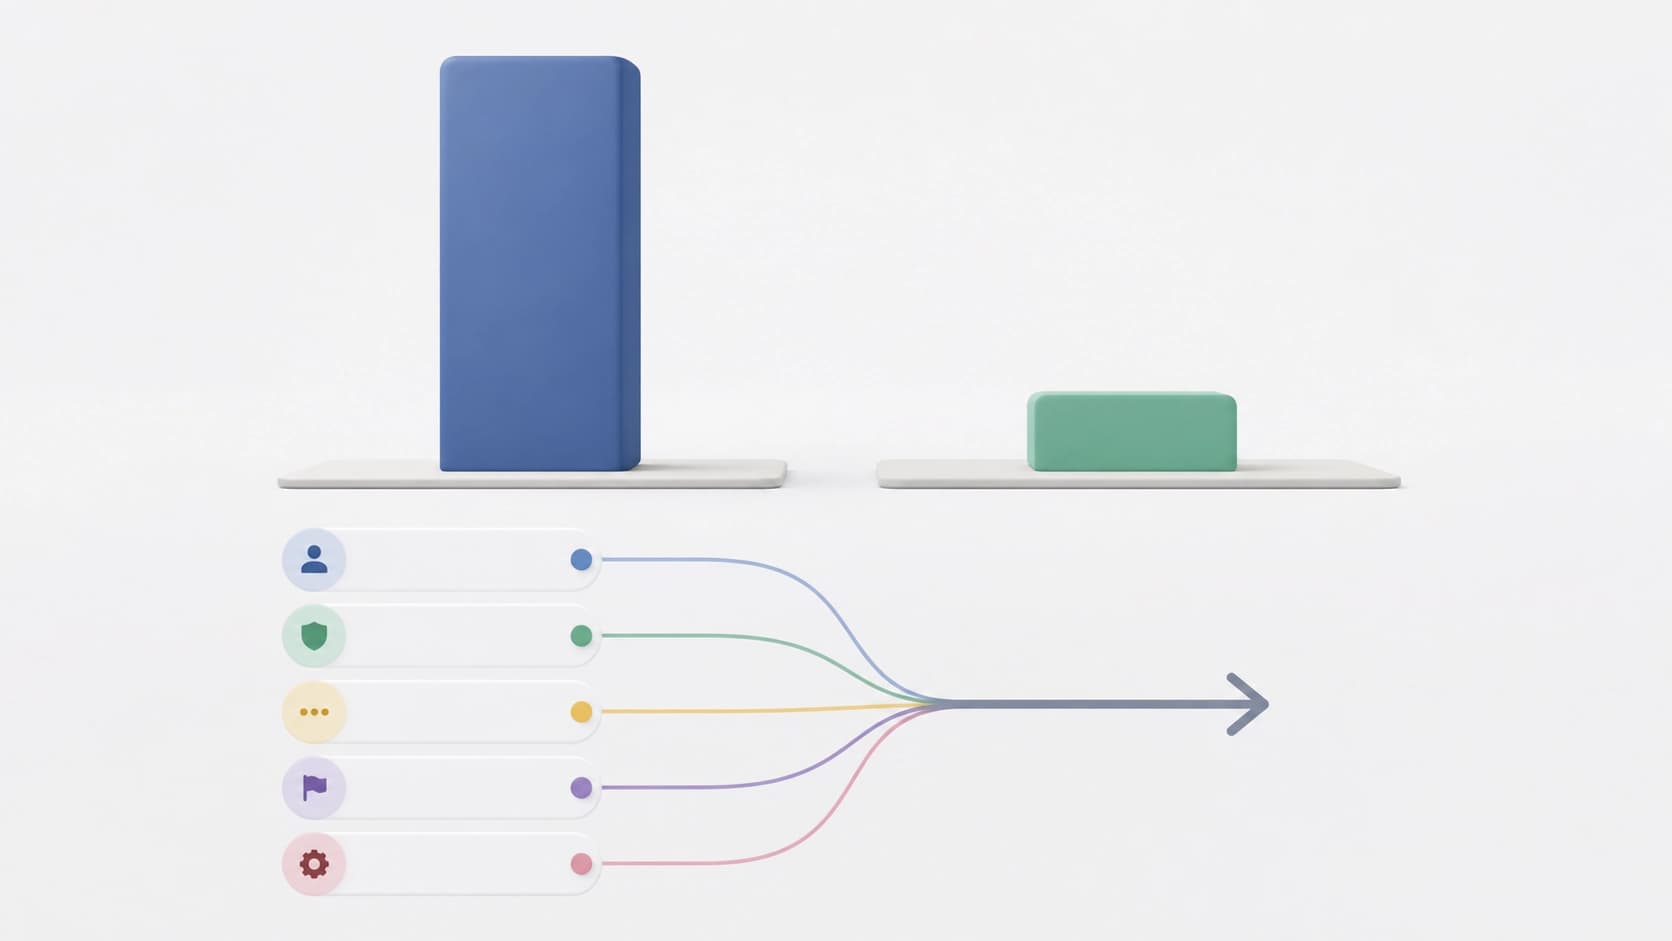
من هذه الملاحظات يتشكّل الاستنتاج الرئيسي: الدقة النهائية قد تخفي نقاطًا عمياء منهجية. فالحكّم الذي يخمّن الإجابة «الإيجابية» بثبات سيبدو محترمًا على مجموعة منحازة — وسيفشل حيث يلزم التقاط خطأ المولّد.
والرؤية المتوازنة والمفصولة ليست مطلوبة لجمال المقياس، بل لكي تصبح هذه النقاط مرئية أصلًا. وبعد رؤيتها — يمكن سدّها بشكل موجّه: بالتدريب الإضافي على الخصائص الإشكالية، بدلًا من السعي وراء المعدل المتوسط.
وعمليًا، هذا يعني شيئًا بسيطًا. إذا كنت تبني خط معالجة يفلتر فيه نموذج حكّم نتائج التوليد أو يوسم مجموعة بيانات، فعليك اختباره على مجموعة منحازة نحو السلبيات، لا على عيّنة مريحة من الأمثلة الناجحة. وإلا فسيمرّر المقيّم العيوب، وستعرف بذلك من المستخدمين لا من المقاييس.
باختصار
- D3-Omni معيار لتشخيص الحكّام متعددي الوسائط، لا تصنيف للنماذج.
- ثلاثة مبادئ: توازن الأمثلة الإيجابية والسلبية، وربط كل خطأ بقدرة واحدة، وتكييف الاختبار مع تطوّر النماذج التوليدية.
- 53 خاصية ونحو 11 ألف مثال على مهام text-to-image وtext-to-video وtext-to-speech.
- تُنشأ السلبيات بإعادة كتابة الطلبات النصية واضطرابات دقيقة، لا بإعادة التوليد — حتى لا تختلط الخصائص.
- الاستنتاج الرئيسي: النتيجة المتوسطة العالية قد تخفي نقاطًا عمياء مستقرة، خصوصًا حيث يلزم ملاحظة الانتهاك لا تأكيد المطابقة.


